主题
第 14 章:开源生态与架构演进
:::
阅读建议:如果时间有限,聚焦每节的架构演进逻辑和选型结论,即可把握从 CLI 到后台服务的演进路径;Webhook 网关代码、框架对比表的技术细节适合选型落地时回读。
:::
在前十三章中,我们完成了从单进程 CLI Agent 到事件驱动后台服务的完整闭环。但当 Agent 从开发者的笔记本走向 500 人团队的日常运维,瓶颈往往不在 循环 本身,而在业务隔离、安全风控、成本调度与多端接入这四条并行的演进轴线上。
试想把 go-coder 部署给一家 500 人的互联网公司:运维团队要做数据库迁移 Agent,却发现循环逻辑里写死了代码重构的 Prompt;安全团队要求拦截 rm -rf 类操作;财务团队希望简单任务走廉价模型;产品经理则坚持通过飞书或 Slack @机器人 下发任务。面对这些诉求,Agent 引擎必须进一步抽象为可复用中间件,并接入业务路由与异步通讯网关。以下各节从业务隔离、安全风控、成本调度、多端接入出发,逐步扩展到个性化记忆、分布式部署、多模态演进与图编排等方向。
14.1 业务隔离与智能体驾驭框架
如果将底层的 Agent Loop 比作引擎,那么不同的业务场景(如代码审查、数据库巡检、文案生成)就是这台引擎上的不同车厢。当业务团队数量激增时,如何避免每个团队都复制并魔改底层循环代码?智能体驾驭框架机制的目标,是把核心引擎与业务逻辑彻底解耦,从而支持企业内部的跨团队复用。
14.1.1 引擎与业务的解耦需求
在 CLI 模式下,状态机、重试逻辑和业务 Prompt 经常被硬编码在 main.go 或 RunLoop 中。如果运维团队想基于同一套底层代码开发“云资源巡检 Agent”,他们就不得不把整个引擎复制一份。这种“面条式耦合”会导致极高的维护成本。
因此,业界的通行做法是将“怎么运行(Engine)”与“运行什么”彻底解耦。底层仅提供纯粹的状态机流转、Tool 调度和上下文压缩,业务方只需像插拔积木一样,通过注册 Middleware(中间件)和 Skill 来注入业务逻辑。
14.1.2 智能体驾驭框架的 Go 接口抽象
智能体驾驭框架的核心是一个支持生命周期钩子的结构体。我们可以借用 Go Web 框架(如 Gin)的中间件思想,设计如下架构。其中 Harness 是承载引擎与业务的容器(类似 Web 框架的 App),RunLoopEngine 则是对第六章 RunLoop 状态机的封装,只暴露执行接口而隐藏循环细节:
go
// 拦截器:可以在 Agent 执行的不同阶段注入逻辑
type Middleware interface {
    BeforeLLMRequest(ctx context.Context, agentCtx *AgentContext) error
    AfterLLMResponse(ctx context.Context, response *ChatResponse) error
    BeforeToolExecute(ctx context.Context, toolName string, args []byte) error
}

// Harness:承载引擎与业务的容器
type Harness struct {
    engine      *RunLoopEngine
    middlewares []Middleware
    tools       map[string]Tool
}

func (h *Harness) Use(m Middleware) {
    h.middlewares = append(h.middlewares, m)
}

func (h *Harness) RegisterTool(t Tool) {
    h.tools[t.Name()] = t
}
有了这套 Harness,运维团队可以毫无负担地注入 DatadogPlugin,安全团队可以挂载 AuditMiddleware。引擎还是那个引擎,但在不同的团队手里,它长出了完全不同的业务形态。
Harness 的核心方法 Execute 负责串联中间件与引擎的调度逻辑。BeforeLLMRequest 和 AfterLLMResponse 在 Harness 入口/出口处调用;BeforeToolExecute 则由引擎在每次工具派发时内部调用(传入已注册的 middlewares 引用),因此不出现在下面的 Execute 函数中:
go
func (h *Harness) Execute(prompt string) (*RunResult, error) {
    agentCtx := NewAgentContext("", prompt, 128000)

    for _, m := range h.middlewares {
        if err := m.BeforeLLMRequest(context.Background(), agentCtx); err != nil {
            return nil, fmt.Errorf("middleware rejected: %w", err)
        }
    }

    result, err := h.engine.Run(context.Background(), agentCtx, h.tools)
    if err != nil {
        return nil, err
    }

    for _, m := range h.middlewares {
        _ = m.AfterLLMResponse(context.Background(), result.LastResponse)
    }
    return result, nil
}
以“代码审查 Agent”和“云资源巡检 Agent”为例,两者共享同一个 RunLoopEngine,区别仅在于注册的工具和中间件不同:前者注入 GitDiffTool + LintGrader,后者注入 AWSInspectorTool + CostAlertMiddleware。当引擎升级了熔断逻辑或上下文压缩算法时,所有业务方自动受益,无需各自维护 fork 分支。这种“引擎归引擎、业务归业务”的分治策略,就是 Agent 中间件在企业内跨团队推广的工程基础。
处理器管道与多层钩子
上面的 Middleware 接口覆盖了 RunLoop 外围的生命周期拦截。当拦截粒度深入到 ReAct 循环内部时(上下文组装、规划指令注入、Function Call 路由、子智能体交接),每一步同样应拆解为独立的处理器,串联成管道:
go
type RequestProcessor interface {
    ProcessRequest(ctx context.Context, agentCtx *AgentContext, req *ChatRequest)
}
type ResponseProcessor interface {
    ProcessResponse(ctx context.Context, agentCtx *AgentContext, req *ChatRequest, resp *ChatResponse)
}
LLM 调用前串联 ContentProcessor(构建消息列表)→ PlannerProcessor(注入规划指令)→ CompactionProcessor(Token 超限时压缩);调用后串联 FunctionCallProcessor(路由工具调用)→ TransferProcessor(处理子智能体交接)→ GuardrailProcessor(输出审查)。每个 Processor 只关心一件事,新增能力只需追加一个 Processor 而不必修改主循环。
外围 Middleware、循环内 Processor、加上 Agent 实例级的回调,构成工业级框架中完整的三层钩子体系,如表 14-1 所示。
表 14-1 三层钩子体系
| 层级 | 作用域 | 生命周期 | 典型用途 |
|---|---|---|---|
| Agent Callbacks | 单个 Agent 实例 | 与 Agent 同生命周期 | BeforeAgent / AfterAgent,用于 Trace 埋点 |
| Agent Extensions (Processor) | 构造时注入 | 静态组合 | 规划注入、工具管道过滤、目标约束 |
| Runner Plugins (Middleware) | 全局 Runner | 跨所有 Agent | 安全护栏、Prompt 注入检测、成本审计 |
本书的 OutputGuard、InputGuardrail、HITLArbitrator 分别对应其中的 Runner Plugin 和 Agent Callback 层级。当团队希望以“插件市场”的形式分发安全能力、可观测探针或成本控制策略时,三层钩子的分工使得各层可独立演进、互不侵入。
14.1.3 从固定钩子到事件总线的演进
上述三层钩子体系在中小规模团队中运作良好,但存在一个结构性约束:拦截点是编译期枚举的。Middleware 接口硬编码了 BeforeLLMRequest、AfterLLMResponse、BeforeToolExecute 三个方法签名,每新增一个生命周期节点(如 BeforeCompaction、AfterSubAgentTransfer),所有已有的 Middleware 实现都必须补齐空方法——即使它们对新节点毫无兴趣。当插件数量从个位数膨胀到数十个时,接口膨胀与空实现的维护成本将变得不可忽视。
业界的一种演进方向是将固定钩子替换为 Service + Event 双轨机制。其核心思想是把 Harness 拆分为两条正交的通道:
- Service 轨(能力获取):通过上下文注入的方式,向插件暴露引擎的核心能力端口——LLM 调用、工具注册表、会话存储等。插件通过
ctx.LLM()、ctx.Tools()获取服务引用,而非直接依赖具体实现。这与本书第五章的 DDD 端口注入思路一脉相承。 - Event 轨(流程扩展):引擎在每个生命周期节点广播事件(如
tool:pre-execute、llm:post-response、context:pre-compact),插件按需订阅。多个订阅者通过洋葱模型串联——前一个插件调用next()将控制权交给下一个,任何一环都可以拦截、修改或终止流程。
以工具执行前的安全检查为例,在固定钩子模型下,安全逻辑必须写在 BeforeToolExecute 这个唯一入口里;而在事件总线模型下,安全插件、审批插件、审计插件各自独立订阅 tool:pre-execute 事件,彼此无需感知对方的存在:
go
type Event struct {
    Name    string
    Payload map[string]interface{}
}

type EventHandler func(ctx context.Context, e *Event, next func() error) error

type EventBus struct {
    handlers map[string][]EventHandler
}

func (bus *EventBus) On(event string, h EventHandler) {
    bus.handlers[event] = append(bus.handlers[event], h)
}

func (bus *EventBus) Emit(ctx context.Context, e *Event) error {
    handlers := bus.handlers[e.Name]
    var run func(i int) error
    run = func(i int) error {
        if i >= len(handlers) {
            return nil
        }
        return handlers[i](ctx, e, func() error { return run(i + 1) })
    }
    return run(0)
}
引擎主循环仅保留最小骨架——“组装上下文 → 调用模型 → 解析工具调用 → 返回结果”,所有横切关注点(上下文压缩、安全护栏、人机审批、可观测埋点)均退化为事件订阅者。新增能力只需 bus.On(“event:name”, handler),无需修改任何已有接口。
这一思路在近年来的 Agent 框架实践中已被验证:引擎将每一轮对话(Turn)视为原子调度单元,在 Turn 的入口和出口广播事件,插件在事件链上组合出任意复杂的行为——从简单的日志记录到多级审批流,均可通过事件编排实现。
两种模型的工程权衡,如表 14-2 所示。
表 14-2 固定钩子与事件总线权衡
| 维度 | 固定钩子(本书方案) | 事件总线 |
|---|---|---|
| 类型安全 | 编译期检查,IDE 可跳转 | 事件名为字符串,需配合常量或代码生成 |
| 调试友好度 | 调用栈清晰,断点可达 | 需要事件追踪中间件辅助 |
| 扩展成本 | 新节点需改接口,所有实现补空方法 | bus.On() 即插即用 |
| 适用规模 | 团队 <10 人、插件 <10 个 | 平台化、插件市场、跨组织协作 |
| 学习曲线 | 低,接口即文档 | 中等,需理解事件流与洋葱模型 |
本书选择固定钩子方案,是因为它在教学清晰度与工程严谨性之间取得了最佳平衡。但当读者的生产系统走向平台化——需要支持第三方插件热加载、跨团队独立交付、甚至插件市场——事件总线是架构演进的自然方向。理解这条演进路径,有助于在项目初期就预留出 EventBus 接口的扩展空间,避免未来的大规模重构。
14.2 执行前拦截与预检管道
赋予 Agent 执行系统命令的权限是一把双刃剑。在复杂的业务环境中,仅仅依靠模型自身的道德约束是不够的,必须在副作用发生前建立静态防护网,通过预检拦截从架构层面阻断“删库跑路”类灾难性风险。本节先分析哪些操作属于不可逆的破坏性命令,再用 AST 解析和正则匹配构建一条前置检查管道。
14.2.1 拦截不可逆的破坏性操作
在大模型生成的 bash 脚本被丢给 exec.Command 执行之前,系统面临着极高的安全风险。如果 LLM 产生幻觉并输出了 drop table users 或者 rm -rf /,传统的报错重试机制将毫无意义,因为物理数据已经被抹除。因此,工业级引擎必须在执行任何副作用动作前进行静态预检,通过正则匹配与命令树解析识别高危模式并拦截。
14.2.2 静态分析管道的实现
预检的实现依赖一层前置的检查器。它会在 Harness 的 BeforeToolExecute 阶段拦截参数:先使用 mvdan.cc/sh/v3/syntax 完成 AST 解析和结构检查,再用正则表达式补充识别显式的高危字面量。
go
// RiskLevel 枚举复用 HITL 章节定义:RiskNone / RiskLow / RiskHigh / RiskCritical

type PreflightChecker interface {
    Check(toolName string, args map[string]interface{}) (RiskLevel, error)
}

// 针对 Bash 工具的静态拦截器
type BashAnalyzer struct {
    blockedPatterns []*regexp.Regexp
}

func (b *BashAnalyzer) Check(toolName string, args map[string]interface{}) (RiskLevel, error) {
    if toolName != "bash" {
        return RiskNone, nil
    }

    script, ok := args["command"].(string)
    if !ok {
        return RiskCritical, errors.New("invalid bash command format")
    }

    // 第一层:解析 AST,拒绝管道、重定向、子命令和动态展开
    if err := tools.ValidateBashAST(script); err != nil {
        return RiskCritical, err
    }

    // 第二层:拦截高危字面量
    for _, pattern := range b.blockedPatterns {
        if pattern.MatchString(script) {
            return RiskCritical, fmt.Errorf("command matches blocked pattern: %s", pattern.String())
        }
    }

    // 如果包含 sudo 等敏感前缀,返回 High,交由后续的 HITL 人工审批
    if strings.Contains(script, "sudo") || strings.Contains(script, "chmod") {
        return RiskHigh, nil
    }

    return RiskNone, nil
}
在这套机制下,一旦 BashAnalyzer 识别出高风险结构或命令,RiskCritical 会将拒绝原因作为 ToolResult 回传给模型,要求其重新规划;RiskHigh 则触发终端挂起,交由人类二次确认。AST 与正则预检可以缩小攻击面,真正的权限边界仍由 HITL 和 OS 级沙箱提供。
14.2.3 分层检测的工程权衡
正则匹配是预检的快速起步方案,但面对 $(cat /dev/urandom | dd of=/dev/sda) 这类嵌套管道或 Base64 混淆的命令时,正则几乎无能为力。工业级 Preflight 因此采用分层漏斗:先用正则快筛(零延迟)拦截 rm -rf、DROP TABLE、mkfs 等显性风险,上文 BashAnalyzer 即承担此角色;对漏网之鱼,再以 AST 结构分析(毫秒级)遍历 CallExpr 节点,捕获 env rm -rf / 或变量拼接等间接调用;仍无法判定的 RiskHigh 命令(如 sudo、chmod 777、curl | sh),则交由第九章的人机审批作最终兜底。
三层漏斗的设计哲学与第七章工具安全防线一脉相承:确定性规则优先,模糊区域交给人类。正则与 AST 的 $O(n)$ 扫描在延迟敏感的 Agent Loop 中几乎不可感知,组合后的覆盖面却远超单一方案,尽管对高度混淆的脚本,任何静态分析仍可能留有盲区。
14.3 模型路由与多模型供应商降级
随着开源模型能力的提升和商业模型价格的波动,硬编码单一 模型供应商的做法显得既脆弱又昂贵。Agent 架构需要统一的模型路由与凭据管理,使系统能根据任务复杂度与 API 状态,在不同厂商和成本梯队间动态切换与降级容错。
14.3.1 基于成本调度的降级需求
在企业内推广 Agent,最大的阻力往往是 API 成本。如果无论是简单的“翻译注释”还是复杂的“架构重构”,系统都在无差别调用昂贵的旗舰模型,月度 API 预算很容易被快速耗尽。我们需要根据任务的复杂度和模型 API 的健康状况,进行动态的流量降级与路由切换。这就要求系统能够无缝对接多个厂商。
14.3.2 路由与协议解耦的设计
为了解决这个问题,我们需要引入 Profile 和 Router 的概念。LLMAdapter 定义统一的推理接口,而 Profile 作为纯粹的数据结构,存储具体的实例凭据。
go
// Profile 封装底层实例配置
type LLMProfile struct {
    Provider string // "openai", "anthropic", "vllm"
    ModelID  string // "gpt-5", "claude-sonnet-4-6", "deepseek-chat"
    APIKey   string
    BaseURL  string
}

// 统一的接口定义
type LLMAdapter interface {
    ChatStream(ctx context.Context, messages []Message) (<-chan Chunk, error)
}

// Router 负责根据 Profile 实例化对应的适配器
type Router struct {
    profiles map[string]LLMProfile
}

func (r *Router) RouteTo(profileName string) (LLMAdapter, error) {
    p, exists := r.profiles[profileName]
    if !exists {
        return nil, errors.New("profile not found")
    }

    switch p.Provider {
    case "openai":
        return NewOpenAIAdapter(p.APIKey, p.ModelID), nil
    case "anthropic":
        return NewAnthropicAdapter(p.APIKey, p.ModelID), nil
    default:
        return nil, fmt.Errorf("unsupported provider: %s", p.Provider)
    }
}
通过这层抽象,上层的 AgentContext 只需要声明“本次任务使用 cost-saving 档位”,底层的 Router 会自动解析出 DeepSeek 的凭据并完成依赖注入;如果 DeepSeek 报错 503,Router 还可以迅速熔断并切换到 OpenAI 适配器。这种架构让业务层彻底告别了硬编码的 API Key 泥潭。
14.3.3 任务分级与健康探测
有了 Router 之后,下一个问题是:谁来决定本次任务走哪个档位? 最简单的策略是基于 Prompt 长度和工具调用类型做启发式分级。例如,用户只说“帮我翻译这句注释”,Prompt 短且不涉及文件写入,可以路由到廉价的 deepseek-chat;而“重构整个 auth 模块”则需要强模型 claude-sonnet。
go
type CostTier int
const (
    TierEconomy  CostTier = iota // 翻译、解释、简单问答
    TierStandard                 // 单文件修改、代码补全
    TierPremium                  // 多文件重构、架构设计
)

func ClassifyTask(prompt string, tools []string) CostTier {
    if len(prompt) < 200 && !containsWriteTools(tools) {
        return TierEconomy
    }
    if containsMultiFileTools(tools) || len(prompt) > 2000 {
        return TierPremium
    }
    return TierStandard
}
路由的另一半是健康探测。Router 应为每个 Profile 维护一个滑动窗口计数器,记录最近 N 次调用的失败率。当某个 Provider 连续失败超过阈值时(与第六章熔断器同理),Router 自动将其标记为 Unhealthy 并将流量切换到备选 Profile,直到探活请求成功后恢复。这种“分级选路 + 熔断降级”的组合,使系统在多模型生态下既能控制成本,又能保持高可用。
14.4 协议栈与框架生态
路由与降级解决了"选哪个模型"的问题,但模型接入还涉及协议适配和框架选型——前者决定了 Agent 与供应商之间的通信语义,后者决定了工程团队的开发效率与长期维护成本。
14.4.1 协议栈的三层定位
路由机制解决了模型选择,但在调用层面,Agent 还需理解三层协议的分工。随着 Agent 生态的演化,各种协议层出不穷。在 2025-2026 年,最常被混淆的是三个概念:Function Calling、MCP 和 A2A。其实它们并不冲突,而是分别定义了 Agent 生态中的调用格式、工具供给和智能体互联三个不同层级。
三种协议分别对应进程内、本地/远程、跨组织三个通信层次,形成递进的协议栈,如图 14-1 所示。
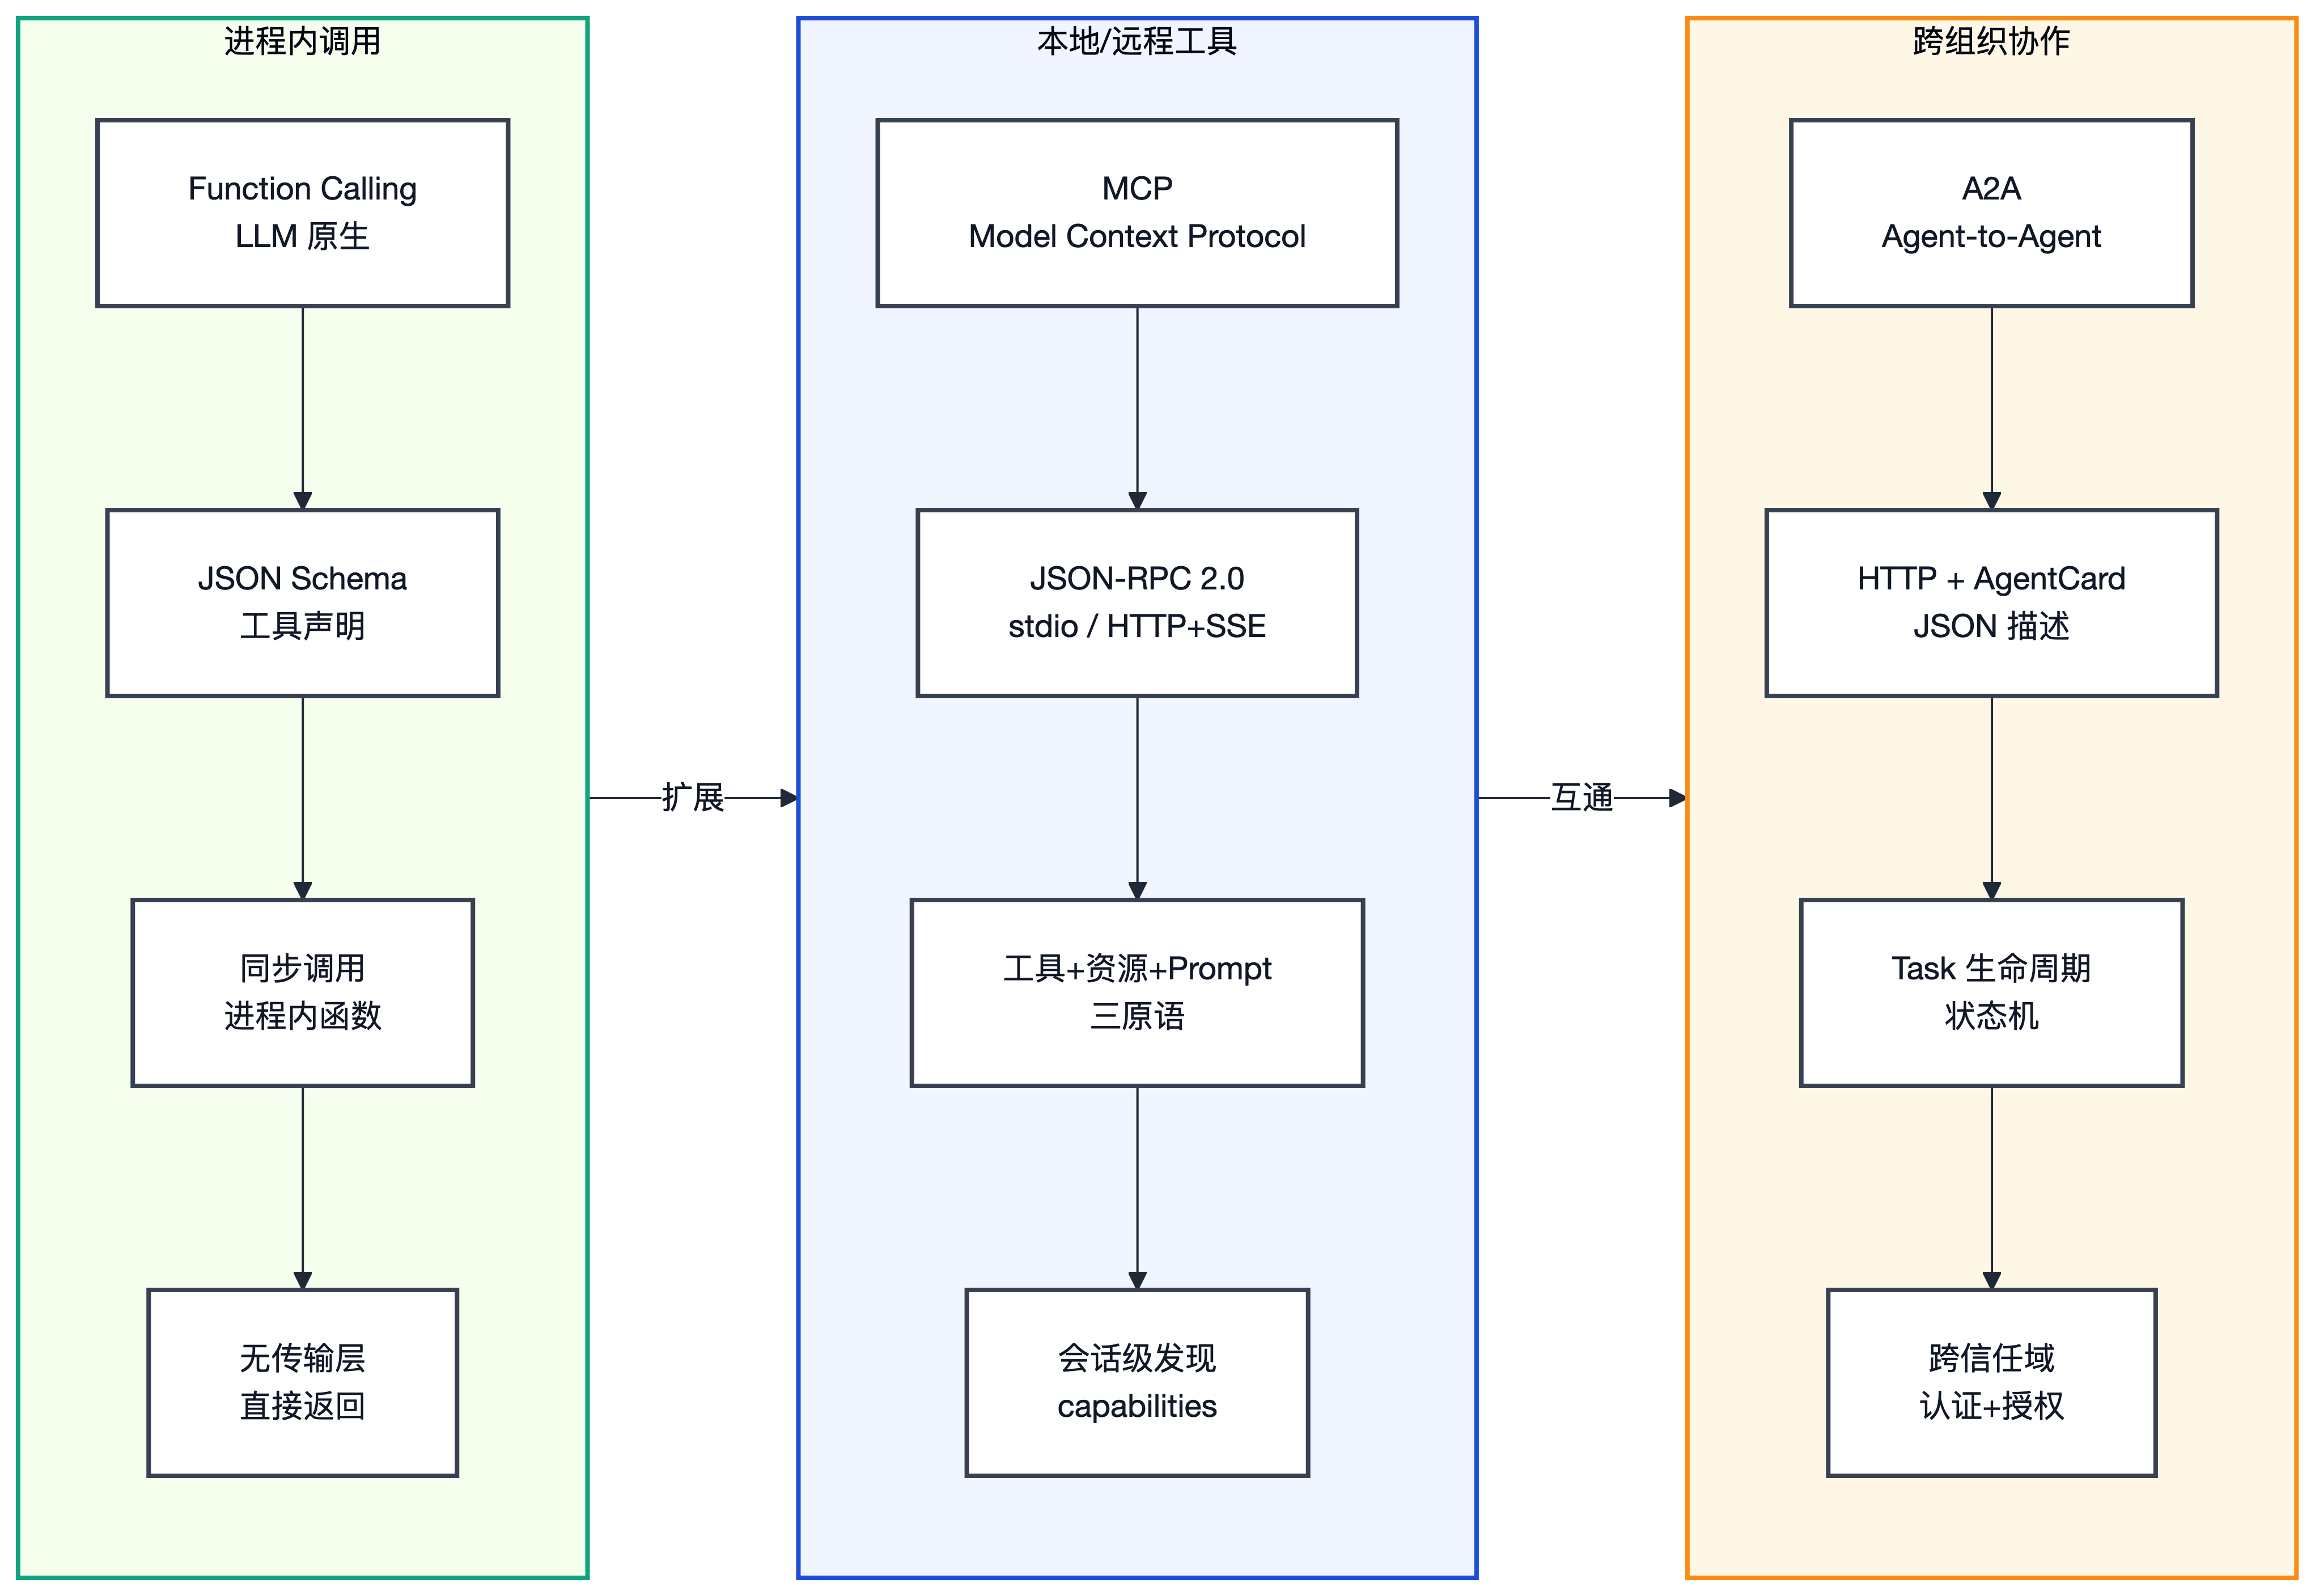
协议栈各层职责对照,如表 14-3 所示。
表 14-3 Agent 协议栈三层对照
| 维度 | Function Calling | MCP (Model Context Protocol) | A2A (Agent-to-Agent) |
|---|---|---|---|
| 核心解决什么 | 模型怎么表达意图 | Agent 怎么接管工具/数据 | Agent 之间怎么协同对话 |
| 通信层级 | 大模型 API 层 | Agent ↔ 外部系统 | Agent ↔ Agent |
| 抽象实体 | JSON Schema | Tool / Resource / Prompt | Task / Message / Agent Card |
| 典型发起方 | OpenAI / Anthropic API | Agent 客户端 (如 OpenCode) | 另一个独立运行的 Agent |
| 生动类比 | “语法书” | “USB 接口规范” | “HTTP 通信协议” |
| 本书对应 | LLM 驱动器章节 | OpenCode 解构章节 | 多智能体协同章节 (Agent-as-Tool) |
层次关系解析:
Function Calling、MCP 与 A2A 并非互斥,而是沿调用链逐级抬升抽象。最底层,Function Calling 只是模型表达意图的数据格式,返回一段符合 JSON Schema 的文本,声明“我想调用哪个工具”。在此之上,MCP 解决“工具从哪里来”:接入 GitHub MCP Server 时,MCP 把 GitHub 能力翻译成 JSON Schema 供 Function Calling 消费,再把调用结果传回 GitHub,它是竖向的、连接非智能系统的协议。最上层,A2A (如 Google 倡导的 Agent-to-Agent 协议)则面向独立智能体之间的跨服务通信:代码编写 Agent 需要测试审查 Agent 协助时,双方通过 A2A 握手、传递 Task 上下文并协商,它是横向的、连接智能系统的协议。
在实际项目中,最容易混淆的往往是 MCP 与 A2A 的边界:前者扩展单个 Agent 的工具箱,后者编排多个已具备自主能力的 Agent。若任务仍可在单进程内以 Agent-as-a-Tool 完成,引入 A2A 往往过早;若需跨组织、跨服务边界协调异构智能体,MCP alone 则不够。多智能体协同章节的进程内协同,可视为 A2A 在中小型项目中的轻量替代。
MCP 的传输机制:MCP 基于 JSON-RPC 2.0 定义客户端(Agent)与服务端(工具提供方)之间的消息格式。常用标准传输包括 stdio 和 Streamable HTTP:stdio 适用于本地子进程,双方经 stdin/stdout 交换消息;Streamable HTTP 适用于远程服务,客户端通过 HTTP POST 发送消息,服务端可按协议要求返回单个 JSON 响应,或在需要流式传输时返回 SSE 事件流。两种传输共享同一套初始化语义:Client 首先发送 initialize,Server 返回协议版本、Server 信息与 capabilities,随后 Client 发送 notifications/initialized。初始化完成后,Client 再根据 Server 声明的能力调用 tools/list、resources/list 或 prompts/list 获取具体条目,并通过 tools/call 等方法发起实际请求。OpenCode 解构章节中介绍的是通过 stdio 模式接入本地 MCP Server 以扩展工具集。
A2A 的 Task 生命周期:Google 提出的 A2A 协议围绕 Task 这一核心实体设计了完整的状态机。一个 Task 的生命周期为:submitted(发起方通过 tasks/send 创建任务)→ working(接收方 Agent 开始处理)→ 可选的 input-required(接收方需要更多信息,暂停等待发起方补充)→ completed 或 failed(终态)。发起方通过 tasks/get 轮询或 tasks/sendSubscribe 订阅 SSE 来获取状态更新。Agent 之间的发现依赖 Agent Card,一份发布在 /.well-known/agent.json 的元数据文件,声明该 Agent 的 capabilities、认证方式和支持的输入/输出格式。这种发现机制类似于 OAuth 的 .well-known/openid-configuration,使得异构 Agent 可以在无预配置的前提下互相定位和调用。
回扣本书架构:在本书中,我们已经深度实现了前两层,通过 LLM 驱动器章节手搓了底层的 Tool Call 格式解析,又在多智能体协同章节用 Go 的 Goroutine + Channel 实现了进程内的多 Agent 协同(Agent-as-Tool 模式)。对于绝大多数中小型项目,进程内的高并发调用已经足够强悍。而当你需要跨组织、跨服务边界去编排成百上千个异构智能体时,基于 A2A 的 Task 状态机和 Agent Card 发现机制,将是你走向下一步架构演进的必然选择。
14.4.2 Go 智能体框架选型指南
理解了协议栈的三层定位之后,一个自然的问题是:既然 Go 生态已经有了若干 Agent 框架,我们还需要从零手搓吗?答案取决于你要解决的问题处于哪个抽象层次。以下对比四个主流 Go Agent 框架与本书手搓方案的定位差异,帮助读者在“自建引擎”和“站在框架肩膀上”之间做出工程判断。
google/adk-go——Google 官方智能体开发套件
google/adk-go(google.golang.org/adk/v2)是 Google 于 2025 年开源的 Agent Development Kit 的 Go 版本,2026 年 6 月发布 v2.0 GA,从层级执行器全面转向图引擎架构。
核心设计:Agent、Tool、Function 被定义为有向图中的节点(Node),由并发调度器按拓扑序执行。支持静态图(声明式 Edge 路由)、动态图(RunNode 命令式控制)、条件分支、Fan-out/Fan-in (JoinNode)、循环与嵌套子图。每个节点可配置独立的重试策略和超时。
go
// adk-go v2 的典型工作流定义
import (
    "google.golang.org/adk/v2/workflow"
    "google.golang.org/adk/v2/workflow/workflowagent"
)

edges := []workflow.Edge{
    {Src: workflow.Start, Dst: "planner"},
    {Src: "planner", Dst: "coder", Route: workflow.Route("code")},
    {Src: "planner", Dst: "reviewer", Route: workflow.Route("review")},
    {Src: "coder", Dst: workflow.End},
    {Src: "reviewer", Dst: workflow.End},
}
// nodes 需预先用 workflow.NewNode(...) 创建并注册处理函数
agent := workflowagent.New("pipeline", edges, nodes...)
HITL 支持:内置 RequestInput 机制,节点可挂起等待人工输入,状态持久化后跨进程恢复,与 HITL 章节的 Run/Continue 原子暂停设计异曲同工。
A2A 原生:作为 Google A2A 协议的官方 Go 实现,adk-go 天然支持 Agent Card 发现、Task 状态机和跨服务 Agent 协同。如果你的多 Agent 场景需要跨组织边界,adk-go 是目前最直接的选择。
适用场景:需要图引擎编排复杂工作流、深度集成 Gemini/Vertex AI、或需要 A2A 跨服务协同的项目。默认优化 Gemini 但支持其他模型。
cloudwego/eino——字节跳动出品的全功能框架
eino(读作“i know”)是字节跳动 CloudWeGo 团队开源的 Go LLM 应用框架,设计理念融合了 LangChain 的组件抽象与 Google ADK 的 Agent 模式。
核心设计:围绕 ChatModelAgent 实现 ReAct 循环,模型推理、工具调用、结果反馈的自治决策闭环。提供类型安全的组件抽象(ChatModel、Tool、Retriever、Embedding),以及自动化的流式数据处理(拼接、分流、合并由框架接管)。
Agent 模式丰富:除了基础的 ChatModelAgent,还提供:
- DeepAgents:内置任务规划(WriteTodos)、文件系统操作、Shell 执行和子智能体委派,开箱即用的编程助手模式
- 工作流 Agent:
SequentialAgent、ParallelAgent、LoopAgent用于确定性编排 - 协作模式:Supervisor、Plan-Execute-Replan (规划-执行-重规划)
HITL 与中间件:v0.9 引入的 Agentic Runtime 支持安全点取消、Checkpoint 持久化、TurnLoop 多轮交互运行时。中间件机制(ChatModelAgentMiddleware)允许在 ReAct 循环的生命周期注入压缩、搜索、重试等横切逻辑,与记忆压缩章节的 Compactor 和前文 Middleware 设计不谋而合。
生态广度:通过 eino-ext 提供 OpenAI、Claude、Gemini、Ollama、Elasticsearch 等官方集成,DevOps 可视化调试工具,以及评估器和 Prompt 优化器。
适用场景:需要 ReAct Agent + 流式处理 + 中间件扩展的全功能开发,尤其适合已在使用字节/火山引擎生态的团队。
trpc-group/trpc-agent-go——腾讯 tRPC 团队的生产级框架
trpc-agent-go 是腾讯 tRPC 团队开源的 Go Agent 框架,经腾讯元宝、腾讯视频、腾讯新闻、IMA、QQ 音乐等内部产品的大规模生产验证。
核心设计:提供五种 Agent 执行模式,覆盖从简单到复杂的全谱系场景:
- LLMAgent:基于大模型的自治推理,支持工具调用和多轮对话
- ChainAgent:链式执行,适合多步任务分解的串行管线
- ParallelAgent:并行处理,支持多专家协作和 Fan-out/Fan-in
- CycleAgent:迭代循环,支持自优化和自修正的闭环
- GraphAgent:图工作流引擎,采用 BSP 执行模型,支持条件路由、工具路由和自然并行,既是 Graph 又是 Agent,实现了工作流与智能体的深度融合
协议全覆盖:同时支持 A2A (跨 Agent 协同)、AG-UI (Agent-to-UI 实时流式交互)和 MCP,是目前 Go 生态中协议覆盖最全的框架。tRPC 团队此前还单独开源了 trpc-a2a-go 和 trpc-mcp-go,生态闭环完整。
生产级特性:内置 OpenTelemetry 全链路追踪、Redis/内存双模式会话持久化、RAG 检索增强、Checkpoint 时间旅行(可回溯到图中任意节点的历史状态)、以及 HITL 人机协同。
适用场景:已在使用 tRPC 微服务体系的腾讯系或 Go 微服务团队,需要将 Agent 能力嵌入现有服务架构、且对生产可观测性要求高的项目。
tmc/langchaingo——LangChain 的 Go 移植
langchaingo 是社区维护的 LangChain Go 移植版,最大优势是集成广度,覆盖了 Go 生态中最多的 LLM Provider 和向量数据库适配器。
定位:链式组合、文档加载器、检索器的工具箱,偏向 RAG 和数据处理管线。Agent 能力相对基础,提供 OneShotAgent + Executor 的标准 ReAct 循环。
注意事项:截至 2026 年仍为 pre-1.0 (v0.1.14),API 持续演进。适合需要快速接入多种 LLM 后端或向量数据库的场景,但复杂的多 Agent 编排和生产级 HITL 需自行补充。
选型矩阵:框架与自研
各框架能力对照如表 14-4 所示。
表 14-4 Go 智能体框架选型矩阵
| 维度 | 本书手搓 | google/adk-go | eino | trpc-agent-go | langchaingo |
|---|---|---|---|---|---|
| 核心定位 | 教学 + 深度定制 | 图引擎工作流 | 全功能 Agent 框架 | 生产级微服务 Agent | LLM 集成工具箱 |
| ReAct Loop | 状态机章节逐行实现 | LlmAgent 内置 | ChatModelAgent 内置 | LLMAgent 内置 | Executor 内置 |
| 工具系统 | 工具箱章节手搓 Registry | 声明式 Node 注册 | 类型安全 Tool 抽象 | Tool + MCP 内置 | tools.Tool 接口 |
| HITL | HITL 章节 Run/Continue 原子暂停 | RequestInput 挂起 | Interrupt/Resume | GraphAgent HITL | 无内置 |
| 多 Agent | 多智能体章节 Agent-as-Tool | 图节点 + A2A 原生 | Supervisor/DeepAgents | Chain/Parallel/Cycle + A2A | 无内置 |
| 上下文压缩 | 记忆压缩章节双阈值 Compactor | 无内置 | 中间件 Summarization | 会话记忆管理 | Memory 模块 |
| 流式输出 | LLM 驱动器章节 StreamChat | Event 流 | 全自动流式管理 | AG-UI 流式协议 | Streaming 回调 |
| 可观测 | 可观测章节 slog/OTel | Callback 钩子 | DevOps 可视化 | OTel 全链路内置 | Callback 钩子 |
| 协议支持 | 手搓 Function Calling | A2A 原生 | MCP 集成 | A2A + AG-UI + MCP 全覆盖 | 无 |
| 生产验证 | go-coder 教学项目 | Google 内部 | 字节跳动内部 | 腾讯元宝/视频/新闻等 | 社区项目 |
| 学习曲线 | 最高(全部手写) | 中(图 DSL) | 中(组件组合) | 中(多 Agent 模式) | 低(链式调用) |
选型建议:
- 学习和深度定制:参考本书方案。当你需要理解 Agent 各个环节如何协作,或需要针对特定业务进行深度定制时,自行组装核心组件是一种可控性较高的选择。本书的价值不在于提供另一个通用框架,而在于帮助读者建立理解、选择和定制 Agent 框架的工程判断力。
- 图编排 + A2A 跨服务协同:选
google/adk-go。图引擎天然适合复杂工作流(审批链、多阶段管线),A2A 原生支持让跨组织 Agent 协同不需要自己造轮子。 - 全功能 Agent + 中间件生态:选
eino。如果你需要开箱即用的 ReAct Agent、DeepAgents 任务规划、流式处理和丰富的中间件生态,eino 是目前 Go 生态中功能最完整的选择。 - 微服务体系 + 生产可观测:选
trpc-agent-go。如果你的基础设施已建立在 Go 微服务之上,需要 Agent 无缝嵌入现有服务网格,且对全链路追踪、会话持久化和协议覆盖有刚需,trpc-agent-go 经过腾讯多条业务线的大规模验证,是生产就绪度最高的选项。 - 快速接入多 LLM 后端:选
langchaingo。当核心需求是“用最少代码对接 N 种 LLM 和向量库”时,langchaingo 的集成广度是其他框架难以匹敌的。
这五种方案并非互斥。一种常见的生产模式是:用本书的架构思想设计核心 循环,用 eino 或 adk-go 的组件处理工具注册和流式管道,用 langchaingo 的 Provider 适配器快速对接多模型,或直接将手搓 Agent 作为 trpc-agent-go 的自定义 Agent 嵌入微服务体系,理解原理与善用框架,从来不是二选一的命题。
14.5 异步通道适配与即时通讯网关
当我们将 Agent 从终端解放,试图接入企业 IM 工具(如 Slack 或飞书)时,长生命周期的思考循环与 IM 平台短连接响应的矛盾便会立刻爆发,Webhook 要求数秒内返回 ACK,而 Agent 完整走完“思考-行动-再思考”的循环动辄数十秒甚至数分钟。以下通过异步消息网关与事件适配器,拆解这一“超时悖论”的成因与解法。
14.5.1 Webhook 的致命限制
当产品经理要求把 Agent 搬到企业微信或 Slack 里时,工程侧通常面临一个致命悖论:IM 平台的 Webhook 要求服务器在极短时间内(通常为 3 秒)返回 HTTP 200 (ACK)。然而,Agent 完整走完“思考-行动-再思考”的循环,动辄需要数十秒甚至数分钟。如果直接在 HTTP Handler 中同步阻塞等待 LLM 返回,不仅会导致 Webhook 超时断连,还会引发 IM 平台的无限重试洪峰。
14.5.2 通道适配器异步解耦实现
要解决这一悖论,必须将“接收流”与“发送流”彻底断开。我们需要引入 ChannelAdapter 接口,它负责将外部平台的异构消息转换为系统内部事件,并将请求立刻丢入异步队列缓冲。
go
// 多端适配器抽象
type ChannelAdapter interface {
    // 1. 解析 Webhook Payload,放入内部队列,随即立即返回 200 ACK 给飞书/Slack
    HandleIncoming(req *http.Request) (sessionID string, prompt string, err error)

    // 2. Agent 推理完成后(可能是 3 分钟后),主动调用 IM 平台的 OpenAPI 回写消息
    SendReply(ctx context.Context, sessionID string, content string) error
}

// Gateway 作为消息中枢
type IMGateway struct {
    adapters map[string]ChannelAdapter
    tasks    chan struct{ SessionID, Prompt string }
}

func (g *IMGateway) StartConsumers(workers int, runner *Harness) {
    for i := 0; i < workers; i++ {
        go func() {
            for task := range g.tasks {
                // 1. 创建 Context 并执行长生命周期的 Agent Loop
                result, err := runner.Execute(task.Prompt)
                if err != nil {
                    continue
                }

                // 2. 找到对应的适配器(假设映射表存在)
                adapter := g.getAdapterForSession(task.SessionID)

                // 3. 异步回写结果给用户("您的代码审查报告已出炉:")
                adapter.SendReply(context.Background(), task.SessionID, result.Summary)
            }
        }()
    }
}
在这种设计下,Agent Loop 变成了一个纯粹的消费者。无论是飞书的 Webhook、Slack 的 WebSocket,还是命令行的 os.Stdin,在 Harness 看来都只是一个投递 Prompt 并接收 Result 的客户端。这就从架构上完成了“多端接入”的演进。
14.5.3 会话关联与进度推送
异步架构引入后,三个工程细节决定了用户体验的上限。
会话关联:Webhook 传来的 sessionID 必须能映射回一个完整的 AgentContext。最简单的方案是维护一个 sync.Map[string]*AgentContext,生命周期与 Worker 协程绑定;对于需要跨进程恢复的场景,则通过第六章实现的 Checkpoint 机制将 AgentContext 序列化到 Redis 或 SQLite,Worker 启动时按 sessionID 反序列化恢复上下文,这与 CLI 的 resume 命令机制相同。
进度推送:Agent 跑了两分钟,用户在飞书群里什么反馈都看不到,体验极差。解决方案是在 RunLoop 的每一轮工具调用完成后,通过 ChannelAdapter.SendReply 推送一条轻量级进度消息(如“正在读取 auth/handler.go…”“编译通过,开始跑测试…”)。这些中间消息不需要等到 Agent 最终完成,而是在 Agent Loop 的 StateExecuting 阶段每个工具调用完成后触发。
幂等去重:IM 平台超时后必然重发 Webhook。Gateway 的 HandleIncoming 应以 messageID(平台提供的唯一标识)为键做幂等检查:如果该 ID 已在处理中或已完成,直接返回 200 ACK 而不再入队。一个简单的带 TTL 的 map[string]bool 即可覆盖绝大多数场景。
14.5.4 会话持久化:事件日志
多端接入后,Session 的持久化要求从“单进程崩溃恢复”上升为“跨进程、跨机器可恢复”。工业级的做法是将 Session 建模为事件日志:每一条 LLM 请求、LLM 响应、工具调用、工具结果都作为一个不可变事件追加到持久化存储,AgentContext 启动时从事件日志重放还原完整状态:
go
type SessionEvent struct {
    ID        string          `json:"id"`
    SessionID string          `json:"session_id"`
    Type      string          `json:"type"` // "llm_request" | "llm_response" | "tool_call" | "tool_result"
    Payload   json.RawMessage `json:"payload"`
    CreatedAt time.Time       `json:"created_at"`
}

type SessionStore interface {
    Append(ctx context.Context, event SessionEvent) error
    Replay(ctx context.Context, sessionID string) ([]SessionEvent, error)
}
事件日志的核心优势在于三点:
- 增量写入:每轮循环只追加新事件,不需要全量覆写,对高频循环的 IO 开销更低。
- 可审计性:事件日志天然是时间线,配合可观测性章节的 Trace,每一步推理和工具调用都有迹可查。
- 灵活重放:从事件日志还原时可以选择性跳过(如丢弃中间的大段工具输出),实现精细的上下文恢复。
需要注意的是,Replay 的正确性依赖事件顺序的严格保证,事件 schema 的版本兼容也需要维护。状态机章节的 checkpoint 目前是覆盖写全量快照(单个 JSON object),不具备事件日志的追加语义。演进路径是将 PersistCheckpoint 改为 append-only 的 SessionStore.Append,每轮循环只追加本轮增量事件,而不是覆写完整状态。RunLoop 的循环结构无需改动,只需替换持久化后端。
14.6 动态人设与偏好记忆
解决了企业级多端接入的工程问题后,Agent 面对不同用户时还需要具备个性化能力——这就进入了从标准化服务到面向个人的另一条演进轴线。企业级 Agent 往往被设计为无状态的任务执行机器,但对于 2C 的个人智能体而言,其核心竞争力在于对用户长期偏好的记忆与适配,架构需要动态的系统提示词挂载与偏好记忆模块,使 Agent 随使用不断演进。
14.6.1 个人智能体的记忆缺失
经过前几节的改造,我们的 Agent 已经是一个合格的企业级工具了。但在构建 2C 的个人智能体时,其核心痛点变成了个性化记忆。开发者会抱怨:“我上周就跟 Agent 说过我的项目必须使用 4 个空格缩进,为什么它今天生成代码还是用了 Tab?”缺乏持久记忆的 Agent,就像一个拥有短期健忘症的流水线工人。
14.6.2 系统提示词的动态挂载
要治愈这种健忘症,架构需要将原本静态的 系统提示词 拆解为多个动态拼装的“记忆模块”。在每次 Agent 唤醒并初始化 AgentContext 时,PersonaLoader 会从数据库或持久化文件中捞取用户的专属设定。
go
type PersonaLoader struct {
    fs fs.FS
}

func (p *PersonaLoader) BuildSystemPrompt(userID string) (string, error) {
    var promptBuilder strings.Builder

    // 1. 注入内核灵魂(硬性规则与安全底线,不可篡改)
    soul, _ := fs.ReadFile(p.fs, "system_prompts/soul.md")
    promptBuilder.Write(soul)

    // 2. 注入人设性格(如语气、角色扮演约束)
    identity, _ := fs.ReadFile(p.fs, "system_prompts/identity.md")
    promptBuilder.WriteString("\n\n<identity>\n")
    promptBuilder.Write(identity)
    promptBuilder.WriteString("\n</identity>\n")

    // 3. 注入用户专属的长期记忆(从数据库加载的用户习惯配置)
    userPrefs, err := fetchUserMemoryFromDB(userID)
    if err == nil {
        promptBuilder.WriteString("\n\n<user_memory>\n")
        promptBuilder.WriteString(userPrefs)
        promptBuilder.WriteString("\n</user_memory>\n")
    }

    return promptBuilder.String(), nil
}
在运行过程中,一旦用户下达“以后请用单引号而不是双引号”的指令,Agent 会触发内部工具 update_user_memory,将该偏好持久化。下一次对话时,PersonaLoader 会将更新后的 JSON 记忆重新编译进 Prompt,在工程层面上赋予了 Agent “学习与成长”的能力。
14.6.3 记忆提取与冲突解决
上一节解决了“读取记忆”的问题,但写入端同样关键:Agent 如何从对话中自动识别出“这是一条值得记住的偏好”?答案是将记忆写入建模为一个内部工具。当用户说“以后用单引号别用双引号”时,模型自主调用 update_user_memory 工具,传入结构化的键值对(如 quote_style: single),由工具侧完成持久化:
go
type UpdateMemoryArgs struct {
    Key   string `json:"key"`
    Value string `json:"value"`
}

func (t *UpdateMemoryTool) Execute(ctx context.Context, args []byte) (domain.ToolResult, error) {
    var a UpdateMemoryArgs
    json.Unmarshal(args, &a)
    out, err := t.store.Upsert(ctx, a.Key, a.Value)
    if err != nil {
        return domain.ToolResult{}, err
    }
    return domain.ToolResult{Output: out}, nil
}
冲突解决遵循“后写胜出 + 时间戳审计”策略:store.Upsert 覆盖旧值的同时记录 updated_at 时间戳。如果同一个 Key 在 7 天内被覆盖两次(如上周写入 indent: tab,本周覆盖为 indent: spaces_4),系统可选择在下次对话开头生成一条提示:“检测到你的缩进偏好近期变更,当前为 4 空格缩进。”,这种温和的确认机制避免了静默覆盖带来的困惑,同时不打断主流程。
14.7 分布式与高可用部署
个性化记忆需要持久化存储,而一旦存储和状态跨越了单机边界,分布式环境下的新痛点就接踵而至。如果只是将 Agent 引擎打包进 Docker 容器并丢给 Kubernetes,那属于通用的后端运维范畴。但 Agent 引擎在分布式环境下,会遇到传统 Web 服务几乎不会遇到的特有痛点。传统 Web 请求是无状态且短生命周期的(通常在几百毫秒内返回),而 Agent Loop 是强状态、长生命周期且充满副作用的(一个任务可能持续运行数小时,中间包含多次文件读写和等待人类审批)。
从单机走向生产集群,Agent 状态机必须适应分布式环境。
14.7.1 运行环境亲和性与粘性路由
在单机环境下,Agent 的推理引擎和执行沙箱在同一台物理机上,共享同一个本地文件系统。
在分布式环境下,如果用户的第一个请求被路由到节点 A,Agent 在节点 A 的沙箱里执行了 git clone 和 npm install。当 Agent 进入下一轮思考并决定修改文件时,如果负载均衡将请求路由到了节点 B,节点 B 上根本没有这个代码仓库,工具执行就会报错。
解决这一痛点的关键在于控制面与数据面分离。推理引擎(控制面)可以是无状态的、随意漂移的,但工具执行(数据面)必须通过 RPC 路由到挂载了该用户专属工作区的特定沙箱节点上。在 Kubernetes 中,通常通过 StatefulSet 配合持久化卷(PVC)为每个活跃会话分配专属的执行 Pod,并在 API 网关层根据 Session ID 实现粘性路由。
14.7.2 长生命周期状态机的跨节点恢复
假设一个 Agent 正在执行一个包含 20 步的复杂重构任务,执行到第 15 步时,所在的物理节点发生 OOM 崩溃。对于普通 HTTP 服务,节点崩溃大不了给用户返回 502,让用户重试。但 Agent 任务成本极高(可能已经消耗了 5 万 Token 和 10 分钟时间),直接失败是不可接受的。
引擎需要将每一轮的 Thought、Action 和 Observation 作为事件追加到分布式存储(如 Redis Streams 或 Kafka)中。当节点崩溃时,监控系统在另一个节点重新拉起该 Agent,重放历史事件,使其从第 15 步精确恢复,而不是从头开始。这要求我们此前实现的 AgentContext 具备从事件流重建状态的能力。
14.7.3 异步人机协同的分布式唤醒
在安全防线一章中,我们用 Go 的 Channel 实现了挂起和恢复。但这要求“发起审批”和“接收审批结果”必须在同一个进程内。
在真实的 SaaS 场景中,Agent 发现高危操作,向用户的飞书或 Slack 推送了一条审批卡片,然后挂起。用户去开会了,3 个小时后才点击“同意”。此时,原本运行该 Agent 的 Pod 可能早就被 K8s 缩容销毁了。
分布式挂起需要替代内存 Channel。Agent 发起审批后,将自身状态序列化到数据库,并主动结束进程释放资源(休眠)。当 Webhook 接收到 IM 软件的“同意”回调时,网关根据 Session ID 从数据库唤醒 Agent 状态,在任意可用节点上重建上下文,并驱动状态机进入下一步。
14.7.4 多智能体通信的分布式演进
前述多智能体协同是基于进程内的函数调用和内存事件总线实现的。如果业务演进到跨团队协作(例如前端团队的 Agent 需要调用后端团队的 Agent),它们必然运行在不同的微服务甚至不同的集群中。
内存的 Event Bus 必须升级为基于 MQ 的信箱(Mailbox)机制。跨服务的 Agent-to-Agent (A2A)协议握手与任务状态同步成为刚需。每个 Agent 暴露标准的 RPC 接口接收 Task,通过 MQ 异步推送进度,最终将 Multi-Agent 问题转化为经典的分布式 Saga 事务问题。
14.8 多模态与屏幕操控演进
部署架构就绪之后,Agent 的感知能力也需要升级——从纯文本扩展到视觉多模态。全书的输入输出抽象完全建立在“文本(Text)”和“代码(Code)”之上。但在真实的物理世界中,许多任务无法通过纯文本的 API 或 CLI 工具完成。例如,测试一个桌面客户端的 UI 渲染是否正确,或者操作一个没有开放 API 的老旧内部财务系统。
随着 Anthropic 推出屏幕操控能力,Agent 的演进方向正在从“文本态”向“多模态视觉态”跨越。
14.8.1 视觉反馈循环
在传统的 RunLoop 中,Observation 是文本(如 ls 的输出或 grep 的结果)。而在屏幕操控模式下,Observation 变成了屏幕截图。
go
// 传统文本 Tool
type BashTool struct {}
func (t *BashTool) Execute(ctx context.Context, args []byte) (ToolResult, error) {
    // 返回 stdout 文本
}

// 多模态视觉 Tool
type ComputerUseTool struct {}
func (t *ComputerUseTool) Execute(ctx context.Context, args []byte) (ToolResult, error) {
    // 1. 解析动作:MouseClick(x, y), TypeText("hello")
    // 2. 调用操作系统无障碍 API 执行动作
    // 3. 截取最新屏幕,转换为 Base64
    // 4. 返回包含 image_url 的多模态 ToolResult
}
Agent 的循环变成了:看屏幕(获取截图) -> 思考(定位目标坐标) -> 行动(移动鼠标/点击) -> 再看屏幕(验证点击结果)。
14.8.2 视觉状态折叠的挑战
引入屏幕操控后,Agent 引擎面临的最大工程挑战是多模态上下文爆炸。
一张 1080p 的屏幕截图,在旗舰 Sonnet 模型中大约消耗 1000~2000 Token (具体取决于模型版本与分辨率,以官方文档为准)。如果 Agent 执行了 50 步点击操作,上下文中就会堆积 50 张历史截图,不仅迅速打穿 Token 预算,还会导致极高的 API 延迟和成本。
我们此前构建的 deepCompact(文本摘要)机制对此完全失效,你无法用廉价文本模型去“摘要” 50 张图片。
未来的架构演进方向:
- 关键帧保留:在 Rolling Buffer 中,只保留“动作发生前后”的相邻两帧截图,中间的过渡帧直接丢弃。
- 视觉差分:在本地引擎中运行一个轻量级的 CV 模型,对比前后两帧截图。如果 UI 没有实质性变化(例如只是鼠标移动了位置),则不向大模型发送新截图,而是复用上一帧的缓存。
- 语义降维:使用本地的小型 VLM (如 Qwen-VL)将历史屏幕截图转换为 UI 树的文本描述(如
[Button: Submit, location: 100,200]),用文本替换图片存入历史上下文,仅保留最新一帧的高清原图供大模型决策。
从模型路由到多模态,本节前面的每一处演进,拓宽的都是单个循环的能力边界——让它接入更多模型、感知更多模态。但当真实业务需要多个这样的循环并行协作、条件汇合、失败回环时,仅靠在单循环内堆叠分支便再难驾驭。至此,演进的焦点必须从"把一个循环做强"转向"把多个循环织成网",编排层的问题就此浮出水面。
14.9 从循环到图编排:编排层的下一跳
前面我们花了大量篇幅打磨单个循环的内核:状态机、工具箱、记忆压缩、HITL、可观测。但当业务流程需要“并行分支 → 条件扇入 → 回环迭代”时,在单一循环内部堆叠 if-else 会迅速失控。本节把视野从节点内的循环,抬升到节点间的图编排——这也是本书副线 图工程(Graph Engineering) 的落点:循环工程把单个节点做扎实,图工程再把多个循环织成可验证的拓扑。
14.9.1 为何需要图编排
单个循环擅长的是“在一条线上持续纠偏”:Think → Act → Observe,直到目标达成或熔断。现实业务往往不是一条线,而是一张网:审批要扇出等待、多专家要并行出发再扇入、质检不过要回环重试。这些跨循环的拓扑控制,若继续赌模型“想起来”下一步该往哪走,编排逻辑就会重新退回提示词里的软约束。
图编排要解决的,正是把“路由谁来跑、什么条件汇合、哪条路径可以回头”从概率推理中抽离,交还给工程侧的确定性代码。
14.9.2 循环作为图中的节点
图工程(Graph Engineering)把一个完整的循环降维为 DAG 中的一个节点,用拓扑排序与条件边编排多个循环之间的协作。节点内部仍是本书前面各章实现的 Agent Loop;节点之间则是显式的边:成功边、失败边、人工批准边、超时边。
值得强调的是,图并非循环的替代品,而是循环能力的乘数。一个图的健壮性上限,取决于其中最弱的那个节点循环的工程质量——这也是本书选择自底向上、先把单个循环做扎实的根本理由。
14.9.3 典型拓扑:扇出、扇入与回环
三类拓扑覆盖了大多数生产编排:
- 扇出:同一输入同时触发多个专用循环(如安全扫描与风格检查并行)。
- 扇入:多个分支完成后按“全部成功 / 任一成功 / 法定人数”汇合,再进入下一节点。
- 回环(Cycle with budget):质检失败时回到修复节点,但必须绑定最大重试、成本上限与人工升级路径,避免图本身变成死循环。
与第十章多智能体协同的差别在于:多智能体解决的是“同一会话内谁说话”;图编排解决的是“跨会话、跨阶段的流程骨架写在哪里”。前者仍可嵌在图的某一个节点里。
14.9.4 与本书主线的关系
本书主体完成的是 Loop Engineering:驱动器、状态机、工具管道、记忆压缩、HITL、可观测与终端实战。本章把循环接入业务隔离、预检、多端通道与多模态之后,自然碰到编排层的天花板——那时需要的不是再写一个更胖的 while,而是把循环登记为图中的节点。
若只掌握图编排而不懂节点内循环,系统会在每个节点上重复 Demo 级缺陷;若只打磨循环而不引入图,复杂业务流程会再次沉回提示词。两者互补:循环负责节点内自治,图负责节点间确定性路由。
从 CLI 到后台服务,从单体到多智能体,再从纯文本到多模态视觉控制,循环工程的核心状态机模型并未改变,但其挂载的“感官”与“肢体”仍在扩展。掌握底层循环的传动原理,再按需引入图编排,才能在演进中握住架构准星。
循环与图的形态会随模型能力、部署边界和交互模态持续演化;不变的是工程纪律:把不确定的推理链,接入可验证、可中断、可观测的执行闭环。
本节勾勒了图编排的方向与基本拓扑。下一章将展开有环有向图的完整工程实现——回环控制、设计模式卡片、过度工程化陷阱,以及一个可运行的最小图调度器骨架。