主题
第 2 章:解构 Claude Code 的架构设计
:::
阅读建议:如果时间有限,聚焦每节开头的“为什么”和“总之”段落,即可把握 Claude Code 的架构全貌;TypeScript 伪代码细节、源码路径等可按需深入。
:::
在外界看来,大模型 Agent 往往被赋予过多神秘色彩。许多刚入门的开发者以为,写 Agent 就是用 Python 写一个 while 循环,把提示词交给 OpenAI 或 Anthropic 的 API,解析出 JSON,再用 exec 执行一下系统命令。
通过 Anthropic 的官方文档、公开产品说明与可观察运行行为,可以看到 Claude Code 需要协调状态、工具、权限、上下文与错误恢复。这些能力共同构成了本章的架构分析框架。
下面从任务拆解、并发调度和上下文压缩三个方面展开。为了把控制流讲清楚,下面将关键角色抽象为若干函数和伪代码,并在后续章节中对应到 Go 实现。
2.1 核心循环体与状态机
Agent 的心脏不是模型本身,而是驱动模型持续运转的循环引擎。Claude Code 的核心循环位于 src/query.ts 中的 queryLoop() 异步生成器函数——它在单次会话内不断推进“推理→工具调用→状态更新”的闭环。本节先从一个常见的反模式(递归调用)出发,说明为什么工业级 Agent 必须采用非递归的状态机设计,再逐层拆解 queryLoop 的四阶段骨架。
2.1.1 递归的局限性
常见误区:在处理“模型生成工具调用 -> 执行工具 -> 模型根据结果再生成”的链路时,开发者很容易写出如下的伪代码:
python
def run_agent(messages):
    response = call_llm(messages)
    if response.has_tool_call():
        result = execute_tool(response.tool_call)
        messages.append(result)
        return run_agent(messages) # 致命的递归
    return response
这种做法在处理简单的单次对话时没问题。但是,当 Agent 需要自主重构一个拥有几十个文件的模块,连续执行数百次“读取-思考-修改-编译-报错-再修改”的动作时,这种做法会带来两个严重问题:
1)调用栈溢出:递归过深会直接导致程序崩溃。
2)状态丢失与内存泄漏:一旦中途某个网络请求超时或触发重试,深层嵌套的回调和局部变量极难清理,整个状态链路可能迅速失控。
Claude Code 的做法是彻底绕开递归。它的循环驱动引擎不是一个传统的 AgentRunner 类,而是位于 src/query.ts 中的异步生成器函数 queryLoop()。这个函数采用非递归的**有限状态机(Finite State Machine, FSM)**设计:Agent 在任意时刻只处于一个明确阶段,通过预定义事件触发状态跃迁,用确定性流转规则约束大模型的概率输出,防止任务失控或无限循环。
为什么选择生成器,而不是普通的 while 循环或递归?区别在于三点。第一,调用栈恒定:递归把"下一回合"建模为新的函数调用,调用深度与 Agent 步数线性绑定,错误恢复必须沿调用链回溯;生成器把"下一回合"建模为同一次调用的循环迭代,调用栈深度恒为 $O(1)$,上文所述的栈溢出和状态丢失问题在此消失。第二,双向通信:递归函数只能单向返回值,而生成器天然支持外层通过 generator.next(injectedValue) 向循环体内注入外部事件(如用户打断、HITL 授权结果),这正是 Agent 需要的"可插入中断"能力。第三,观测与控制分离:async function* 中的 yield 只负责把流式 Token 或中间事件"透传"给外层消费者,不参与状态跃迁决策;真正的状态推进发生在 while(true) 循环体末尾的 state = { ... } 赋值处。yield 是观测点,state.transition 是控制点,二者各管一事。
理解了生成器的选型理由,再来看它如何与状态机配合。JavaScript 生成器在每次 yield 处会保存完整的执行上下文(局部变量、指令指针),相当于把"线程栈帧"冻结在堆上。当外层调用者再次 next() 时,生成器从冻结点精确恢复——这与显式状态机中 switch(state.phase) 的写法等价,但省去了手工维护 phase 枚举和跳转表的样板代码。queryLoop 的"暂停"有两种语义:流式暂停(模型正在吐 Token,前端逐帧消费)和回合暂停(一整轮推理完成,等待外部事件),二者共享同一个生成器实例,因此 Suspend & Resume 只需序列化 state 对象即可,无需重建调用栈。
总之,对于需要运行数百步、中途多次挂起/恢复的 Agent,"生成器 + 状态对象"的组合是比递归更优的工程选择——扁平化控制流解决了栈溢出和状态丢失,可注入事件解决了外部打断,yield 与 state 的分工则让流式输出和状态推进互不干扰。下面来看 queryLoop 的具体结构。
2.1.2 状态机的结构拆解
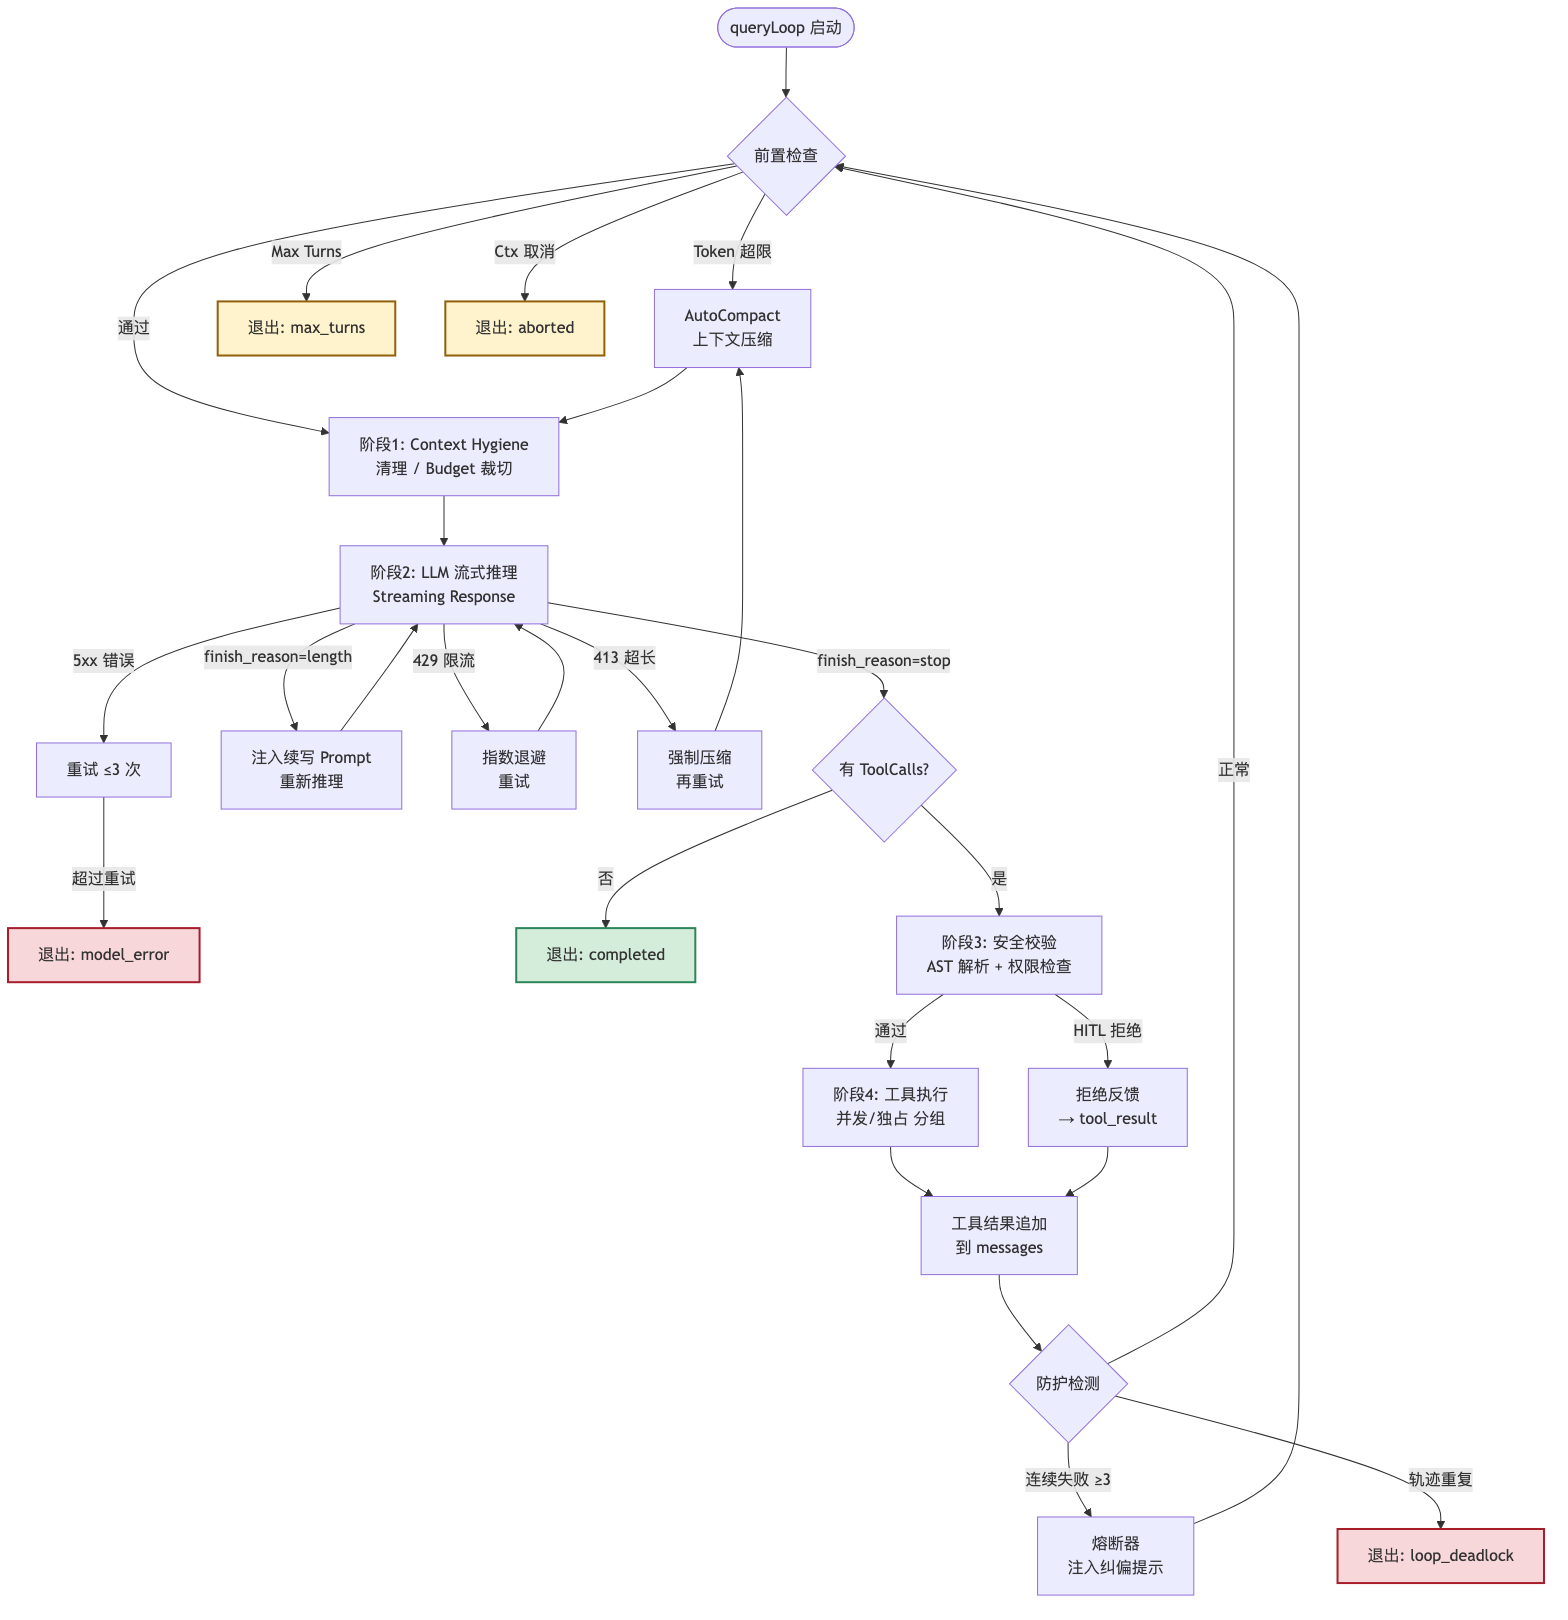
Claude Code 的核心结构是一个巨大的 while(true) 循环,在单次用户交互内不断推进状态。它的源码骨架可以简化为以下四个阶段:
typescript
// 用于说明核心流转机制的概念伪代码
async function* queryLoop(params) {
  // 1. 唯一的可变状态载体,类似于线程的“栈帧”
  let state = {
    messages: params.messages,
    toolUseContext: params.toolUseContext,
    turnCount: 1,
    transition: undefined
  };

  while (true) {
    // 解构当前状态
    let { messages, toolUseContext, turnCount } = state;

    // --- 阶段一:上下文卫生清理 (Context Hygiene) ---
    // 在请求 LLM 前,执行一套严密的“压缩管道”(Compaction Stack)
    messages = applyToolResultBudget(messages); // 裁切超长工具输出
    messages = snipCompactIfNeeded(messages);   // 丢弃早期无效记录
    messages = microcompact(messages);          // 原地压缩冗余数据
    let compactionResult = autocompact(messages); // 终极防线:自动生成历史摘要

    // --- 阶段二:LLM 流式调用与并发工具执行 ---
    let assistantMessages = [];
    let toolResults = [];
    let toolUseBlocks = [];

    // 发起大模型流式请求
    for await (const msg of callModel(messages)) {
      yield msg; // 将流式 token 实时吐给前端界面

      if (msg.hasToolUse()) {
        toolUseBlocks.push(msg.toolBlock);
        // 【工程神来之笔】:不等流式输出结束,边生成边执行!
        streamingToolExecutor.addTool(msg.toolBlock);
      }
    }

    if (toolUseBlocks.length === 0) {
      // 模型没有调用任何工具,任务结束
      return { reason: 'completed' };
    }

    // 等待所有工具执行完毕,收集结果
    toolResults = await executeAllTools(streamingToolExecutor);

    // --- 阶段三:安全校验与兜底恢复 ---
    if (isTokenLimitHit()) {
      // 触碰 Token 极限,业务降级而不是直接 Panic
      state = escalateTokenLimitAndRetry(state);
      continue;
    }

    if (maxTurnsExceeded(turnCount)) {
      return { reason: 'max_turns' }; // 防止死循环魔咒
    }

    // --- 阶段四:状态跃迁 (State Transition) ---
    // 将新产生的内容并入主时间线,推进状态,进入下一次循环
    state = {
      messages: [...messages, ...assistantMessages, ...toolResults],
      toolUseContext: updatedContext,
      turnCount: turnCount + 1,
      transition: { reason: 'next_turn' } // 明确记录流转原因
    };
    // continue 回到 while(true) 顶部
  }
}
queryLoop 的核心循环流程如图 2-1 所示。
Compaction Stack 四函数的执行顺序与判定逻辑:queryLoop 在阶段一“上下文卫生”中依次调用以下四个函数。它们并非随意排列,而是按破坏程度从低到高、可逆性从高到低递进执行,每一函数的输入输出都是 Message[],输出作为下一函数的输入。表 2-1 给出了对照关系。
表 2-1 压缩栈四函数对照
| 函数 | 输入判定 | 输出变化 | 核心规则 |
|---|---|---|---|
applyToolResultBudget | 扫描最近一轮的 tool_result 块 | 超长输出被 head/tail 截断,中间写入磁盘 | 只动体积,不动结构 |
snipCompactIfNeeded | 遍历历史,标记“已纠正的探索性失败” | 被 snip 的消息从 API 视图中移除,UI 保留 | 只动无效片段,保留 assistant 骨架 |
microcompact | 扫描重复的 tool_use + tool_result 对 | 内容实体抽离至 ContentReplacementState,原地留占位符 | 保留动作链,抽空 payload |
autocompact | 累计 Token ≥ effectiveContextWindow - 13_000 | 用 [Summary] 替换边界前的全部历史 | 不可逆的最后一道重写 |
为何必须按此顺序? 若先执行 autocompact,会把尚可通过 snip/microcompact 无损回收的 Token 一并摘要化,既浪费一次 LLM 调用,又可能丢失 snip 能精确保留的结构化骨架。若 microcompact 排在 applyToolResultBudget 之前,超长工具输出会在抽离前撑爆 Token 计数,导致 autocompact 误触发。这条管道的逻辑是:先用廉价规则剪枝,再用中等成本原地压缩,最后才动用 LLM 做有损摘要,每一步都在为下一步争取更大的缓冲空间。值得注意的是,这一顺序假设 tool_result 体积是主要膨胀源;若对话以大量 assistant 推理文本为主,前几道防线可能收效有限,autocompact 仍会频繁触发。
2.1.3 核心设计要点
仔细剖析这段循环,可以发现以下几个值得关注的工程设计思路。
- 流式并发
通常的流程是等 LLM 完整输出所有的 JSON 工具参数后,才开始执行 exec。但 Claude Code 引入了 StreamingToolExecutor:只要流式返回的 JSON 块中,某一个工具的参数一经解析完毕,后台就会立刻触发执行,即便此时模型还在吐出下一个工具的参数。这种将“网络/磁盘 I/O”与“大模型推理”重叠的并发设计,显著降低了 Agent 的思考-行动延迟。
- State 对象不可变
循环体内虽然使用了 let state,但每一次循环结束时,都是通过 state = { ...oldState, ...newUpdates } 来完全覆盖旧状态。这种设计极大地简化了 Bug 排查,你只要打印出每一轮的 state.transition,就能清晰地看到 Agent 是如何一步步思考、碰壁、重试和纠错的。这也为后续实现 Agent 的“挂起与状态恢复”打下了坚实基础。
哪些字段必须是不可变的? 严格来说,messages 数组及其内部每个 Message 对象的 content 字段是硬约束,它们直接参与 API 请求的 SHA 前缀计算,任何原地修改都会使 Prompt Cache 失效。toolUseContext(工具定义、权限策略)和 systemPrompt 同理。相比之下,turnCount、transition 等元数据字段可以随轮次覆盖,因为它们不进入 API payload。源码中的纪律是:发给 API 的是 frozen snapshot,UI 渲染用的是 clone + backfill,两套视图,同一数据源。
与 Prompt Cache 字节一致的联动机制:Anthropic 的 Prompt Cache 按请求前缀的字节序列做哈希匹配,而不是语义等价。因此 state.messages 一旦在某轮被 append 后,历史前缀的字节序列必须永不改变,哪怕只是给某条 tool_result 补全一个文件路径,也会使整个前缀 cache miss。Immutable-ish 设计确保:Compaction 产出的是新数组(messages = compactFn(oldMessages)),旧数组引用仍可被 UI 层持有用于滚动展示,而 API 层始终拿到的是“从创世到当前”的不可变前缀链。这就是为什么 Claude Code 宁可克隆对象做 UI 回填,也绝不 messages[i].content += “...” 的根本原因。
escalateTokenLimitAndRetry 的降级与重试路径: 当模型输出触碰 max_output_tokens 上限(表现为流式中断、stop_reason: max_tokens)时,此函数被触发。它的降级策略不是换模型或删消息,而是缩输出上限的反向操作,注入一条隐藏的 user 消息(“Output token limit hit. Resume directly — no apology...”),要求模型从断点处继续输出,并将已生成的 assistant 片段保留在 messages 中。重试条件:turnCount 未达 maxTurns,且连续 escalate 次数未超内部阈值(通常 ≤ 2 次)。失败路径:若 escalate 后仍触顶,或 API 返回 prompt_too_long,则 transition.reason 设为 max_output_tokens_escalate 或 blocking_limit,循环优雅退出,由前端提示用户清理上下文,绝不无限重试烧钱。
- 异常捕获与拦截流转
在 queryLoop 中,如果大模型异常返回了非法的 JSON,或者调用 Bash 报错(例如命令不存在),程序绝对不会抛出异常中断运行。它会将错误信息包装成一段伪造的系统提示(如 <tool_result is_error=“true”>Command not found</tool_result>),将其压入 toolResults 中,然后通过 continue 开启下一轮循环。大模型收到自己“出错”的证据后,会触发自愈机制,自动尝试更换命令。
总之,若把 queryLoop 放到一次连续 200 步的重构任务里观察,它约束的不是模型“想说什么”,而是“每一轮之后系统还能不能继续运转”,调用栈不爆、Token 不越界、工具失败不中断主循环。Compaction 会丢细节,Immutable 状态会增加克隆开销;这一选择意味着用工程纪律换取长任务的可续跑性。后续章节将用 Go 的 Goroutine 与 Context,复刻这一核心循环。
2.2 主控调度模式
上一节拆解的 queryLoop 解决了单 Agent 如何在数百步内稳健运转的问题。但当用户下达“帮我重构整个认证模块”这类跨文件、跨职责的复杂指令时,把所有工具和全部上下文塞给同一个循环,往往会让推理质量迅速下降。多智能体协作由此成为下一层架构选择。
在主流的开源项目中(例如早期的 AutoGPT),开发者通常会将系统设计成一个拥有“上帝权限”的全能单体 Agent:给它一个提示词,赋予它 Bash、文件读写、网络请求等所有工具,期望它能一口气完成整个项目。
然而,在处理真实的工业级复杂需求(如“帮我重构整个鉴权模块,并补充单元测试”)时,单体 Agent 往往会在长达几十步的操作中迷失目标。探索日志一旦堆到第 30 轮,模型开始重复已试过的修复方案,注意力被噪声占满,而不是任务本身。
Claude Code 给出的核心解法是:主控模式(Coordinator Mode)。通过分析 src/coordinator/coordinatorMode.ts 的源码,可以看到一套较为清晰的多智能体通信与权限分离架构。
2.2.1 主控权限的边界
值得注意的是,开启 Coordinator 模式后,与你对话的主控(Leader)Agent 本身不具备执行 Bash 或直接编辑文件的权限。它能使用的核心工具只有几个:
Agent:派生一个新的子智能体(Worker)。SendMessage:给已存在的子智能体发送消息以继续任务。TaskStop:强行终止某个子智能体。
这就好比一个总指挥:他自己不亲自动手,只负责阅读需求、拆解任务、派发工作,最后汇总结果。
2.2.2 上下文污染与隔离策略
总指挥在派发任务时,面临着一个核心的上下文抉择。在 Claude Code 的系统提示词中,明确定义了两种流转机制:
- 派生:创建全新的 Worker。
如果主控需要探查一段新代码,或者需要一个新的“测试员”去验证刚才写好的代码,它会调用 Agent({ subagent_type: “worker”, prompt: “...” })。 这个新的 Worker 会带着完全干净的上下文启动。为什么这么做?因为如果让同一个 Agent 先盲目探索找报错,再写代码,它之前探索阶段产生的大量冗余信息和错误尝试会严重污染它的推理链路。干净的上下文能让 Worker 保持更好的专注度。
- 续跑:复用已有的 Worker。
如果 Worker 刚刚探明了 Auth 模块的源码结构并上报了位置,主控想要让它接着修复,就会调用 SendMessage({ to: “agent-a1b”, message: “就在你刚才找到的 validate.ts 里面加个非空判断...” })。这能有效复用该 Worker 已积累的局部代码上下文。
派生与续跑的自动决策规则:主控 Agent 并非随机选择,而是遵循系统提示词中嵌入的决策树。
(1) 任务目标与已有 Worker 的 task-id 和局部上下文强相关(同一文件、同一 Bug、同一模块的后续步骤)时,选择续跑。 (2) 任务需要全新视角(探索未知目录、独立验证、并行调查不同子系统)时,选择派生。 (3) 已有 Worker 处于 completed 或 failed 终态且需全新尝试时,派生新的 Worker,旧 Worker 保留在 registry 中供审计。Worker ID 由 messageQueueManager 统一分配,格式为 agent-{shortUuid},主控通过 <task-id> 引用,禁止自行编造 ID,这保证了 SendMessage 的路由确定性。
Worker ID 生命周期管理: 上述决策规则中频繁出现的 Worker ID,在系统内部有严格的生命周期。每个派生的 Worker 在内部 registry 中登记 { id, status, spawnedAt, parentTurn }。主控的 messages 里不携带 Worker 的完整对话历史(避免污染),只保留 <task-notification> 摘要。Worker 完成后 ID 进入 completed 池,可被主控在 Synthesis 阶段引用;若主控调用 TaskStop,ID 标记为 aborted,对应后台协程收到 AbortSignal 终止。这种“轻量 registry + 重 Worker 隔离”的设计,是多 Agent 系统控制 Token 膨胀的关键。
2.2.3 异步交接与消息队列
初学者写多智能体,最容易写成同步阻塞调用:主控调用 Worker -> 主控挂起等待 -> Worker 跑了 5 分钟 -> 网络断了,全线崩溃。
Claude Code 的实现则完全是非阻塞的事件驱动。
- 并行派发 允许主控在一个回合中同时调用多个
Agent工具,例如一边梳理 API 接口,一边寻找测试用例。主控说完“正在为您并行调查……”后,本轮对话直接结束释放,不再阻塞等待。 - 异步投递: 与此同时,Worker 运行在独立的后台进程/协程中。任务完成后,它不会通过返回值唤醒主控,而是向全局消息队列(
messageQueueManager)投递一条消息,内部事件总线由此承接异步交接。
这个消息队列是主控与 Worker 之间唯一的通信通道,其内部结构决定了异步交接的可靠性。messageQueueManager 的底层是一个按 session 隔离的 FIFO 队列(Map<sessionId, PendingNotification[]>),每条 PendingNotification 包含 { taskId, status, summary, result, enqueuedAt }。消费时机:主控的 queryLoop 在每轮循环开头(Compaction 之前)调用 drainPendingNotifications(),将队列中所有消息合并为一条或多条伪造 user 消息注入 messages。这与 Worker 的完成时刻解耦,Worker 可能在主控 sleep 的 5 分钟内完成,消息在队列中等待,直到主控下次被用户唤醒或定时轮转时才被消费。集成点位于 queryLoop 的 Phase 0 (Pre-compaction ingest),确保 Synthesis 发生在 LLM 调用之前,而不是在流式输出中途。
- 伪造的用户通知(
<task-notification>): 当主控的queryLoop再次轮转时,它会读取队列,并收到一段被伪造成用户输入的 XML 消息:
xml
  <task-notification>
    <task-id>agent-a1b</task-id>
    <status>completed</status>
    <summary>Agent "Investigate auth bug" completed</summary>
    <result>Found null pointer in src/auth/validate.ts:42...</result>
  </task-notification>
主控读取到这个 XML 后,进行综合研判,然后再决定是继续指派任务,还是汇总结果汇报给真实的人类用户。
Synthesis 的推理机制: 上述“综合研判”(源码中称为 Synthesis)并不是额外的 LLM 调用,而是同轮推理的一部分。<task-notification> XML 被 drainPendingNotifications() 包装成标准 user role 消息,append 到 messages 末尾,然后主控在同一轮 callModel(messages) 中一并消化。模型看到这段 XML 后,会在 assistant 回复中完成“汇总 Worker 结果 → 决策下一步”的推理链。XML 注入遵循 Anthropic Messages API 格式:{ role: 'user', content: [{ type: 'text', text: '<task-notification>...</task-notification>' }] },与真实用户输入在协议层无差别,这是“伪造用户通知”能够触发正常推理链的原因。
总之,主控从不亲自写代码,Worker 从不直接向用户汇报,这种分工看似绕远,却在 50 步以上的任务里把 Token 膨胀压在了可管理范围内。消息队列让并行派发与异步汇总成为默认路径,而不是特例;但这并非没有代价:Worker 之间的上下文隔离,也意味着跨模块推理需要额外的 Synthesis 轮次。Go 的 Channel 模型与此高度同构,第十章将沿此思路实现 Multi-Agent 事件总线。
2.3 Token 预算与实时压缩
对大模型进行工程化封装时,所有开发者都会面临一个基本约束:上下文窗口(Context Window)是有限的,且随着 Token 填满,单次请求的计费按 Token 线性累加,多轮循环下总成本随上下文膨胀近似线性攀升,推理质量也会明显下降。
如果只是简单地将所有的终端输出、文件读取结果一股脑地塞进 messages 数组里,不出一会儿,程序的内存就会被撑爆,API 会返回上下文超限错误(如 Anthropic 的 prompt_too_long 或 HTTP 413),API 成本也会显著上升。
Claude Code 拒绝了“到达上限就截断最早对话”这种较为粗暴且容易丢失关键逻辑的做法,而是在调用模型前,部署了一条严密的 上下文压缩管道。通过分析 src/query.ts 和 src/services/compact/autoCompact.ts,我们将这个管道拆解为四道防线。
2.3.1 结果预算控制
模型执行 cat package-lock.json 或者运行 npm install 时,终端可能会喷出几万字的无意义日志。
源码对策:
在每一轮循环起手,系统会先通过 applyToolResultBudget() 对刚刚产生的工具调用结果进行强制干预。对于非核心的输出,直接进行强行截断,确保一次工具调用的反馈结果不会失控。这是最外层的防爆止损。
2.3.2 原地瘦身与折叠
随着对话深入,早期的一些探索性动作(比如查错了一个文件、跑错了一次编译)已经没有保留的必要了,但直接删掉又会打断对话的连续性。
源码对策:
- 定点修剪(Snip Compact): 在历史记录中游走,把那些明显无用的、未形成持久化记忆的历史片段切掉(但保留大模型的回复骨架)。
- Microcompact (微缩压缩): 原地压缩历史工具调用的请求体和返回体数据,只保留一个骨架,把内容实体抽离。
- 上下文折叠(Context Collapse): 与上述两项 API 级压缩不同,Context Collapse 属于 UI 层的视图优化,不影响发送给模型的 messages 内容。它将大量闲聊或者重复验证的步骤合并折叠为一个小标题,这也是为什么在使用 Claude Code 时,历史步骤能被归纳为一行概要的原因。
Snip Compact 的判定规则与 UI 投影: “无用”并非语义判断,而是基于结构化模式匹配的确定性规则:(1) 存在 tool_result 且 is_error=true,且后续 N 轮内出现了同工具同目标的成功调用 → 标记为 snippable (2) 纯探索性 Glob/Grep 未产生后续 FileEdit 引用 → snippable (3) 已被写入 MEMORY.md 或触发 AutoCompact 摘要覆盖的内容 → snippable。骨架保留:assistant 消息的 tool_use 块(动作声明)和一条 [snipped] 占位符,删除对应的 tool_result 正文。UI 层通过 projectSnippedView() 做反向投影,完整历史仍在 REPL 的 fullMessages 数组中,API 层拿到的是 snipped 视图,用户在终端滚动时看到的是未 snip 的完整记录,两套数据源通过 message UUID 关联。
Microcompact 的抽离与再取回机制: 被抽离的 tool_use 参数和 tool_result 正文写入进程内的 ContentReplacementState(键为 messageUuid + blockIndex),原地留下形如 [Content compacted. Use tool to retrieve if needed.] 的占位符。模型仍然能看到它曾经调用过某工具(骨架中的 tool_use_id 和工具名不变),因此不会“失忆”重复探索;若模型在后续推理中判断需要原文,可再次调用 Read 或专用 retrieve API,系统从 ContentReplacementState 按 key 取回完整 payload 并作为新的 tool_result 注入,这是一次按需懒加载,而不是永久丢失。
Context Collapse 与 Snip/Microcompact 的边界:Collapse 处理的是连续同类型步骤的聚合(例如 5 轮连续的 lint-fix 循环),触发条件是同一 subagent_type 且 tool 调用模式重复度 ≥ 阈值。合并算法:保留首尾各一条消息,中间替换为一条 synthetic assistant 消息,content 为自动生成的小标题(如 “Fixed 4 lint errors in src/auth/”)。小标题由规则模板 + 首尾 tool_result 的首行摘要拼接,不调用 LLM。与 Snip 的区别:Snip 是删除失败探索;Microcompact 是抽空成功但冗余的 payload;Collapse 是合并仍有价值但过于冗长的连续步骤。三者互不替代,按 Snip → Microcompact → Collapse 顺序执行。如前文所述,Context Collapse 不在每轮 queryLoop 循环中同步触发,而是在子任务边界时异步执行。
2.3.3 自动摘要策略
如果前三道防线都无法阻挡 Token 的暴涨,那么当上下文逼近极限时,系统必须做出断臂求生的抉择。
在 src/services/compact/autoCompact.ts 中,我们看到了严密的数学算计:
typescript
// 缓冲警戒线:提前 13,000 个 Token 介入
export const AUTOCOMPACT_BUFFER_TOKENS = 13_000

// 自动生成摘要的触发阈值 = 模型的最大窗口 - 13000
const autocompactThreshold = effectiveContextWindow - AUTOCOMPACT_BUFFER_TOKENS
effectiveContextWindow 的计算方式: 它不等于模型标称的 200k/1M 窗口,而是 modelMaxContext - reservedOutputTokens - systemPromptTokens - toolDefinitionsTokens。其中 reservedOutputTokens 预留给本轮 assistant 输出(通常 8k~64k),systemPromptTokens 和 toolDefinitionsTokens 从可用输入空间中扣除,因为它们是每轮请求的固定开销。客户端在 Compaction 判定中使用的是输入侧剩余空间,而不是物理窗口总量。这解释了为何 13,000 Token 缓冲是在 effectiveContextWindow 而不是在原始窗口上计算:必须确保 autocompact 触发后,摘要生成本身 + 新一轮推理仍有足够空间,不会“压路机压压路机”。
触发机制:
一旦当前 Token 占用跨越了这个阈值,底层的 queryLoop 就会暂停针对当前任务的推理,而是强制触发一个内部子流程:使用一个廉价、快速的模型,对当前的全局历史对话进行精炼的摘要总结。
执行成功后,系统会用 [Summary] 摘要消息,替换掉之前几万字的对话历史,从而释放出大量上下文空间。
AutoCompact 摘要的 Prompt 结构与边界标记: 摘要子流程使用独立的 系统提示词,核心指令为:“Preserve: (1) 当前任务目标与未完成项 (2) 已修改的文件路径与 diff 摘要 (3) 关键错误信息与解决方案 (4) 用户显式偏好与约束”。输出格式为一条 synthetic user 消息,content 以 [Summary of prior conversation] 开头,后接结构化段落。成功后,系统在 messages 中插入 Compact Boundary Marker ({ type: 'compact_boundary', uuid, timestamp }),边界之前的消息物理保留在数组中(供 UI 审计),但 getMessagesAfterCompactBoundary() 会将其从 API 视图中截断。摘要消息本身成为新历史的起点,后续所有 Snip/Microcompact 只作用于边界之后的消息。
2.3.4 压缩失败的熔断保护
这里有一个初学者极易踩坑的死亡螺旋: 如果当前上下文里塞进了一个无法被摘要的超大二进制文件或超长代码库,导致连 AutoCompact 自己生成的摘要都超过了 Token 上限,会发生什么? 如果没有保护,系统会无限次尝试生成摘要、无限次报错,一晚上就可能消耗数百美元的 API 费用。
源码对策:
Claude Code 实现了一个严厉的熔断器:
typescript
// 源码原话注释:Stop trying autocompact after this many consecutive failures.
// BQ 2026-03-10: 1,279 sessions had 50+ consecutive failures ... wasting ~250K API calls/day globally.
const MAX_CONSECUTIVE_AUTOCOMPACT_FAILURES = 3
只要 AutoCompact 连续失败 3 次,系统就会彻底终止重试,直接把 prompt_too_long 的错误抛给前端,通过人机协同(Human-in-the-Loop, HITL)界面让用户自己去清理环境。
死亡螺旋与熔断器的简化实现: 经典熔断器有 open / half-open / closed 三态;Claude Code 做了极简裁剪:只有 closed (正常重试)和 open (永久停止 autocompact)两态,无 half-open,因为上下文不会在失败后自动缩小,半开探测毫无意义。为何是 3 次? 源码注释给出了真实数据:单次失败可能是网络抖动,2 次可能是摘要模型偶发超长,3 次连续失败在统计上意味着上下文存在不可压缩载荷(如嵌入的巨型 base64),继续重试的边际成功率趋近于零。熔断后系统状态:autocompactDisabled = true 写入 session state,后续轮次跳过 autocompact 直接尝试 API 调用;若仍超限,则 transition.reason = 'prompt_too_long' 退出。恢复路径:仅当用户手动 /clear 或删除超大 attachment 后,新 session 重置计数器,无自动恢复,避免隐性烧钱。
总之,压缩管道把 Token 消耗从“每轮线性堆叠”拉回到可预测区间,但最后一道 autocompact 是不可逆的:摘要一旦写入,原始对话细节只能靠磁盘懒加载找回。熔断器在 3 次失败后放弃,某些会话必须人工 /clear 才能续跑。Compaction 策略的取舍,往往比模型选型更早决定 Agent 能跑 5 步还是 500 步。
上述压缩策略解决了单轮对话内的 Token 膨胀问题。但 Agent 还需要跨轮次甚至跨会话地保存和检索记忆——这是 §2.8 的主题。
2.4 工具执行管道
大模型调用本地工具是 Agent 的核心能力,但也是性能瓶颈的重灾区。传统的执行模式是:等待 LLM 逐步输出所有工具的 JSON 参数 -> 解析 JSON -> 逐个执行工具 -> 将结果合并返回。
Claude Code 认为这种线性的阻塞效率较低。它的流式工具执行器 StreamingToolExecutor(位于 src/services/tools/StreamingToolExecutor.ts)负责在 SSE 流解析过程中并行派发工具——一旦某个工具的 JSON 参数完整闭合,立即提交执行,不等其余工具参数全部生成完毕。下面看它如何降低 IO 延迟。
2.4.1 流水线重叠设计
很多人对流式工具执行有一个误解:以为只要模型吐出了一半的 JSON (比如刚输出 {"file": "src/ ),后台就开始盲猜并执行工具。参数未闭合时盲目执行,可能导致读取错误路径或写入半截文件名,一次误读即可覆盖目标文件的前几行。
真相:
Claude Code 的设计亮点在于重叠执行。当大模型在一个回合中决定调用 3 个工具(比如读取 3 个不同的文件)时:
- 模型开始流式输出,UI 界面上会实时显示正在逐字生成的工具参数。
- 只要第 1 个工具的 JSON 块输出完毕(触发
content_block_stop),StreamingToolExecutor会立刻在后台派发一个执行任务(如读取文件 A)。 - 此时,模型并没有停下。 模型还在继续流式输出第 2 个工具的参数。而第 1 个工具的磁盘/网络 I/O 已经和模型的网络推理时间有效重叠在了一起。
- 当工具 1 执行完毕后,其结果会被暂存。等模型完全输出完毕,所有已完成的工具结果会一并交还给主循环。
Anthropic 流式事件模型与 partial JSON 解析:Claude API 的 SSE 流遵循严格的事件序列:message_start → content_block_start(声明 block 类型为 tool_use)→ 多个 content_block_delta(逐 chunk 追加 JSON 字符串)→ content_block_stop(该 block 闭合)→ ... → message_stop。StreamingToolExecutor 的触发点是 content_block_stop,而不是首个 delta,因为只有 stop 事件才保证 JSON 完整。Partial JSON 解析采用 incremental parser (如 @anthropic-ai/sdk 内置的 JSONParser):每个 delta 追加到 buffer,尝试 JSON.parse;失败则继续等待下一 delta,成功则提取 name、input 字段并 dispatch。这种”边收边 parse、block 闭合即执行“的模式,是多 tool_use 并发重叠的协议层基础。
StreamingToolExecutor 内部调度: 内部维护 Map<tool_use_id, Promise<ToolResult>> 作为任务注册表,以及 completedResults: ToolResult[] 作为完成缓冲区。工具在 content_block_stop 时以 tool_use_id 为键注册异步任务,完成顺序取决于 I/O 而不是注册顺序,读小文件可能先于读大文件返回。主循环在 message_stop 后调用 await Promise.all(registrations.values()),然后按 tool_use_id 在 assistant message 中的出现顺序(非完成顺序)拼回 tool_result 数组,确保与 API 协议的 block 顺序一致。乱序完成的工具结果在 merge 阶段被重新排序,模型看到的 tool_result 顺序始终与 tool_use 声明顺序对齐。
2.4.2 依赖感知与并发调度
并不是所有工具都能无脑并行。StreamingToolExecutor 内部维护了两个队列,它要求每个工具都必须声明自己是否是”并发安全的“(isConcurrencySafe):
- 并发组(Concurrent-safe): 诸如
FileRead(读文件)、Grep(搜索)、WebFetch(网络请求)。它们会被丢进并行队列,10 个文件可以同时读取。 - 独占组(Exclusive): 诸如写入文件、执行
Bash命令。特别是 Bash,因为mkdir test && cd test && npm run build这种操作具有强烈的状态依赖,所以 Bash 被标记为非并发安全,执行时会阻塞其他工具。
isConcurrencySafe 的声明来源与判定理由: 该 flag 是各 Tool 类定义上的静态常量(如 FileReadTool.isConcurrencySafe = true),在工具注册时写入 toolUseContext,运行时不可动态修改。FileWrite 为非安全:并发写同一文件会产生 torn write,且 OS 层无原子 append 保证;Grep/FileRead 为安全:只读操作不 mutate 文件系统状态,POSIX 保证并发读一致性;Bash 为非安全:shell 有 cwd、env、进程表等全局 mutable 状态,cd 影响后续命令。这是操作系统语义层面的判定,而不是业务逻辑猜测。
兄弟工具熔断:
当并发执行多个工具时,如果单纯的读取文件报错了,其他工具会继续执行。但如果是 Bash 工具报错了,StreamingToolExecutor 会触发一个名为 sibling_error 的中断信号,立即终止(Abort)所有还在排队或正在执行的兄弟工具。因为 Bash 的失败往往意味着后续的代码修改或编译失去了意义。
Sibling Cancellation 的 Abort 机制: 每个工具任务在注册时绑定一个共享的 AbortController(同轮 tool batch 共享 signal)。sibling_error 触发时调用 controller.abort(),排队中的任务在 dequeue 时检测 signal 并 skip,运行中的任务(如 subprocess)收到 signal 后 kill 子进程。已完成的工具结果不丢弃,它们已被写入 completedResults,仍会正常返回给模型;被取消的兄弟工具则生成 { is_error: true, content: 'Cancelled due to sibling error' } 的 tool_result,让模型知道”原计划的多步操作被中断“,而不是静默消失。
2.4.3 脚本执行与安全防御
很多教材教你写 Bash 工具时,就是直接 exec(json.command)。但在 Claude Code 中,在调用系统沙箱之前,有一道较为严格的前置防线:AST 失效保护。
在 src/utils/bash/ast.ts 中,系统使用了 Tree-sitter 对大模型生成的 Bash 命令进行词法分析。
- 它的核心哲学是 ”Fail-Closed (默认拒绝)“。
- 如果大模型生成了一个较为复杂的嵌套管道命令,只要 Tree-sitter 遇到了它没有显式加入白名单的节点(Node),它不会尝试去猜,而是直接抛出
'too-complex'的错误,强制把命令交给人类去审核。 - 只有成功提取出明确的
argv结构后,它才会将其放行到下一步的安全策略匹配中。
Tree-sitter 增量解析原理:Tree-sitter 使用 GLR 算法,将 Bash 源码解析为 CST 而不是 AST,保留所有语法细节(包括注释、空白)。解析器由 grammar.js 定义编译为 C 库,Node.js 通过 N-API 绑定调用。Bash grammar 常见节点:command(简单命令)、pipeline(管道链)、redirected_statement(重定向)、subshell(子 shell)、command_substitution($())。遍历匹配算法:DFS .walk CST,对每个节点检查 node.type 是否在 ALLOWED_NODE_TYPES 白名单中;遇 program → pipeline → command → word/string 的标准路径则提取 argv,遇 command_substitution/process_substitution/heredoc 等未白名单节点则 Fail-Closed。
Fail-Closed 白名单与 Sandbox Runtime: 白名单节点示意:command, word, string, pipeline, file_redirect, number;显式拒绝:command_substitution, process_substitution, heredoc, test_expression, arithmetic_expansion。沙箱层在 AST 放行后生效:macOS 使用 sandbox-exec + Seatbelt profile,通过 syscall 过滤限制文件/网络访问;Linux 使用 seccomp-bpf 过滤 + namespace 隔离(mount/pid/network),只允许白名单 syscall (read/write/openat/exit 等)。两层防御串联:AST 保证”命令结构可理解“,沙箱保证”即使结构合法也只能在授权范围内执行“。
AST 把自由文本 Bash 约束为可审计的 argv 结构,沙箱再限制 syscall 范围,两层串联后,误执行的破坏面从”整台机器“收窄到”授权目录内的读写“。但这并非没有代价:复杂管道会被 Fail-Closed 拒绝,用户不得不手动介入,交互节奏因此变慢。
2.5 挂起机制与人机协同
当一个 Agent 具备了修改代码、执行终端命令的权限后,如果不加以约束,它随时可能执行危险操作并造成不可逆的后果。因此,人机协同(HITL)是所有工业级 Agent 框架的标配:系统可自动运行,但在执行高风险操作前须等待人类确认或拒绝。
但 HITL 绝不是简单地在终端里 fmt.Scanln() 阻塞住程序这么简单。Claude Code 实现了完整的”挂起-仲裁-恢复“机制。
2.5.1 挂起与恢复机制
当 Agent 准备执行一个高危命令(例如 npm publish)时,系统是如何暂停执行,并在炫酷的终端 UI (React + Ink)里弹出确认框的?
在 src/hooks/useCanUseTool.tsx 中,我们看到了这样一种模式:把 Promise 当作程序的挂起点。 系统并不会真的 sleep 或者挂起线程,而是让当前正在执行工具的协程去 await 一个 Promise。这个 Promise 只有在人类用户按下 y(允许)或 n(拒绝)时才会被 resolve。
此时:
- Agent 的工具执行流:卡在了
await canUseTool(...)处。 - UI 渲染流:捕捉到了队列中新增的授权请求,在终端画出了一个带颜色和光标的弹窗。
- 大模型流:没有被卡住。它可能还在后台继续流式输出它想说的话。
Promise 挂起点与 Agent Loop 的绑定关系: canUseTool() 返回的 Promise 被工具执行协程(StreamingToolExecutor 内的 async task)await,而不是被 queryLoop 生成器本身 await,这意味着生成器可以在工具挂起期间继续 yield 流式 token。Promise 的 resolve/reject 由 HITL 子系统持有;超时路径:若用户 N 秒无响应,PermissionRequest 自动 reject,生成 { is_error: true, content: 'Permission request timed out' };用户离开路径:session 断开时 AbortController 触发,所有 pending permission Promise 统一 reject,工具协程捕获后返回 error tool_result,queryLoop 通过 continue 进入下一轮而不是 crash。
2.5.2 权限仲裁的多路竞跑
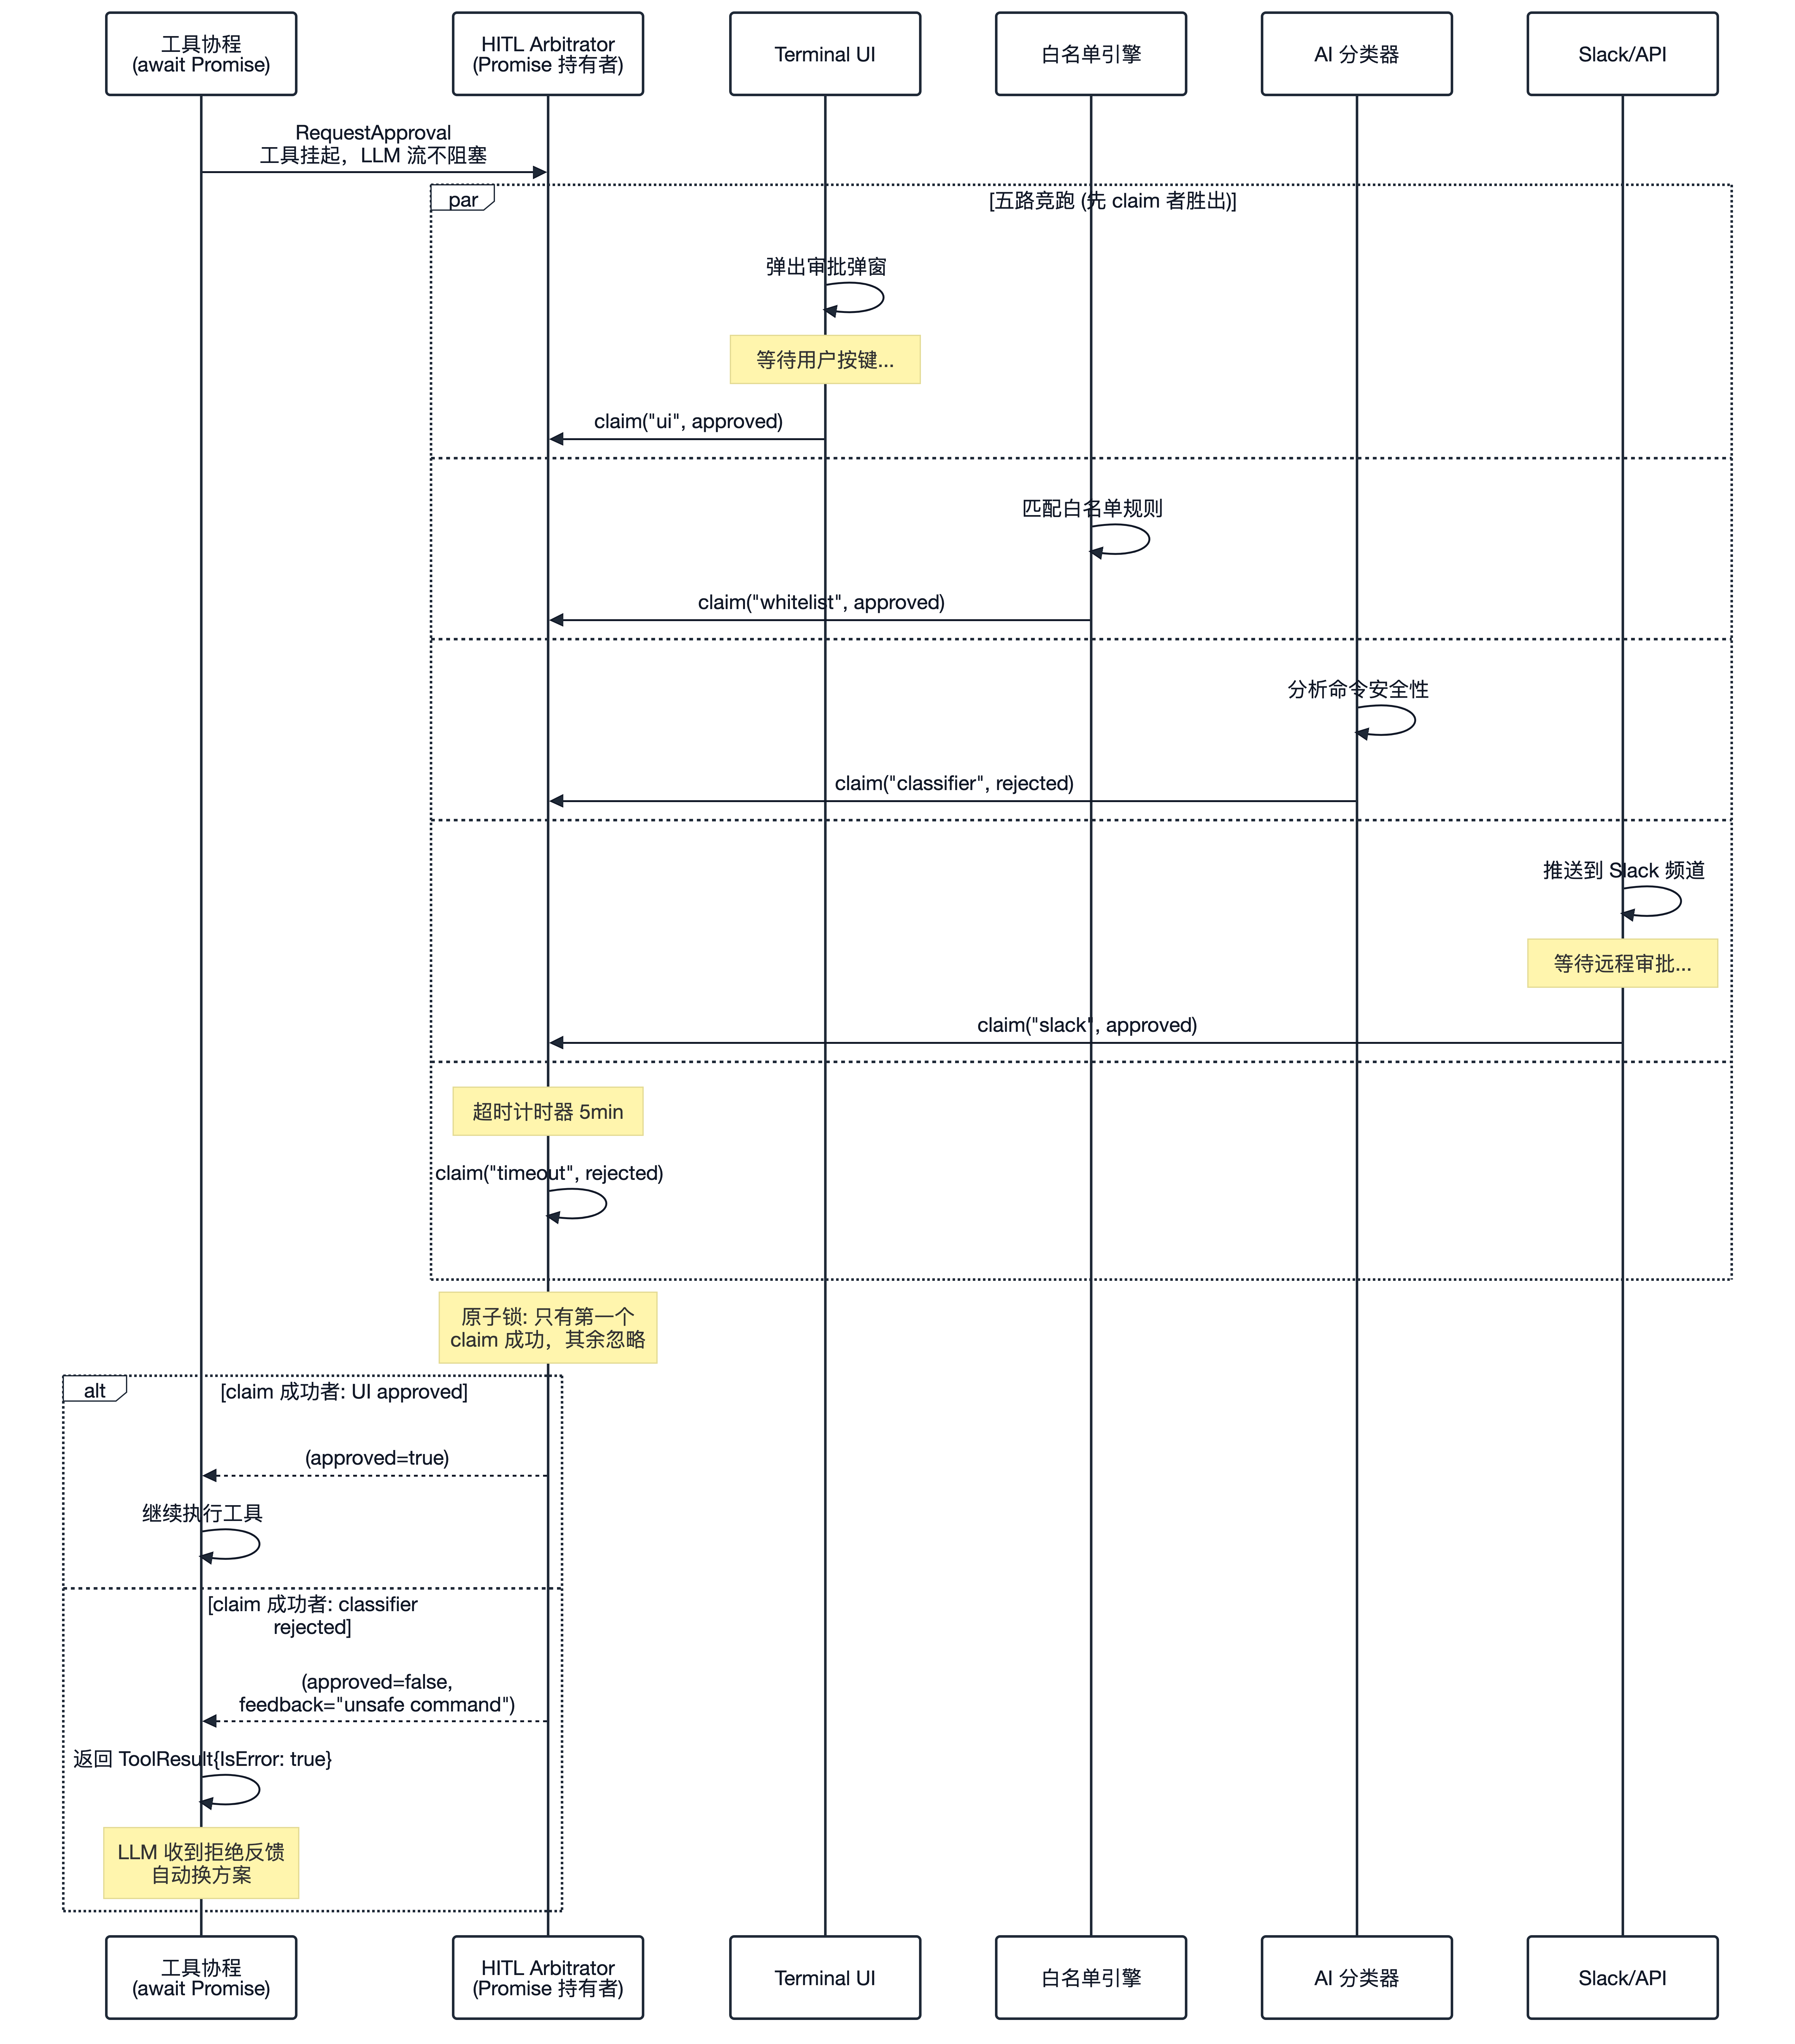
此外,能够 resolve 这个权限 Promise 的,不止是终端键盘。在 interactiveHandler.ts 中,系统开启了一个”五路竞跑“机制:
- 本地 Ink UI:用户在终端敲击键盘。
- 手机/远程频道:用户可能在外出,通过绑定的 Slack 或 Telegram 机器人发送了”同意“。
- 静态权限规则钩子:匹配到了本地项目
settings.json里的白名单规则,异步放行。 - 后台智能分类器:并发运行的一个小型廉价 LLM (分类器)分析命令后,认为绝对安全,异步放行。
- 超时计时器:若在预设时间窗口内(通常 5-10 分钟)没有任何竞跑者 claim 成功,超时自动触发,以防止 Agent 无限期挂起。
后台智能分类器的 Prompt 设计: 分类器使用 Haiku 级模型,prompt 结构为:”Given command: {cmd} and cwd: {cwd}, classify safety. Output JSON only.“ Schema 为 { decision: 'allow' | 'deny' | 'uncertain', confidence: 0.0-1.0, reason: string }。分类器可以产出放行或拒绝的判定,但其角色是加速决策而不是绕过用户,当 decision === 'allow' && confidence >= 0.95 时异步 claim 放行;当判定为高风险(deny 且置信度足够)时同样可 claim 拒绝,但 UI 弹窗仍是兜底,等待用户最终确认。uncertain 或低置信度则静默,等待人工或其他 racer。设计思路:分类器对低风险操作(如 git status、ls)自动加速放行;对高风险判定则仍呈现 UI 弹窗供用户确认,避免 LLM 分类器误杀导致体验灾难。HITL 五路竞跑仲裁与工具协程挂起机制如图 2-2 所示。
竞态条件防范:
为了防止”用户刚点完同意,后台分类器刚好也解析完毕并判定为高风险“这种致命的二次执行冲突,源码引入了一个原子的 claim() 机制。谁先抢到这把锁,谁就主导这次判决,其余的触发全部静默抛弃,若用户弹窗先 claim 了”批准“,分类器的拒绝判定便不生效。
Multi-Racer 的注册与 claim() 原子性: 五路 racer 在 PermissionRequest 创建时统一注册到 racerRegistry,每路是一个 { source, promise, priority } 元组。优先级模型:静态白名单 > 用户显式操作 > 远程频道 > 分类器判定(同优先级内先完成者优先)。claim() 底层是 CAS (Compare-And-Swap) 或 mutex 保护的布尔 flag claimed:第一个调用 claim(decision) 的 racer 将 flag 从 false 设为 true 并 resolve 主 Promise;后续 caller 检测到 flag 已为 true 则 no-op。这保证了”一次 permission request 只有一次判决“,无论多少 racer 并发完成。分类器的首要价值是加速低风险操作的放行;对于高风险判定,最终决策仍交由用户确认。误放行一条 rm -rf 的风险,仍依赖沙箱与 AST 兜底,而不是 HITL 本身。
2.5.3 拒绝后的业务降级
初学者的灾难: 当代码提示用户输入,用户如果强行拒绝或 Ctrl+C,程序往往会直接抛出 panic 或者 Exception,整个 Agent 进程直接崩溃退出。
大厂的应对:
在 Claude Code 中,当用户拒绝授权时,底层流转的不是让程序退出的 Error,而是被包装成了一段业务逻辑反馈:
typescript
// 源码逻辑简化
if (permissionDecision === 'reject') {
  return {
    type: 'tool_result',
    is_error: true,
    content: "User rejected tool use. The user denied your request to run this command."
  }
}
这段带有 is_error=true 标签的文本,被当作工具的正常执行结果,反向喂给了大模型。大模型收到这句话后,非但不会崩溃,反而会立刻触发业务降级,自动向用户道歉并思考:“既然你拒绝我执行发包命令,那不如我只把构建产物打包成 ZIP 让你自己处理如何?”
这种将外部系统的“阻力”甚至“破坏”,转化为大模型上下文一部分的设计,是打造长生命周期 Agent 的不二法门。
2.6 缓存策略与工具箱设计
在大模型应用中,API 的延迟是不可逾越的物理阻碍(一次思考几十秒)。为降低用户感知延迟,Claude Code 在两个方向上做了优化:向内提高 Anthropic Prompt Cache 的命中率,向外在用户未察觉时并行预加载。
2.6.1 提示词缓存策略
Anthropic 的 Prompt Cache 能省下 90% 的上下文费用并极大降低首包延迟。但它的触发条件较为严格:请求的 系统提示词、工具定义、选用模型以及前置对话历史,必须做到字节级的一致。
Prompt Cache 计费模型与前缀稳定性:Anthropic 按三种 Token 计费:input_tokens(全价)、cache_creation_input_tokens(写入缓存,约为 input 的 1.25x,但仅首次)、cache_read_input_tokens(读缓存,约为 input 的 0.1x)。缓存命中要求请求前缀与某次 cache_creation 的 bytes 完全一致,包括 系统提示词、tools JSON、messages 数组中每个 block 的 text。开发者通过 cache_control: { type: 'ephemeral' } 标记 cache breakpoint (通常在 系统提示词 末尾和 messages 倒数第二条处),breakpoint 之前的 prefix 参与哈希。任何原地修改(哪怕一个空格)都使 breakpoint 后的 prefix hash 改变,导致整段 cache miss。字节级不可变因此不是洁癖,而是直接决定 cache_read vs 全价 input 的分界线,一次 miss 在长对话中可能多花数十倍费用。
为了蹭上主对话框(Parent)的庞大缓存,当 Claude Code 派生一个子任务(例如提取记忆、执行一个 /btw 旁支任务)时,源码中设计了一个严格的 CacheSafeParams 结构:
typescript
// 只有严格继承这 5 个参数,子智能体才能复用主智能体的 Cache
export type CacheSafeParams = {
  systemPrompt: SystemPrompt
  userContext: { [k: string]: string }
  systemContext: { [k: string]: string }
  toolUseContext: ToolUseContext
  forkContextMessages: Message[]
}
不可变纪律(详见 2.1.3 节):UI 回填只在 messages 的克隆体上操作,原始数组始终不可变,这是 cache hit 的底层保障。
CacheSafeParams 各字段与 cache key 的关系: 五个字段全部参与 prefix hash:systemPrompt 和 toolUseContext 决定工具和角色定义字节;userContext/systemContext 注入环境变量和项目元数据;forkContextMessages 是子智能体从主智能体分叉时复制的 messages 快照,子智能体不 append 新消息到主数组,而是在 fork 点冻结 prefix,使子智能体的 API 请求与主智能体共享 breakpoint 之前的 cache。任一字段 drift (如子智能体用了不同的 系统提示词)即 cache miss。
2.6.2 异步预加载机制
Agent 最慢的时候,就是它盯着几十万字的代码仓库进行推理的时候。既然模型需要想 10 到 30 秒,Claude Code 会在主模型推理的同时,用廉价辅模型在后台并行检索记忆与技能库,结果以 Attachment 形式在下一轮无缝注入,即“幽灵预加载”。从终端启动起,凭证读取、历史加载等 I/O 亦采用同样的并行预加载策略。双轨检索的 Manifest 结构、匹配逻辑与注入时机详见 2.8.2 节。
2.6.3 核心工具箱设计
通过解剖 src/tools.ts,可以看到 Claude Code 为大模型配备了较为全面且层级分明的工具箱。这些工具并非简单地全部扔给大模型,而是根据当前模式(如主控模式、REPL 模式)动态过滤的。
1. 基础系统交互层
这是赋予 Agent 改变物理世界能力的最底层工具:
BashTool:一切操作的核心。带 AST 防弹解析和系统沙箱隔离的命令执行器。FileReadTool/FileWriteTool/FileEditTool:文件三剑客。大模型极不擅长用sed或awk编辑代码,因此提供专门的编辑工具(利用搜索-替换块机制)能大幅降低修改出错率。
FileEditTool 搜索-替换块机制: 块格式为 <<<<<<< SEARCH\n{exact_or_fuzzy_match}\n=======\n{replacement}\n>>>>>>> REPLACE,一次调用可包含多个块。模糊匹配策略:(1) 精确匹配优先 (2) 失败则 trim 首尾空白后重试 (3) 再失败则忽略缩进差异(统一 dedent 后比较) (4) 仍失败则 Levenshtein 距离 ≤ 阈值时警告并请求确认。与 unified diff 的取舍:diff 适合批量行级变更但要求精确 line number,模型常算错行号;search-replace 块锚定内容而不是行号,对 LLM 更友好,且便于 HITL 展示“改前/改后”对比。代价是无法表达“删除空行”等纯结构性操作,需 fallback 到 FileWrite。
GlobTool/GrepTool:精准的雷达。寻找特定文件和全文搜索。源码中有一个工程细节:如果用户的系统环境中已经自带了ugrep或bfs(更快的底层工具),Claude 甚至会自动绕过这些上层封装,直接调用底层命令以换取更高速度。
2. 多智能体控制层
专供 主控调度子智能体使用的控制层工具,普通工作节点(Worker)无权调用:
AgentTool:派生全新的子智能体进程。SendMessageTool:向已存在的子智能体发送消息,复用其上下文。TaskStopTool:发现子任务方向错误,强制阻断其运行。TeamCreateTool/TeamDeleteTool:基于内存的 Swarm (蜂群)多智能体组队协同。
3. 增强能力与外部交互
WebSearchTool/WebFetchTool:实时抓取网页或搜索报错信息,对抗模型知识库的老化。LSPTool:语言服务器协议集成。不再是死板的全文搜索,而是让大模型拥有“跳转到定义”、“查找所有引用”的能力,如同在 IDE 里看代码一样。NotebookEditTool:专门对 Jupyter Notebook 等.ipynb格式的富文本代码块进行解析和编辑。ConfigTool:动态修改项目或自身的配置文件(如settings.json)。
缓存复用、异步预加载与层级化工具箱,共同压低了 Agent 每一步的响应延迟。但降低延迟只是"跑得更快",还需要回答另一个问题:循环什么时候该停下来?下一节将拆解 queryLoop 的退出分支——它们定义了 Agent 在异常、超限或任务完成时的收敛边界。
2.7 状态流转与退出分支
在 src/query.ts 的 queryLoop 状态机中,每一次轮转都有可能触发退出或特殊流转。以下是 Claude Code 定义的 12 条生命线。它告诉了我们:程序不崩,不代表任务能无限跑下去。
- 正常使命达成:
completed——大模型输出了最后一句话,且没有附带任何tool_use(工具调用)。这意味着当前阶段的思考和执行已经抵达终点,循环优雅退出。 - 外部物理阻断:
aborted_streaming/aborted_tools——用户希望中止整个会话,例如按下Ctrl+C,或在授权界面选择"中止"而不是单条拒绝。此时底层系统将抛弃排队的任务,并在界面留下墓碑标记,挂起当前会话。与之区分:用户在授权界面拒绝单个工具时,该工具以{ is_error: true }的tool_result反馈给模型,循环继续(见 §2.5.3 业务降级策略),模型据此自愈调整方案。 - Token 经济学熔断:
prompt_too_long(上下文爆炸)——经过重重压缩后,API 仍返回上下文超限错误(如prompt_too_long或 HTTP 413),Agent 退出。blocking_limit(预警拦截)——在发送 API 前客户端自主检测到 Token 已超过物理窗口减去预留缓冲阈值(默认预留约 3000 Token),未战先退,提示用户清理上下文。max_output_tokens_escalate/recovery(输出触顶)——模型说了一半卡住了(触碰了单次输出 8k/64k Token 的上限),系统会自动注入一条隐藏提示语:"Output token limit hit. Resume directly — no apology..."(输出触顶,不要道歉,直接从断点继续往下写),然后无缝开启下一轮。 - 业务逻辑与安全拦截:
stop_hook_prevented/hook_stopped——在工具即将执行前,钩子(Hook,如恶意代码扫描器、禁止篡改特定文件的权限检查)触发拦截,强制任务退回给模型重新思考。 - 递归防止死亡螺旋:
max_turns——模型在解决一个无法解决的代码 Bug 时,很容易陷入"修改 → 报错 → 修改为原样 → 又报错"的死循环。设定绝对的最大轮次,一旦抵达强制结束,以限制 API 成本。 - API 意外与降级:
model_error/image_error——API 挂了、限流了,或者上传的图片超过尺寸限制。这通常会引发大模型降级,比如从旗舰 Sonnet 自动切换到更便宜、更快的轻量模型(如 Haiku)重试。
总之,12 条退出分支共同回答一个问题:任务没完成时,系统该用什么理由停下来,而不是崩溃。max_turns 截断“改回原样又报错”的死循环,prompt_too_long 逼用户清理,aborted_tools 响应用户的紧急中止,每条分支都对应一种可预期的故障画面。Go 实现中,Transition 枚举应与此一一对应。
退出分支保证了循环能在该停时停住,但"停下来"不等于"能接着跑"。Agent 在数百步的长任务中还必须跨轮次、跨会话地保存和检索记忆——这正是下一节要解决的持久化问题。
2.8 记忆层级与持久化设计
在解决“上下文过长”的问题时,我们前面提到了使用压缩管道进行 Token 压缩。但这只解决了“遗忘”的问题,却没有解决“记忆”的问题。
如果大模型把历史消息全压缩成了一句话摘要,那么当用户重新问起 10 分钟前读取的某段代码细节时,模型不就失忆了吗?
Claude Code 的源码给出了一套多层级记忆系统与后台分叉的设计。
通过分析 src/services/SessionMemory/sessionMemory.ts 和 src/memdir/memoryScan.ts,我们可以看到它将记忆分为“会话级(短期)”和“项目级(长期)”两层。
2.8.1 会话记忆设计
普通的 Agent 只有一条线程,所有的思考和总结都在用户的对话流里完成,不仅拖慢响应,还会消耗大量对话 Token。
而在 Claude Code 中,存在一个幽灵般的书记员:
- 隐式触发:每次大模型回复完毕后,底层会触发一个钩子(
extractSessionMemory)。 - 非侵入式判定:它会默默计算“距离上次总结,是不是又消耗了上万 Token”或者“是不是又调用了十几次工具”。如果满足条件,且当前没有激烈的工具连续调用,它就会启动。
- Fork 派生:它会调用 runForkedAgent,利用我们前文提到的 CacheSafeParams (缓存复用技术),克隆出一个对用户完全隐形的后台 Agent。
- 自主维护笔记:这个后台 Agent 只有一个任务:阅读最近的聊天记录,并使用专用的只读 FILE_EDIT 工具,去默默修改一份名为 MEMORY.md (或类似)的文件。
在这个过程中,主智能体(和用户的交互)不会有任何卡顿,就仿佛有一个助理在旁边默默为你做会议纪要。当主智能体的历史对话被自动压缩裁切时,它依然可以通过阅读这份 MEMORY.md 找回当时的细节。
2.8.2 项目记忆机制
除了会话内的动态记忆,如果用户在项目里积攒了几十个带有不同经验总结的 Markdown 文件(比如 .claude/memory/ 目录下),大模型是如何大海捞针的?
源码解密(memoryScan.ts):
系统采用了双轨制的拉链式检索:
Zipper 的数据结构含义与双轨算法: “Zipper” 借自函数式编程的 zipper 数据结构,在数据结构中间打开一个“焦点”窗口,左右两轨可独立移动。在此语境下,主线 是昂贵主模型的推理流;暗线 是廉价 Haiku 的检索流。两轨从同一 fork 点(用户按回车)出发,并行推进;暗线算法:manifest.filter(byKeywordOverlap) → Haiku rerank → topK paths → readFile(full);主线算法:正常 queryLoop 流式输出。当暗线 settledAt !== null 且主线到达 attachment injection point 时,两轨 zip (合并),检索结果注入主线 context。若暗线未完成,主线不等待,下一轮再 zip。
- 快速元数据构建: 在系统启动时,会快速扫描不超过 200 个 Markdown 文件(
MAX_MEMORY_FILES)。它并不是全量读取,而是只利用readFileInRange极速读取文件开头的 30 行,提取 Frontmatter (YAML 元数据,包含描述和时间戳),构建出一份微缩版的清单。
Frontmatter schema 与 Manifest 索引结构:Frontmatter 遵循 YAML 格式,典型 schema 为 { description: string, tags: string[], updated_at: ISO8601, priority?: number },包裹在 --- 分隔符之间。Manifest 是内存中的 Array<{ path, description, tags, mtime, tokenEstimate }>,按 mtime DESC 排序,上限 200 条。索引构建 $O(n)$ 单次扫描,查询 $O(n)$ 线性过滤,200 条规模下比向量索引更快且零依赖。tokenEstimate 由 frontmatter 的 description 长度启发式估算,供 Haiku 在 rerank 时做 budget 控制。
- 幽灵检索: 当用户在终端敲下新问题并按下回车时:
- 主线:庞大、昂贵的旗舰模型(如 Sonnet)开始流式输出它的思考。
- 暗线:一个成本较低且响应较快的轻量模型(如 Haiku)拿着用户的提问和那份“微缩清单”,在后台并发运行。如果 Haiku 认为清单中的某 3 个文件对当前问题有帮助,它就会把这 3 个文件完整地提取出来。
- 无缝注入(Injection): 当主模型的第一波思考完成,或者在它需要上下文的关键节点,那 3 个记忆文件的完整内容会被打包成“附件(Attachment)”,在主循环的间隙被无声无息地塞入
toolResults中。
2.8.3 工业级设计方案评估
如果你用 LangChain 或者 LlamaIndex,通常的做法是:引入一个向量数据库,把所有文件做 向量化,当用户提问时,先做一次向量检索(耗时 1~2 秒),把检索结果拼到 Prompt 里,然后再调用大模型(耗时 10 秒)。这叫串行阻塞。
而 Claude Code 的设计是: 不依赖任何外部沉重的向量数据库。直接用文件系统做底座,用元数据清单做索引,用廉价子模型的并发预测代替向量检索。主模型和检索模型的 I/O 有效重叠。
这是工业级架构的典型做法,通过工程优化,在不增加用户等待感知的前提下,延长 Agent 的有效记忆。
以上讨论的都是引擎内部的优化策略。但从用户视角出发,一个更直接的问题是:对话过长后前面的设定被“遗忘”,这到底是模型能力不足,还是底层代码主动丢弃了上下文?
上下文视图与 UI 历史并不总是一一对应:为了控制 Token 消耗,部分局部历史会在模型上下文中被压缩或裁剪,而 UI 仍可以保留完整记录,供用户回溯会话过程。
以下通过独立编写的概念代码,说明上下文视图可能如何被裁剪与重建。
2.8.4 视图差异探讨
初学者写 Agent 时,习惯维护一个全局的 messages 数组,每次都原封不动地全量发给大模型 API。但在 Claude Code 中,存在一个关键的过滤函数:getMessagesAfterCompactBoundary()。
typescript
// 概念伪代码:上下文视图过滤
export function getMessagesAfterCompactBoundary(messages) {
  // 1. 寻找最近的一次“压缩边界(Compact Boundary)”
  const boundaryIndex = findLastCompactBoundaryIndex(messages)
  const sliced = boundaryIndex === -1 ? messages : messages.slice(boundaryIndex)

  // 2. 剔除被 Snip(修剪)掉的无效历史
  if (feature('HISTORY_SNIP')) {
    return projectSnippedView(sliced)
  }
  return sliced
}
这意味着什么?
你的终端 UI (REPL)保留了完整的历史(供你往上滚动查看),但发给大模型 API 的,是被“截断”和“丢弃”后的子集。
2.8.5 上下文丢弃策略
在每一次大模型请求前,Claude Code 会对消息切片执行较为严格的审查和丢弃:
(1)越界丢弃
越界丢弃发生在压缩边界之外:当你触发了 AutoCompact(自动摘要,见 2.3 节)时,系统会在 messages 数组里插入一个特殊的边界标记以及一段摘要。 从这一刻起,在这个边界之前的所有几万字详细对话,对于后续的大模型推理来说,已经被彻底“物理丢弃”了。大模型看到的历史,其实是从 [总结了前面的任务] 这句话重新开始的。
(2)微观修剪
哪怕是在压缩边界之后的消息,也难逃被“修剪”的命运。系统通过 Snip(丢弃已被纠正的无效探索)和 Microcompact(抽空冗余工具调用的 payload,只保留动作骨架)两种机制,在不影响推理链完整性的前提下回收 Token。两者的判定规则、骨架保留策略与懒加载再取回机制,详见 §2.3.2。
(3)日志截断
当你执行了 npm install,终端输出了 5000 行依赖解析日志。 在进入 API 之前,applyToolResultBudget 函数会强行介入,它会保留开头和结尾(因为报错通常在结尾),把中间的几千行直接裁切丢弃。
恢复机制:日志截断并不等于永久删除。为了防止重要信息丢失,系统把被裁切的完整文本写入本地内容替换缓存(源码中的 ContentReplacementState)。如果大模型真的需要看中间的细节,它必须再次使用工具去精准捞取。
ContentReplacementState 的缓存 key、过期与读取 API: 键格式为 {sessionId}:{messageUuid}:{blockIndex},值为 { originalContent, truncatedAt, byteLength }。存储于进程内 LRU Map,上限约 500 条或 50MB;session 结束或超过 30 分钟无访问则过期清除。读取 API:retrieveReplacement(key) 供内部 tool handler 调用,返回原文并记录 access 时间刷新 TTL;若 key 不存在则返回 null,模型收到 “content no longer available” 提示。这与 Microcompact 共用同一存储后端,统一了“被裁切/被抽离”内容的懒加载入口。
2.8.6 数据清理的必要性
上述丢弃、修剪与截断并非为了“少发几个 Token”这么简单。它们直接服务于两项工程目标:稳住模型注意力,以及提高 Prompt Cache 命中率。
- 防注意力涣散:LLM 对长上下文呈现 U 型注意力曲线(首尾 Token 召回率高,中间段显著下降)。如果你把几千行的错误尝试和无关搜索全给它,它在最终写代码时,极有可能把错误代码的影子重新带进来。Claude Code 的 Snip 策略正是主动将低价值信息移出 U 型谷底:与其让关键代码片段被埋在数千行 npm install 日志中间,不如 snip 掉日志、保留首尾,使 signal 集中在高注意力区。工程上,Snip 通常将 tool_result 压至 budget 的 head+tail 各约 10%,把中间低密度日志移出上下文。
- 显著提升响应速度:修剪和丢弃无关消息后,剩下的高质量前缀更容易在长周期的对话中保持稳定,从而极大地提高 Anthropic Prompt Cache 的命中率。
总之,用户在 REPL 里向上滚动,看到的仍是完整对话;同一次请求发给 API 的,可能只是边界之后、snip 之后的子集。这种“双视图”承认 LLM 的注意力预算有限,完整审计留给人类,精简上下文留给模型。取舍得当,Agent 才能在 500 步后仍记得任务目标;取舍失当,第 50 步就会重复已 snip 掉的错误。
在 Agent 的运行中,除了空间的取舍,时间的流逝同样是一个重要的工程维度。
当用户离开电脑去喝了杯咖啡,或者去开了一个 1 小时的会议,回来继续和 Agent 聊天时,底层的上下文会发生什么变化?源码中给出了基于“时间间隔”的干预机制。
2.8.7 缓存生存时间探测
Anthropic 的 Prompt Cache 是按生存时间(TTL,Time-To-Live)计算的。一旦缓存失效,意味着接下来的一轮对话,大模型将重新读取整个上下文的几万个 Token,API 账单会显著上升。
在 src/services/api/promptCacheBreakDetection.ts 中,Claude Code 实现了一个专用的“缓存断裂探测器”:
typescript
// 源码截取:Anthropic 服务端的两种缓存 TTL
const CACHE_TTL_5MIN_MS = 5 * 60 * 1000  // 5分钟
export const CACHE_TTL_1HOUR_MS = 60 * 60 * 1000 // 1小时

// 计算距离上一次大模型回复的时间差
const timeSinceLastAssistantMsg = lastAssistantMessage
  ? Date.now() - new Date(lastAssistantMessage.timestamp).getTime()
  : null
它的运作机制如下:
- 时间戳比对:在每次发送 API 请求前,系统会寻找最近一次大模型的回复时间,并与当前时间做减法。
- 断裂归因分析:如果本次请求发现缓存读取量明显下降(即缓存断裂了),系统会立刻进行归因排查:
- 如果间隔小于 5 分钟,且系统提示词、工具定义都没变:系统判定为
likely server-side(服务端故障或主动驱逐)。 - 如果间隔超过了 5 分钟(或 1 小时),系统判定为
possible TTL expiry(缓存已过期)。
工程意义: 这种基于时间维度的监控,对于工业级 Agent 十分重要。因为如果我们知道缓存马上要过期,系统就可以在后台发起一个低成本的 空请求,即“缓存保活”策略,以保住这 90% 的上下文费用。
Dummy Request 保活的 payload 设计与失败处理: 保活请求复用当前 session 的完整 prefix (system + tools + messages),在 messages 末尾 append 一条 { role: 'user', content: '.' } 的极小 user 消息,并设置 cache_control: { type: 'ephemeral' } 刷新 breakpoint TTL。触发频率:距上次 API 调用 > 4 分钟(5min TTL 的前置窗口)且 session 仍 active 时后台发起;1h TTL 模型同理在 55 分钟窗口触发。成本:一次 Haiku 级 mini 请求的 cache_creation 费用,远低于全量 prefix 的 input_tokens 重读。失败处理:静默丢弃,不重试,保活失败只意味着下次对话 cache miss,不影响功能;连续失败 3 次则禁用 keepalive 避免烧钱。
2.8.8 记忆提取的时间节流
在上文提到的“会话记忆”中,系统并不是每说一句话就去提取一次记忆,那太浪费资源了。
系统引入了一个时间和动作的双重节流阀:
typescript
// 源码逻辑简述:什么时候该去后台写 MEMORY.md?
const hasMetTokenThreshold = hasMetUpdateThreshold(currentTokenCount) // 积累了足够多的新对话 Token
const toolCallsSinceLastUpdate = countToolCallsSince(messages, lastMemoryMessageUuid)
const hasMetToolCallThreshold = toolCallsSinceLastUpdate >= getToolCallsBetweenUpdates()

// 只有积累的 Token 和工具调用次数都达到了阈值,或者在对话的自然停顿期,才触发记忆提取
const shouldExtract = (hasMetTokenThreshold && hasMetToolCallThreshold) || (hasMetTokenThreshold && !hasToolCallsInLastTurn)- 自然停顿优先:如果在最近一轮交互中,大模型没有连续调用工具(说明它思考告一段落,或者在等用户回复),此时进行后台摘要提取是最高效的。
- 强制动作阻断:即便过了很长时间,但如果积累的新 Token 不够多,或者它还在连续执行工具(没有到结算期),后台记忆提取也不会打扰主线程。
总之,上下文管理同时在两个维度展开:Compaction 在 Token 逼近 13,000 缓冲线时动刀,Cache Break Detection 在 5 分钟 TTL 到期前尝试保活。两者并不总是协调,保活失败只影响费用,Compaction 失败则影响推理质量。尚无定论哪种策略在所有 workload 下更优;组合使用,至少避免了“空间耗尽”与“时间过期”同时失控的最坏情况。