主题
第 10 章:多智能体协同架构
:::
阅读建议:如果时间有限,聚焦“主从分工 + 异步汇报”的协作模式和 TransferGuard 的防死锁机制,即可把握多智能体协同的本质;SubAgentTool 实现、Event Bus 代码适合动手编码时回读。
:::
在应对单文件修改或简单的 Bug 修复时,我们在前几章构建的单体智能体已经绰绰有余。然而,当面临“从零搭建一个带鉴权的 React+Go 全栈博客系统”这类大型任务时,把所有的要求、上下文和工具都交给一个全局大模型,会迅速撞上三类瓶颈:同一 系统提示词 既要写前端 CSS 又要调优 SQL,模型极易角色错乱、风格撕裂;前端依赖安装日志与后端路由报错混在同一窗口,上下文被迅速污染;更关键的是,单线串行思考无法让“前端组件编写”与“后端 API 设计”并行推进。
在前文解构 Claude Code 时,我们提到了其核心的 Coordinator(主控) 模式:单体 Agent 升级为“一个主控 + N 个专家”,主控只做规划与验收,专家并行执行具体子任务,通过隔离与分治突破上下文窗口和角色一致性的瓶颈。下面用 Go 将该机制完整复现。
Coordinator 的核心职责可以拆解为三个环节:任务切分、调度编排、验收把关。
任务切分,Coordinator 在隐式依赖图上做拓扑切分,粒度目标是:每个子任务在输入给定的前提下,子智能体能在有限 Turn 内独立完成,且产出可被 Coordinator 独立验收。边界归属通常沿三条线索界定:依赖图边界(后端 API 契约须先于前端联调落地)、文件边界(同一文件的并发修改须归并到同一子任务)、功能模块边界(鉴权中间件、路由层、数据层各自拥有独立变更闭包)。
调度编排,若两个子任务在依赖图上无先后边且写集不相交,则允许并行委派;若存在数据依赖或共享写集,则必须串行,或先委派产出接口定义、再并行实现。Coordinator 的 系统提示词 中“先 grep/read 再委派”的原则,其实是在委派前构建这份隐式依赖图。
验收把关,验收不能仅靠子智能体的口头汇报,而应逐层收紧:先看结构(目标文件是否存在、目录布局是否符合预期);再读行为(亲自 read_file 核查关键逻辑);最后做集成对齐(前端调用的 endpoint 是否与后端路由一致)。子智能体返回的 summarizeWork 摘要只是线索,Coordinator 必须二次验证。这种将“执行者”与“验证者”分离的做法,在工业界称为制作者-检查者模式,通过分离角色(甚至使用不同模型),捕获单一智能体容易忽略的逻辑漏洞。
10.1 多智能体的设计原理
上文勾勒了 Coordinator 的角色定位,本节先回答一个前置问题:为什么不直接使用现成的 Multi-Agent 框架?
10.1.1 协同范式选型
市面上有许多复杂的 Multi-Agent 框架(如 AutoGen、MetaGPT),它们通常设计了繁琐的议事大厅、投票机制。但在工业级写代码的场景下,效率高于一切。
AutoGen 与 MetaGPT 代表了两种截然不同的协作范式。AutoGen 采用群聊轮换模型:多个 Agent 共享同一条消息线程,按 Round-Robin 或 LLM 自选的 next_speaker 轮流发言,对话历史对所有参与者可见,适合头脑风暴,但在写码场景下,上下文随轮次线性膨胀,“谁该说话”的调度开销也会拖慢高频工具调用。MetaGPT 则走 SOP 角色链:产品经理 → 架构师 → 工程师按固定流水线传递结构化产出,流程可控、格式统一;然而当任务只是改一个 Bug 时,完整 SOP 往往得不偿失。在工业级写码场景中,我们更倾向 Coordinator 主从模式而不是群聊:代码任务的核心循环是“规划 → 执行工具 → 观察结果 → 再规划”,需要的是有边界的委派-汇报,而不是无边界的多轮议事,前端编译日志若与后端 SQL 报错混在同一条消息线程里,Coordinator 的推理质量会迅速下降。
10.1.2 Agent-as-a-Tool 模式与推理隔离
最实用的架构是“主从分包制”:一个主控负责拆解任务,然后把子智能体当作普通的工具来调用。Agent 即工具(Agent-as-a-Tool) 正是这一判断的工程落点——将子智能体封装为 Tool,Coordinator 的上下文里只保留 (task_description) → (structured summary) 的函数式映射,主智能体不关心子智能体内部推理过程,从而可灵活增减“专家”而不影响整体架构。它既避免了群聊中前端日志污染后端推理,也避免了 SOP 对简单任务的仪式化开销,实质是把 Multi-Agent 问题归结为 Single-Agent + Tool Registry 的扩展。
Agent-as-a-Tool 的隔离设计遵循“共享基础设施、隔离推理状态”原则。memory、hitl 与文件系统属于共享层,子智能体读取同一项目上下文,所有 Bash 等高危操作也走同一 HITLArbitrator,write_file 直接作用于真实 workspace。与之相对,推理状态必须隔离:messages 不回流主智能体,每个子智能体拥有独立的 AgentContext 与 Token 预算,tool registry 也只注册其角色所需的工具子集。这一划分并非唯一方案,但在“共享工作区、隔离对话”的约束下,权限最小化与上下文精化之间取得了较稳妥的平衡。
10.1.3 统一接口与可组合编排
Agent-as-a-Tool 解决了 Coordinator 调度子智能体的问题,但它只是 Multi-Agent 编排的第一步。如果要实现 Chain (A → B → C 串行管线)、Cycle (A → B → A 迭代收敛)或 Graph (条件路由 DAG),现有的 SubAgentTool 结构体无法直接复用——它被硬编码为“Coordinator 调子智能体”这一种拓扑,缺乏通用的组合能力。
根源在于:当前系统中 Agent(RunLoop 的宿主)和 SubAgentTool(Tool 接口的实现者)是两种不相关的类型。前者有 RunLoop,后者有 Execute,二者无法互相嵌套。要让任意智能体既能作为顶层执行器、又能被另一个智能体当作子组件调用,我们需要提取一个统一的 Agent 接口:
go
type Agent interface {
    Run(ctx context.Context, agentCtx *AgentContext) (<-chan Event, error)
    Tools() []Tool
    SubAgents() []Agent
}
Run 接受本书一直使用的 AgentContext 作为执行上下文,返回 <-chan Event 而不是同步结果,这一设计将 Agent 的输出统一为事件流,使得任意 Agent 可以作为另一个 Agent 的子节点,事件在嵌套层级中逐级扇入。SubAgents() 暴露子智能体列表,供 Coordinator 按需发现和委派。
基于这个接口,不同编排拓扑只是 Run 方法的不同实现,如表 10-1 所示。
表 10-1 多智能体编排模式
| 编排模式 | Run 实现逻辑 | 适用场景 |
|---|---|---|
| LLMAgent | ReAct 循环:调 LLM → 执行工具 → 反馈结果 | 自治推理 |
| ChainAgent | 按顺序逐一执行子智能体,前者输出作为后者输入 | 多步管线 |
| CycleAgent | 循环执行子智能体,直到满足终止条件或达到最大迭代数 | 自修正、迭代优化 |
| ParallelAgent | 并发启动子智能体,合并事件流 | 多专家协作 |
| GraphAgent | 按 DAG 拓扑排序执行,支持条件路由 | 复杂工作流 |
有了统一接口,SubAgentTool 只需持有 Agent 接口而不是具体类型,Coordinator 用它调度一个 LLMAgent,也可以调度一整个 ChainAgent(内含三步管线),甚至嵌套另一个 Coordinator。这种任意嵌套的能力,就是可组合性的根基。
10.1.4 SubAgentTool 工程实现
下面的 SubAgentTool 实现展示了这一接口在 Coordinator 模式下的工程落点。为保持讲解的递进性,代码中仍以同步 RunLoop 驱动子智能体,Run 返回 <-chan Event 的异步形态将在 10.4 节 Event Bus 中逐步引入。
子智能体使用独立 Registry 的原因在于权限最小化与上下文精化。FrontendEngineer 不需要 GrepTool 扫描全仓库,DatabaseDBA 不需要 EditFileTool 修改 React 组件,独立的 Registry 从机制上限制了子智能体的能力边界,等效于 OS 的 capability-based security。同时,Tool Schema 列表直接进入子智能体的 LLM 请求,更小的 Registry 意味着更短的 tool definition payload,减轻模型在工具选择上的注意力分散。父 Agent 的 Registry 只暴露 delegate_to_* 系列,形成两层命名空间,Coordinator 永远看不到子智能体内部的 write_file 调用细节。
在 Go 中,我们实现一个 SubAgentTool:
go
type SubAgentTool struct {
Role string
SystemPrompt string
Tools []Tool
provider domain.LLMPort
memory domain.MemoryPort
hitl domain.HITLArbitrator
maxTurns int
maxTokens int // 该子智能体的 Token 预算上限
}
func (s *SubAgentTool) Name() string { return "delegate_to_" + s.Role }
func (s *SubAgentTool) IsConcurrencySafe() bool { return true } // 子智能体上下文隔离,可并发
func (s *SubAgentTool) Schema() interface{} {
return &struct {
TaskDescription string `json:"task_description" jsonschema:"description=Detailed task for the sub-agent"`
}{}
}
func (s *SubAgentTool) Execute(ctx context.Context, args []byte) (ToolResult, error) {
var params struct {
TaskDescription string `json:"task_description"`
}
json.Unmarshal(args, ¶ms)
// 隔离上下文:子智能体拥有全新的 AgentContext
subCtx := NewAgentContext(s.SystemPrompt, "Your task: "+params.TaskDescription, s.maxTokens)
subCtx.MaxTurns = s.maxTurns
// 孵化子智能体:通过独有的工具箱构建子 Registry
subRegistry := NewRegistry()
for _, t := range s.Tools {
subRegistry.Register(t)
}
subAgent := NewAgent(s.provider, subRegistry, s.memory, s.hitl)
subAgent.role = s.Role
err := subAgent.RunLoop(ctx, subCtx)
if err != nil {
return ToolResult{Output: "Sub-agent failed: " + err.Error(), IsError: true}, nil
}
summary := summarizeWork(subCtx.GetMessages())
return ToolResult{
Output: fmt.Sprintf("[%s completed] %s", s.Role, summary),
Metadata: map[string]string{
"turns_used": strconv.Itoa(subCtx.TurnCount),
"tokens_used": strconv.FormatInt(subCtx.TokensUsed, 10),
},
}, nil
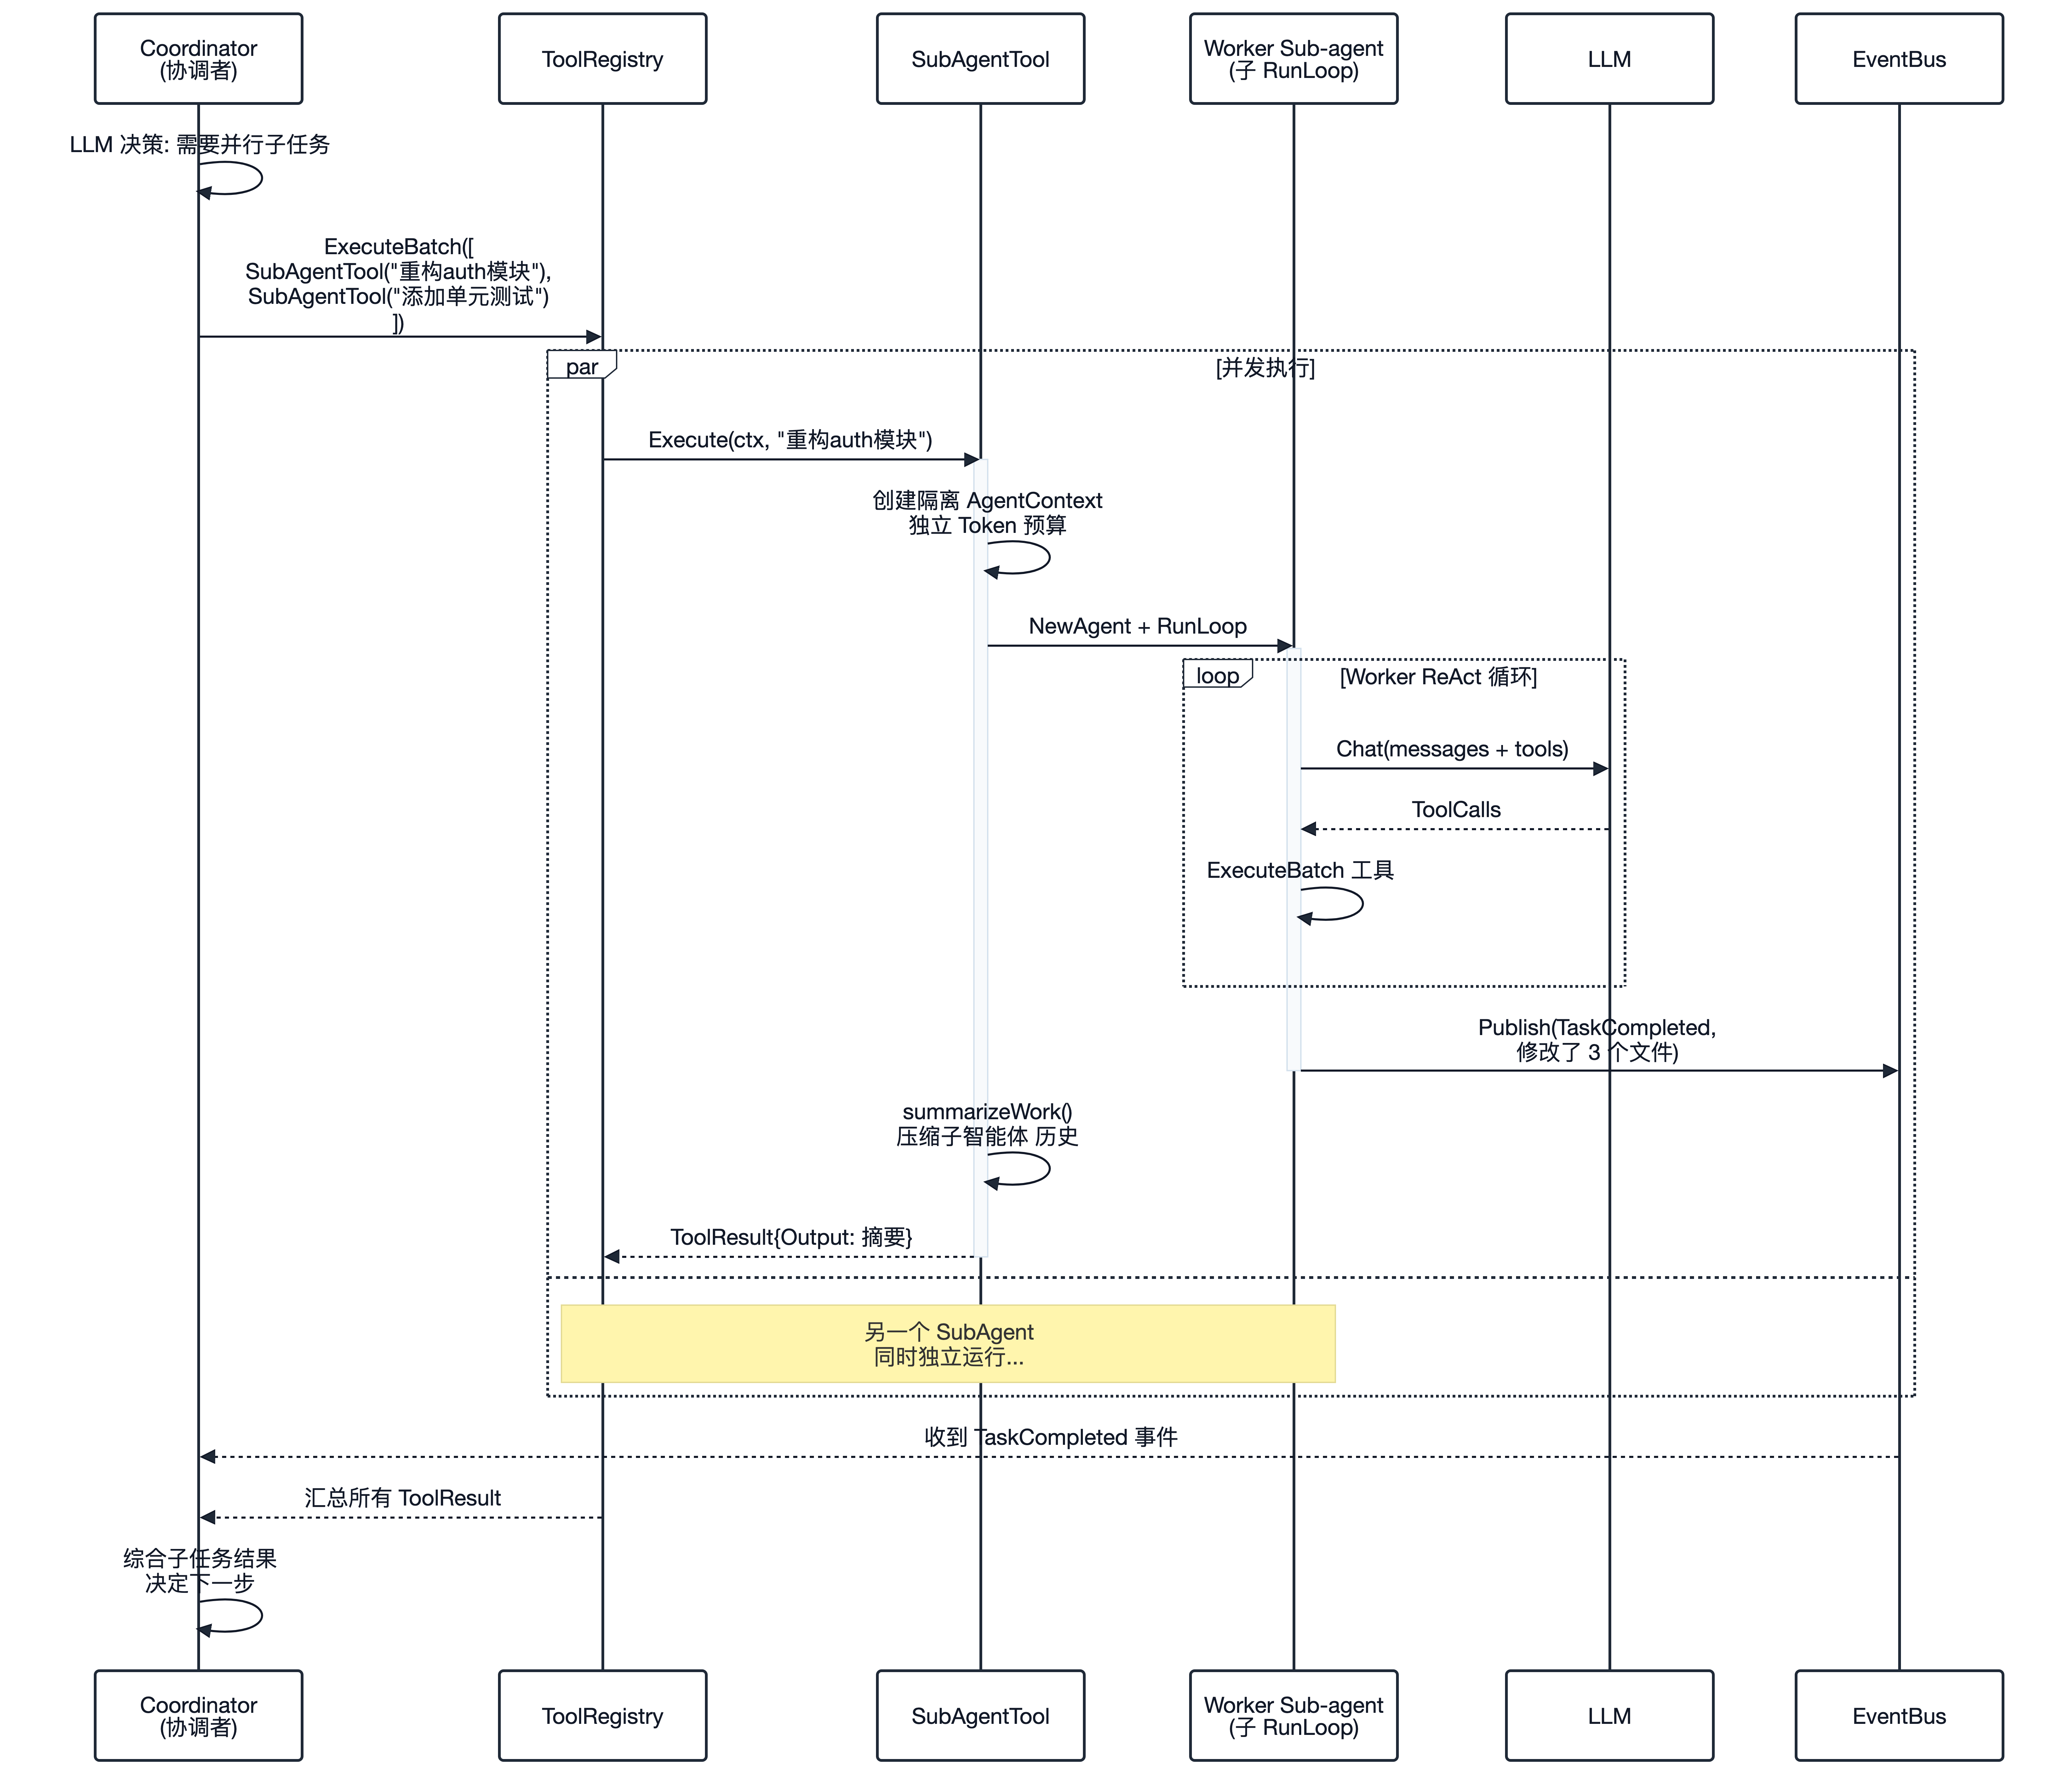
}对于主控来说,它根本不知道“前端开发”有多复杂。它只是下发了一个 delegate_to_FrontendEngineer 的 JSON,等了一会儿,收到了一句“界面已写完,路由位于 /home”。所有的复杂度都被隔离在了子 Context 中,如图 10-1 所示。
10.2 并发委派机制
上面的 SubAgentTool.IsConcurrencySafe() 返回 true,这意味着当 Coordinator 在一个回合中同时调用了 delegate_to_FrontendEngineer 和 delegate_to_BackendEngineer 时,工具箱章节的 ExecuteBatch 会把它们并发抛入 Goroutine 池中。
前端和后端子智能体各自运行在独立的 AgentContext 中,上下文互不污染:
go
// Coordinator 的工具箱中同时注册多个子智能体
registry := NewRegistry()
registry.Register(&SubAgentTool{
    Role:         "FrontendEngineer",
    SystemPrompt: "You are an expert React/TypeScript frontend developer...",
    Tools:        []Tool{&ReadFileTool{}, &WriteFileTool{}, &EditFileTool{}, &BashTool{hitl: gate}},
    provider:     llmPort,
    maxTurns:     15,
    maxTokens:    64000,
})
registry.Register(&SubAgentTool{
    Role:         "BackendEngineer",
    SystemPrompt: "You are an expert Go backend developer...",
    Tools:        []Tool{&ReadFileTool{}, &WriteFileTool{}, &EditFileTool{}, &BashTool{hitl: gate}, &GrepTool{}},
    provider:     llmPort,
    maxTurns:     20,
    maxTokens:    64000,
})
registry.Register(&SubAgentTool{
    Role:         "DatabaseDBA",
    SystemPrompt: "You are a database expert. Design schemas, write migrations...",
    Tools:        []Tool{&WriteFileTool{}, &BashTool{hitl: gate}},
    provider:     llmPort,
    maxTurns:     10,
    maxTokens:    32000,
})
// Coordinator 自身也有基础工具
registry.Register(&ReadFileTool{})
registry.Register(&GrepTool{})
10.2.1 预算隔离策略
每个子智能体有独立的 maxTokens 预算。这不仅防止某个子任务耗尽全局 Token 额度,还通过 Metadata 向 Coordinator 汇报实际消耗,让主智能体能感知成本并做出决策(“前端已经用了 5 万 Token 还没完成,可能需要换个策略”)。
Token 预算的 enforcement 采用渐进式截断 + 硬熔断两级策略,而不是提前 summarize。子智能体的 TokensUsed 逼近 maxTokens 的 80% 时,RunLoop 在下一轮 LLM 调用前触发上下文截断:保留 系统提示词、首条 Task Description 和最近 N 轮对话,丢弃中间的工具输出原文(与记忆压缩章节同源策略)。提前用 LLM 做二次摘要既消耗额外 Token,又可能丢失关键的文件路径和错误栈,在子任务尚未结束时,截断往往比摘要更可控。
当 TokensUsed >= maxTokens 时,执行硬熔断:RunLoop 立即终止,返回 ToolResult{IsError: true} 并在 Metadata 中标记 “budget_exhausted”: “true”。Coordinator 收到后可以选择:(1) 用更精确的 task_description 重新委派,(2) 提高 maxTokens 重试,(3) 亲自接手剩余工作。注意,熔断发生在 LLM 调用之前而不是之后,一旦发出请求,provider 侧已计费,enforcement 必须前置检查。这种“截断保活、超限熔断”的组合,在成本可控与任务连续性之间取得了工程平衡。
10.2.2 并发写入冲突防护
当 ExecuteBatch 并发启动多个子智能体时,共享文件系统成为最大风险点。两个子智能体同时 edit_file 同一源文件,后写者覆盖先写者,产生不可预测的 merge 灾难。工业级防护通常沿两条路径叠加。
Pi 式 file-mutation-queue 从机制上兜底:所有文件写操作不直接落盘,而是投递到全局串行队列,由单一 Goroutine 按到达顺序执行 read-modify-write;队列持有文件级锁,不同文件仍可并行,同一文件严格串行,思想与数据库行级锁相近。与此同时,Coordinator 串行化策略 在 系统提示词 层面约束委派逻辑,“同一 package 下的修改归同一子智能体”或“存在写依赖的子任务不得并行”。后者零代码成本,却依赖 LLM 的规划能力,单独使用并不可靠。生产环境宜两者并用:Prompt 约束降低冲突概率,队列机制保证冲突发生时的正确性。
10.2.3 跨智能体交接防环
状态机章节的 detectLoopDeath 用 Jaccard 相似度检测单个 Agent 内部的工具调用死循环。但在多智能体场景中,存在另一类更隐蔽的循环,跨 Agent 交接乒乓:Coordinator 把任务委派给 FrontendEngineer,后者发现需要后端契约,向 Coordinator 反馈;Coordinator 转派给 BackendEngineer,后者发现前端接口规格不明,再次反馈,如此 A→B→A→B 往复,每一步看似有进展,实际上系统在做无效功。
单 Agent 的 Jaccard 检测无法捕捉这种模式,因为每个 Agent 内部的 tool call 都不相同,循环发生在 Agent 之间的委派-汇报路径上。
防护机制需要在委派层面而不是单 Agent 层面实施。核心思想是一个滑动窗口去重器:记录最近 N 次委派的目标 Agent 名称,当窗口内不同 Agent 的数量低于阈值时,判定为交接乒乓并熔断。
go
type TransferGuard struct {
    maxHandoffs    int      // 总交接次数上限,如 20
    windowSize     int      // 滑窗大小,如 8
    minUniqueInWin int      // 窗口内最少不同 Agent 数,如 3
    history        []string // 交接目标记录
    mu             sync.Mutex
}

func (g *TransferGuard) Check(targetAgent string) error {
    g.mu.Lock()
    defer g.mu.Unlock()

    g.history = append(g.history, targetAgent)

    // 硬上限:总交接次数超限
    if g.maxHandoffs > 0 && len(g.history) > g.maxHandoffs {
        return fmt.Errorf("max handoffs exceeded: %d", g.maxHandoffs)
    }

    // 滑窗检测:最近 N 次交接中不同 Agent 不足阈值
    if len(g.history) >= g.windowSize {
        window := g.history[len(g.history)-g.windowSize:]
        unique := make(map[string]struct{})
        for _, name := range window {
            unique[name] = struct{}{}
        }
        if len(unique) < g.minUniqueInWin {
            return fmt.Errorf("repetitive handoff detected: %d unique agents in last %d handoffs",
                len(unique), g.windowSize)
        }
    }
    return nil
}
TransferGuard 由 Coordinator 持有,在每次 SubAgentTool.Execute 入口处调用 Check。默认参数(maxHandoffs=20, windowSize=8, minUniqueInWin=3)意味着:最近 8 次委派中至少要有 3 个不同的子智能体被调用,如果只有 2 个 Agent 在反复交接,滑窗检测会触发。需要注意的是,某些合法场景确实只涉及两个 Agent 的多次交替(如前端和后端就 API 契约反复对齐),此时应根据实际任务结构调低 minUniqueInWin 至 2,或增大 windowSize 以容忍更长的交替序列,参数的选取应基于团队实际的委派模式,而不是一刀切。
触发后的降级策略与单 Agent 熔断类似:向 Coordinator 的 messages 注入告警(“交接循环已检测到,请重新分析任务依赖并调整委派策略”),或直接返回 ToolResult{IsError: true} 强制 Coordinator 反思。TransferGuard 与状态机章节的 checkCircuitBreaker 形成互补,checkCircuitBreaker 防单 Agent 内部的工具调用死循环,TransferGuard 防跨 Agent 的委派交接死循环。
与 Coordinator 的层级制相对,对等交接模式(Swarm) 允许成员 Agent 之间直接交接任务而不经中央主控,适合前后端联调等需要频繁双向协作的场景;两种模式不互斥,可在同一系统中共存。Swarm 的完整实现超出本章范围(需要 transfer_to_agent 工具和动态子智能体名册),但上述防环护栏无论在 Coordinator 还是 Swarm 模式中都应部署,多 Agent 系统中的交接循环是真实的生产事故源。
10.3 结果聚合与摘要压缩
子智能体的完整对话历史可能有几万 Token。直接全量返回给 Coordinator 会立刻撑爆主智能体的上下文窗口。因此 summarizeWork 是关键函数:
go
func summarizeWork(messages []Message) string {
    var result strings.Builder
    result.WriteString("Files modified:\n")

    filesModified := make(map[string]bool)
    var lastAssistant string

    for _, msg := range messages {
        // 从工具调用中提取文件操作
        for _, tc := range msg.ToolCalls {
            if tc.Name == "write_file" || tc.Name == "edit_file" {
                var p struct{ Path string `json:"path"` }
                json.Unmarshal(tc.Arguments, &p)
                filesModified[p.Path] = true
            }
        }
        if msg.Role == "assistant" && msg.Content != "" {
            lastAssistant = msg.Content
        }
    }

    for path := range filesModified {
        result.WriteString("  - " + path + "\n")
    }

    // 附上子智能体最后的总结(通常大模型会在最后一轮给出总结)
    if len(lastAssistant) > 1000 {
        lastAssistant = lastAssistant[:1000] + "..."
    }
    result.WriteString("\nFinal summary:\n" + lastAssistant)

    return result.String()
}
这确保了 Coordinator 收到的是精炼的结构化摘要,而不是几万 Token 的原始对话。
summarizeWork 采用的是启发式提取而不是 LLM 二次摘要,这是一个刻意的信息损失权衡。它保留三类信号:文件变更清单(从 tool call args 中确定性提取,零损失)、子智能体最后一轮 assistant 回复(截断至 1000 字符,可能丢失中间推理链)、工具调用次数与 Token 消耗(Metadata 层,完整保留)。丢失的主要是:中间轮次的错误-修复过程、被截断的工具输出原文、子智能体内部的“思考”内容。
不做二次 LLM 摘要,是成本、延迟与可靠性三者权衡后的取舍。每个子智能体完成后再调一次 LLM,Multi-Agent 场景下 Token 开销近似翻倍;同步摘要还会阻塞 Coordinator 的下一步规划,异步摘要则引入一致性问题。更棘手的是幻觉风险,摘要模型可能“润色”掉关键的 error message,或捏造不存在的文件变更;对验收决策而言,确定性提取远比生成式摘要可靠。若未来需要更丰富的摘要,更稳妥的做法是在子智能体的 系统提示词 中要求最后一轮输出结构化 JSON 总结,而不是事后追加 LLM 调用。
10.4 异步委派与事件总线
上述 Agent-as-a-Tool 是同步的(主智能体会被阻塞等待子智能体完成)。但在某些场景中,Coordinator 希望“分发完任务后,自行处理其他工作,待子智能体完成后再继续”。
要实现异步唤醒,我们引入全局 事件总线(Event Bus):各 Agent 发布事件、订阅感兴趣的频道,通信解耦,添加新 Agent 无需修改现有 Agent。
go
type AgentEvent struct {
    Type     string // "TaskCompleted", "NeedHelp", "FatalError"
    FromRole string
    ToRole   string
    Payload  string
}

type EventBusStats struct {
    Published         int64
    Delivered         int64
    Dropped           int64
    ActiveSubscribers int
}

type SimpleEventBus struct {
    mu          sync.RWMutex
    subscribers []chan AgentEvent

    published atomic.Int64
    delivered atomic.Int64
    dropped   atomic.Int64
}

func NewSimpleEventBus() *SimpleEventBus {
    return &SimpleEventBus{}
}

func (b *SimpleEventBus) Publish(event AgentEvent) {
    b.published.Add(1)
    b.mu.RLock()
    defer b.mu.RUnlock()
    for _, ch := range b.subscribers {
        select {
        case ch <- event:
            b.delivered.Add(1)
        default:
            b.dropped.Add(1)
            slog.Warn("event dropped: subscriber buffer full",
                "event_type", event.Type,
                "from_role", event.FromRole,
                "total_dropped", b.dropped.Load(),
            )
        }
    }
}

func (b *SimpleEventBus) Stats() EventBusStats {
    b.mu.RLock()
    activeSubs := len(b.subscribers)
    b.mu.RUnlock()
    return EventBusStats{
        Published:         b.published.Load(),
        Delivered:         b.delivered.Load(),
        Dropped:           b.dropped.Load(),
        ActiveSubscribers: activeSubs,
    }
}

func (b *SimpleEventBus) Subscribe(ctx context.Context) <-chan AgentEvent {
    b.mu.Lock()
    defer b.mu.Unlock()
    ch := make(chan AgentEvent, 32)
    b.subscribers = append(b.subscribers, ch)

    go func() {
        <-ctx.Done()
        b.mu.Lock()
        defer b.mu.Unlock()
        for i, sub := range b.subscribers {
            if sub == ch {
                b.subscribers = append(b.subscribers[:i], b.subscribers[i+1:]...)
                close(ch)
                break
            }
        }
    }()
    return ch
}
上述 Publish 实现的是 at-most-once 投递语义:消息最多被消费一次,不保证必达。select 的 default 分支在 channel 缓冲区满时丢弃事件而不是阻塞发送方;丢弃时通过 slog.Warn 记录结构化告警,并维护 published / delivered / dropped 三个原子计数器供 Stats() 暴露——确保丢消息是“可观测的降级”而不是不可见的故障。
Channel 满时丢消息的影响需分角色分析。对 Coordinator 而言,它是 Event Bus 的主要消费者,channel 容量(32)应大于最大并发子智能体数;若 Stats().Dropped 持续增长,说明处理速度跟不上生产速度,应增大 buffer 或批量消费积压事件。对子智能体而言,它们主要通过 SendMessageTool 发送而不是接收,丢消息影响较小。Subscribe 接受 context.Context,订阅者生命周期与 context 绑定,子智能体完成后其 channel 自动移除并关闭,避免资源泄漏。
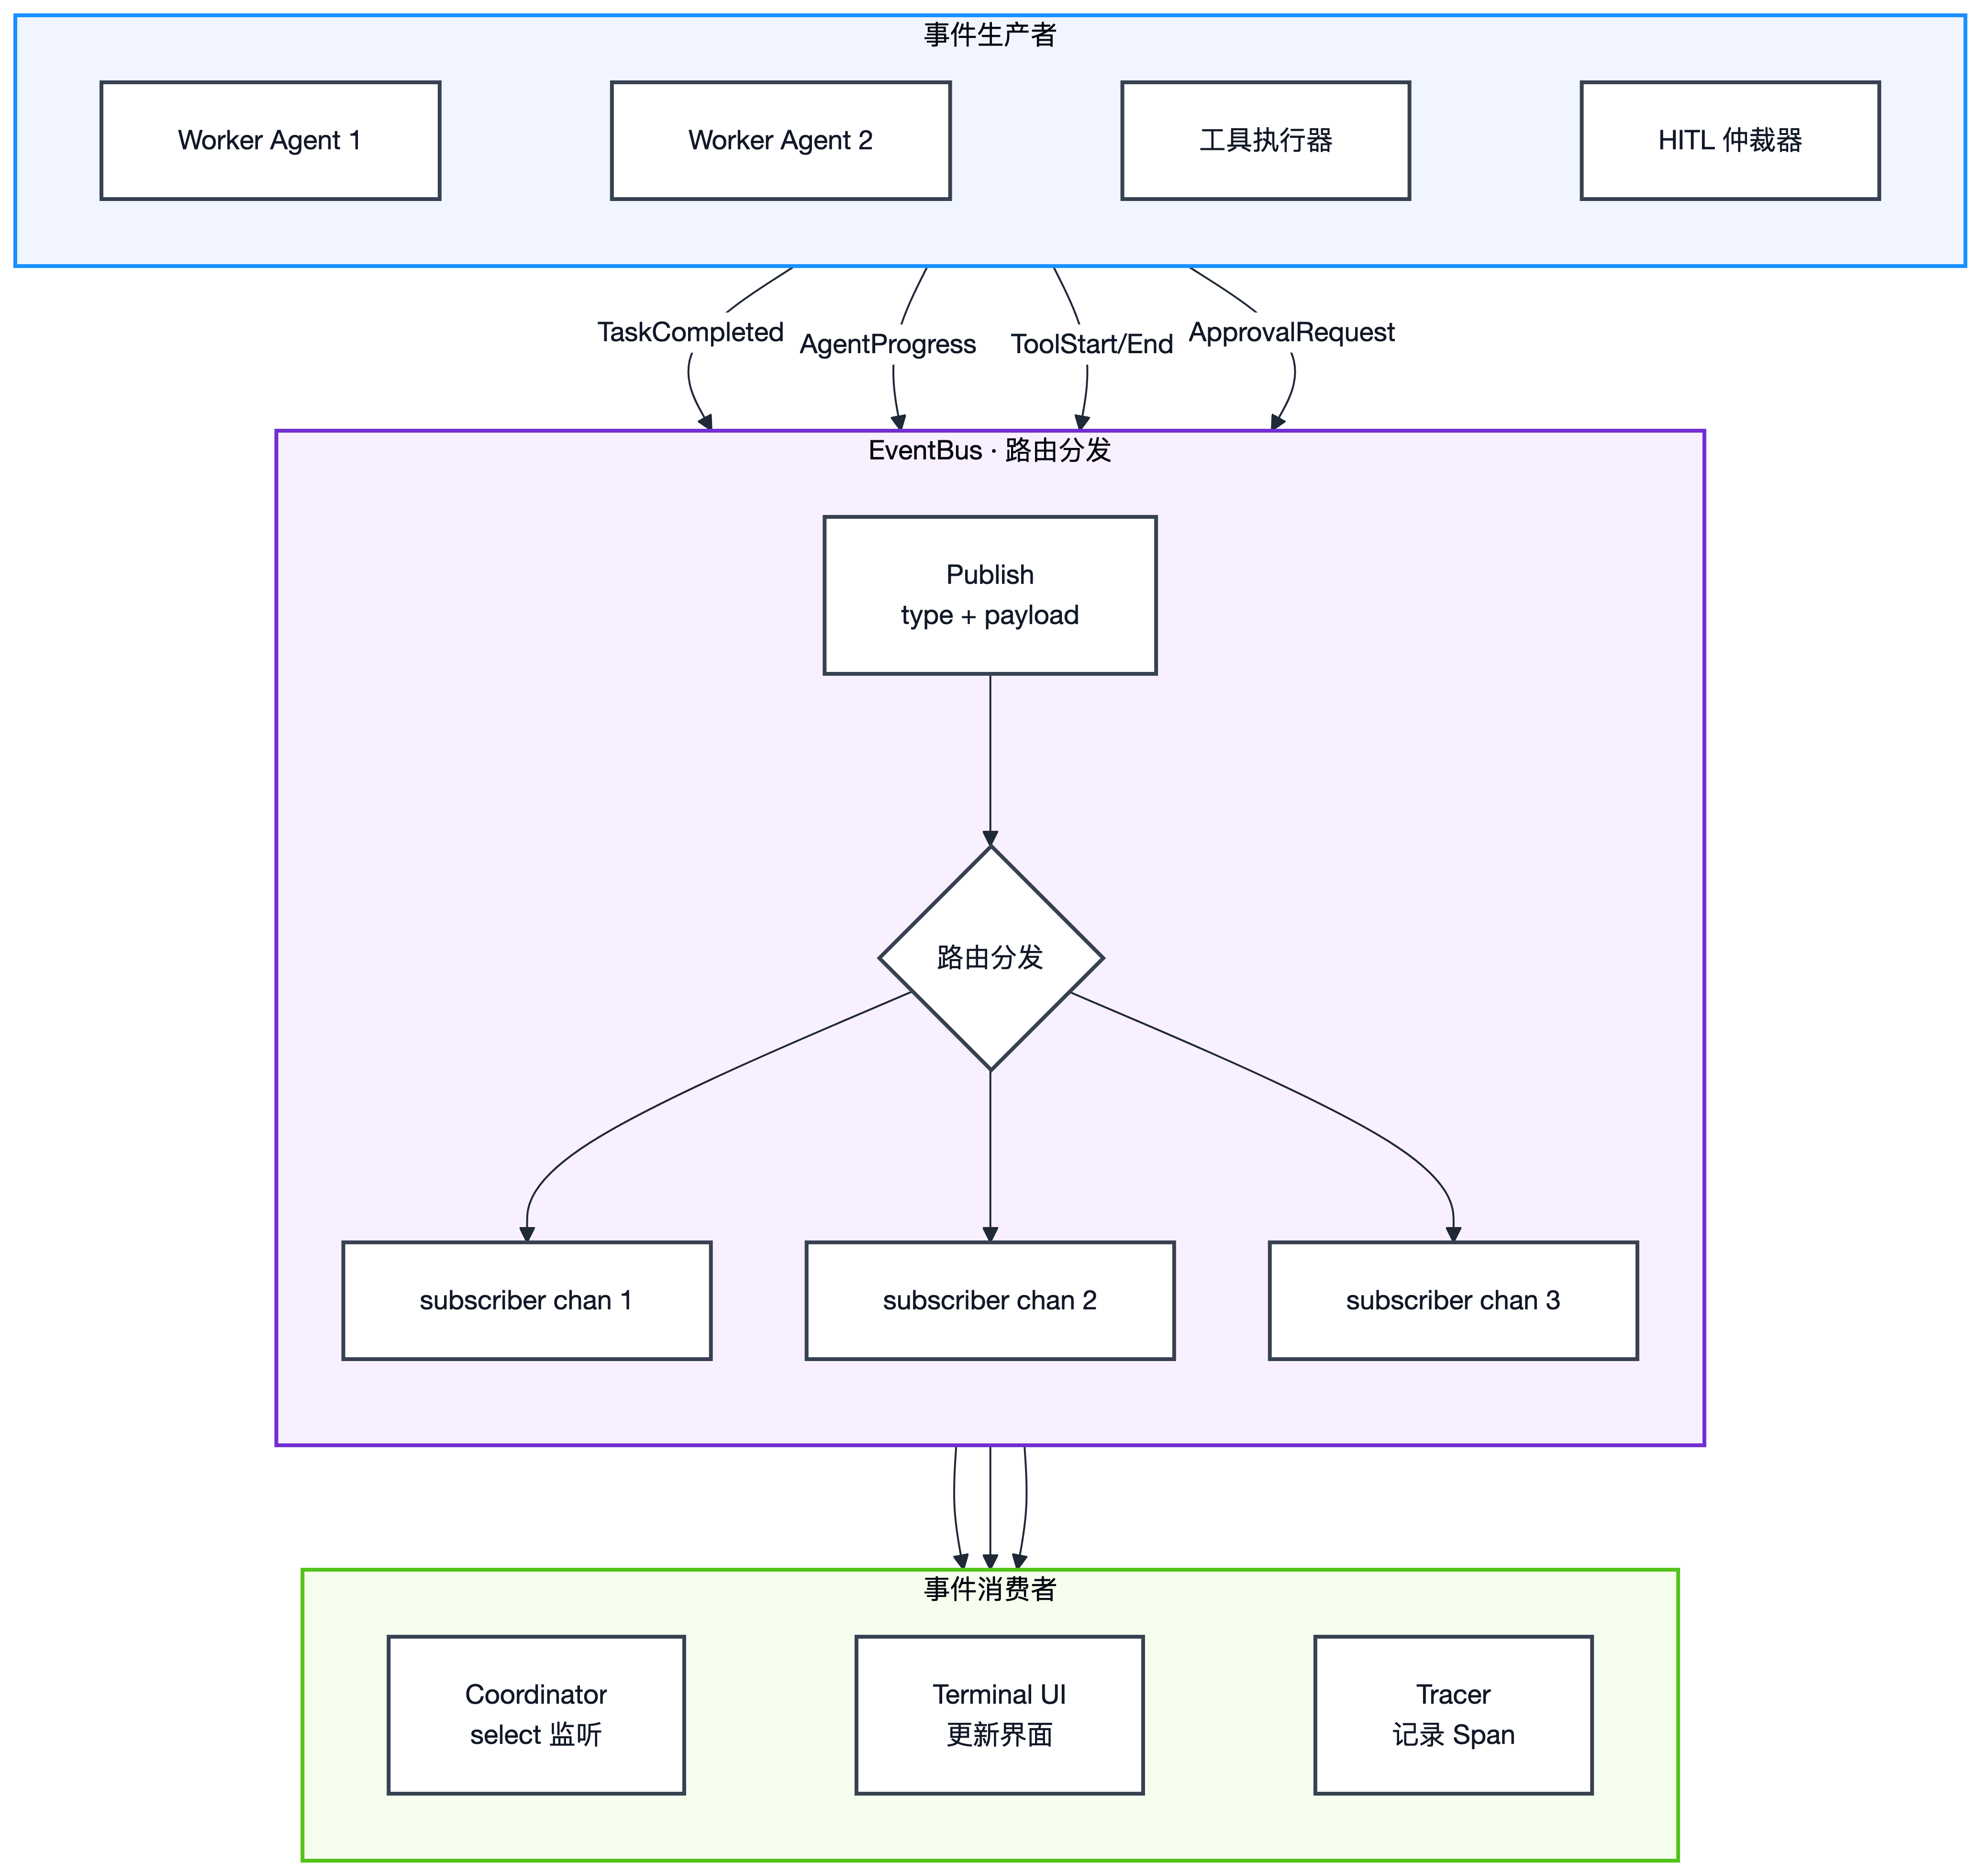
与 Kafka、RabbitMQ 等真实 MQ 相比,进程内 Channel 放弃了持久化与投递保证。这一取舍在 CLI Agent 的单进程架构中往往可接受:关键交付仍走同步 ToolResult 路径,Event Bus 只承担“任务完成通知”等可重建信号。代价必须正视——丢失一条 NeedHelp 时,Coordinator 可能未能及时响应,子智能体会在 maxTurns 耗尽后自行退出。当产品演进到多进程或分布式 Agent 时,Event Bus 接口可保持不变,底层替换为 NATS 或 Redis Pub/Sub,AgentEvent struct 即是未来 message schema 的原型,如图 10-2 所示。
Event Bus 的演进方向
当前架构中,关键交付走同步 ToolResult 路径,Event Bus 只承担辅助通知。当系统演进到需要实时流式展示多个子智能体进度时(例如 TUI 同时渲染前端和后端 Agent 的输出),可以将 10.1 节统一接口的 <-chan Event 作为子智能体的输出通道,Event Bus 承担扇入,多个子智能体的事件流汇入同一个 Bus,Coordinator 和 TUI 各自通过 Subscribe 按事件类型过滤消费。SimpleEventBus 的 Publish / Subscribe 机制无需改动,只需将发布源从手动 Publish 调用替换为子智能体事件流的自动转发。此时需要注意事件流的生命周期管理,channel 关闭时的清理、背压下的降级(即上文 default 分支的 drop 策略)、以及跨 Agent 事件的因果顺序。
10.4.1 智能体唤醒机制
前面各节的 SubAgentTool.Execute 是同步模型——Coordinator 发起调用并阻塞等待子智能体返回。但在需要长期驻留的协作场景中(如一个 Agent 监控 CI,另一个持续编写代码),我们需要异步唤醒:智能体完成当前任务后挂起,直到同僚通过 Event Channel 投递新消息才重新激活。
在状态机章节的 RunLoop 中,大模型在没有任务时会退出循环。通过监听 Event Channel,我们可以实现“被其他 Agent 唤醒”。下面的 isCompleted 判定逻辑为:最后一条 assistant 消息既不含 tool_call 也不含 end_turn 以外的 stop_reason,即认为当前轮次完成:
go
func (a *Agent) RunLoopWithEvents(ctx context.Context, agentCtx *AgentContext, eventChan <-chan AgentEvent) error {
    for {
        // 优先处理同僚发来的消息
        select {
        case evt := <-eventChan:
            agentCtx.AppendMessage(Message{
                Role:    "user",
                Content: fmt.Sprintf("<task-notification from=\"%s\" type=\"%s\">\n%s\n</task-notification>", evt.FromRole, evt.Type, evt.Payload),
            })
        default:
        }

        // ... 正常的思考与 Tool 执行流程 ...

        if isCompleted(agentCtx) {
            if a.role != "Coordinator" {
                return nil // 子智能体完成即退出
            }
            // Coordinator 挂起等待子智能体汇报
            select {
            case <-ctx.Done():
                return ctx.Err()
            case evt := <-eventChan:
                agentCtx.AppendMessage(Message{
                    Role:    "user",
                    Content: fmt.Sprintf("<report from=\"%s\">\n%s\n</report>", evt.FromRole, evt.Payload),
                })
                continue // 醒来重新规划
            }
        }
    }
}
isCompleted 的判定原理取决于 Agent 角色与当前状态机位置。对非 Coordinator 子智能体,完成条件通常是:最近一轮 LLM 回复不包含 tool_calls (模型认为任务已达成),或 TurnCount >= MaxTurns(耗尽轮次强制退出),或 Token 预算熔断。满足任一条件,RunLoopWithEvents 直接 return nil,子智能体的生命周期是短促的任务级:被委派 → 执行 → 摘要返回 → 销毁,不会进入挂起等待。
对 Coordinator,isCompleted 的含义不同:它标志着“当前规划周期内没有待执行的 tool_calls”,但不代表整体任务完成,可能只是委派出去后在等待。因此 Coordinator 在 isCompleted 后不会退出,而是进入 select 挂起状态,监听 eventChan。当子智能体通过 Event Bus 发送 TaskCompleted 或 FatalError 事件时,Coordinator 被唤醒,事件被包装为 <report> XML 注入 messages,然后 continue 回到 RunLoop 顶部,等效于一次新的 user turn,Coordinator 重新调用 LLM 进行再规划:验收子智能体产出、决定下一步委派、或宣布全局任务完成。
Event 注入后的重新规划遵循“最新信息优先”原则。注入的 <report> 在 messages 末尾,LLM 的注意力自然聚焦于此。Coordinator 可能的行为包括:read_file 验证 → 继续委派下一个子任务、发现冲突 → 重新委派修正、所有子任务完成 → 输出最终总结并退出。这种“挂起-唤醒-再规划”循环,使 Coordinator 成为真正的长期运行编排器,而不是一次性的任务分发器。
10.4.2 内部通信工具实现
go
type SendMessageTool struct {
EventBus *SimpleEventBus
MyRole string
}
func (t *SendMessageTool) Name() string { return "send_message" }
func (t *SendMessageTool) IsConcurrencySafe() bool { return true }
func (t *SendMessageTool) Execute(ctx context.Context, args []byte) (ToolResult, error) {
var params struct {
TargetRole string `json:"target_role"`
Message string `json:"message"`
}
json.Unmarshal(args, ¶ms)
t.EventBus.Publish(AgentEvent{
FromRole: t.MyRole,
ToRole: params.TargetRole,
Type: "InterAgentCommunication",
Payload: params.Message,
})
return ToolResult{Output: "Message dispatched to " + params.TargetRole}, nil
}SendMessageTool 的可靠性模型必须清醒认识到:无 ack、无重试、无 ordering。调用 Publish 后,工具立即返回 “Message dispatched”,这仅表示事件已写入 channel (或已被丢弃),不表示目标 Agent 已收到、已处理、或将在何时处理。没有 message ID,没有 delivery receipt,没有 dead letter queue。如果目标 Agent 尚未 Subscribe 或 channel 已满,消息静默丢失。
这种“即发即忘”语义在 Agent 协作中是可接受的,因为 SendMessageTool 传递的是辅助性通信(“我需要 API 契约”、“遇到阻塞”),而不是关键性交付(子智能体的最终产出通过同步 ToolResult 路径返回)。若需可靠传递,应在应用层实现:发送方在 ToolResult 中要求确认,或 Coordinator 在再规划时主动 read_file 验证而不是依赖消息。Ordering 同样不保证,两个子智能体几乎同时 send_message,Coordinator 收到事件的顺序取决于 Go scheduler,可能与发送顺序不同。
10.5 主控提示词与角色指令设计
10.5.1 结构化角色设定
上面代码中使用了 <task-notification> 和 <report> 等 XML 标签。为什么是 XML?
大语言模型对 <tag>...</tag> 配对结构的注意力聚焦优于纯文本前缀,plain text 拼接(“Your colleague said: ...”)容易被模型当作普通对话忽略;Function Call 适合工具参数,但系统级事件并非 Coordinator 主动调用的工具,语义不对等。合成 XML 标签 正是利用这一特性:<task-notification from=“FrontendEngineer” type=“completion”> 以强边界确立系统级中断,模型能精准解析属性,区分下属汇报与用户指令。误读的防护手段包括:系统提示词 要求“收到 XML 标签时暂停当前计划并响应”、使用不常见标签名降低碰撞概率、isCompleted 挂起机制确保事件不被后续 tool_calls 淹没。
角色设定定义了智能体之间的通信语义,接下来看 Coordinator 自身的系统提示词如何编排全局策略。
10.5.2 主控提示词模板
一个好的 Coordinator 不需要复杂的编排代码,关键在于 系统提示词 的设计:
go
const coordinatorPrompt = `You are a senior tech lead coordinating a team of specialist agents.

Available team members:
- delegate_to_FrontendEngineer: Expert in React, TypeScript, CSS. Give them UI tasks.
- delegate_to_BackendEngineer: Expert in Go, API design, business logic.
- delegate_to_DatabaseDBA: Expert in SQL, migrations, schema design.

Work principles:

1. ALWAYS start by reading existing code with grep/read_file to understand the codebase.

2. Break complex tasks into independent subtasks and delegate in PARALLEL when possible.

3. After delegation, VERIFY the results by reading the modified files yourself.

4. If a sub-agent fails, analyze the error and either retry with clearer instructions or take over.

5. Never delegate simple one-file changes — do them yourself with edit_file.`
核心原则是让 Coordinator 自主决策何时分派、何时亲自动手。不需要在代码中硬编码任务路由,大模型已经具备了足够的规划能力。
系统提示词 的设计关键在于将编排逻辑外置为 LLM 可执行的策略文档。并行 vs 串行的决策不在代码中 if-else,而是通过 Work principles 第 2 条“Break complex tasks into independent subtasks and delegate in PARALLEL when possible”引导模型自行判断依赖关系。第 3 条“VERIFY the results by reading the modified files”则定义了验收协议,Coordinator 必须亲自 read_file,而不是信任子智能体摘要,这是防止级联幻觉的关键。
失败重试策略同样编码在 Prompt 中:第 4 条“analyze the error and either retry with clearer instructions or take over”。Retry 不是盲目的,Coordinator 应先分析 ToolResult.IsError 中的错误信息,判断是 task_description 不够清晰(重写后重新委派)、子智能体能力不匹配(换角色或亲自执行)、还是环境性问题(如依赖未安装,Coordinator 先用 Bash 解决再重新委派)。第 5 条“Never delegate simple one-file changes”定义了委派阈值,过度委派的开销(子智能体启动、上下文初始化、摘要返回)可能超过 Coordinator 直接 edit_file 的成本,Prompt 必须明确这一边界以避免“杀鸡用牛刀”。
本章小结:
多智能体协同的核心,是把“谁执行”与“谁验收”拆开,再用 Go 原生的 Goroutine 和 Channel 把这一分工落到进程内,Agent-as-a-Tool 封装子任务的复杂度,Event Bus 与 select 挂起支撑异步汇报,Token 预算与启发式摘要则防止子智能体的上下文回流污染主智能体。我们没有为此引入 Asyncio 事件循环或外部消息队列;在单进程 CLI 场景下,这一组合已足够支撑并行委派。然而后台并行只是能力的一半,若终端界面缺少结构化输出,用户仍难以感知各 Agent 的运行状态。下一章转向 TUI 与终端交互渲染设计。