主题
第 5 章:构建智能体循环的底层驱动引擎
:::
阅读建议:如果时间有限,聚焦统一接入层设计和容错降级两个主题,即可理解驱动器的核心价值;Go 实现细节、Anthropic 适配器差异对照等适合动手编码时回读。
:::
在掌握了 Go 语言的并发与流控机制后,接下来实现 Agent 的核心组件,LLM 驱动器。
很多开发者习惯直接调用官方提供的 SDK (比如 go-openai 或者 anthropic-sdk-go)。然而当同一次对话中需要在 OpenAI、Claude、DeepSeek 三家之间切换时,官方 SDK 各自封装的消息格式互不兼容,system 是独立字段还是首条 message、tool_result 该用何种 role,第一个被迫解决的问题就是格式归一。若还要在 API 限流或宕机时自动 Fallback,或在 Function Calling 中强制 JSON 输出,直接耦合单一 SDK 会让 Agent 核心逻辑与厂商 API 绑定,每次换模型都要改业务代码。封装一层统一接入层,是绕不开的前置工程。
下面用 Go 语言从零实现一个统一、强类型、带熔断机制的 LLM 驱动器。
5.1 统一模型接入层设计
不管是 ChatGPT、Claude 还是各种开源大模型,它们的 API 请求和响应格式千差万别。如果让 Agent 核心业务逻辑直接耦合特定厂商的 SDK,你的系统将丧失灵活性。
在 Go 中,我们通过定义一套统一的 LLMProvider 接口来屏蔽这种差异。这一 Provider(模型供应商抽象) 层让 Agent 核心业务只依赖统一端口,切换 GPT、Claude、DeepSeek 等模型时只需替换适配器实现,不必重写业务代码。
在动手写代码之前,需要先明确架构分层的取舍。在 DDD 中,一条被广泛采纳的准则是:依赖方向从外向内,领域层不依赖任何外部包,但这并非没有代价:早期多写一层端口定义,换模型时少改一行业务逻辑。
DDD / 六边形架构的分层判据:领域层(Domain) 承载核心业务概念与规则,Message、ToolCall、状态机流转逻辑,零外部依赖;应用层(Application) 编排用例(“调用 LLM → 执行工具 → 更新记忆”),依赖领域端口但不关心 HTTP/SDK 细节;基础设施层 实现端口,OpenAI HTTP 客户端、SQLite 记忆存储、终端 UI。驱动端口 是外部主动调用系统的入口(如 CLI 命令、HTTP 请求);被驱动端口 是系统主动依赖的外部能力(如 LLMPort、MemoryPort、ToolExecutor)。
适配器如何挂接:适配器实现被驱动端口接口,在组合根 中完成依赖注入,Agent 持有 domain.LLMPort 接口,运行时注入 OpenAIProvider 或 FallbackProvider 具体实现。领域层永远看不到 import “net/http”,换模型、换存储、换 UI 只改适配器和组合根,领域一行不动。
很多项目的典型错误是把 Message、ToolCall 这些核心领域类型定义在 internal/llm/ 包中。这会导致工具层、Agent 层、记忆层都要反向依赖基础设施层来获取类型定义,整个依赖方向都反了。
工程上更稳妥的路径是:先建立一个纯净的领域层 domain,把 Message、ToolCall 等核心概念放在里面,让其他层朝内依赖它。这一选择意味着组合根会略厚、接口文件会增多,但换来的是换模型、换存储时领域层一行不动,对长期维护 Agent 产品而言,这笔账通常划算。
5.1.1 领域层核心抽象
go
// ===== 领域层:零依赖的核心业务类型 =====
package domain

// Message 是对话历史的基本单元,贯穿 Agent 的整个生命周期
type Message struct {
    Role       string     `json:"role"`       // "system" | "user" | "assistant" | "tool"
    Content    string     `json:"content"`
    ToolCalls  []ToolCall `json:"tool_calls,omitempty"`
    ToolCallID string     `json:"tool_call_id,omitempty"`
    IsError    bool       `json:"is_error,omitempty"`
}

// ToolCall 描述大模型发起的一次工具调用指令
type ToolCall struct {
    ID   string `json:"id"`
    Name string `json:"name"`
    Arguments []byte `json:"arguments"` // 原始 JSON,延迟到适配器层再反序列化
}

// ToolDefinition 描述一个工具的元信息,用于构建 JSON Schema
type ToolDefinition struct {
    Name        string                 `json:"name"`
    Description string                 `json:"description"`
    Parameters  map[string]interface{} `json:"parameters"`
}

// Usage 记录单次调用的 Token 消耗
type Usage struct {
    InputTokens  int
    OutputTokens int
    TotalTokens  int
}
Message 上的 IsError 标记工具执行失败时写入对话历史的结果消息,其使用场景将在工具箱章节中详述。Usage 除输入/输出 Token 外,TotalTokens 记录单次调用的合计消耗,供第 5.5 节的预算账本使用。
5.1.2 端口层设计
在 DDD / 六边形架构中,端口是领域层向外声明的接口契约,“我需要什么能力,但我不关心谁来实现”。在 Go 中,这便是“在使用侧定义接口”的最佳实践。
go
package domain

// LLMPort 是领域层对大模型能力的期望(被驱动端口)
type LLMPort interface {
    Chat(ctx context.Context, req ChatRequest) (*ChatResponse, error)
    StreamChat(ctx context.Context, req ChatRequest) (<-chan StreamEvent, error)
    Name() string
}

// ChatRequest / ChatResponse 是端口的数据传输对象
type ChatRequest struct {
    Model       string
    Messages    []Message
    Tools       []ToolDefinition
    Temperature float32
}

type ChatResponse struct {
    AssistantMessage Message
    ToolCalls        []ToolCall
    Provider         string // 实际完成本轮的 provider/model,用于精确计费
    FinishReason     string // "stop", "length", "tool_calls"
    Usage            Usage
}

type StreamEvent struct {
    Delta        string
    ToolCall     *ToolCall
    Usage        *Usage   // 最终计量可能晚于 finish_reason 到达
    Provider     string   // Fallback 后的实际 provider/model
    FinishReason string // "stop", "length", "tool_calls"
    Err          error   // SSE 解析、读取或服务端错误
    Done         bool
}

// ToolExecutor 是领域层对工具执行能力的期望
type ToolExecutor interface {
    ExecuteBatch(ctx context.Context, calls []ToolCall) []ToolResult
    GetDefinitions() []ToolDefinition
}

// ToolResult 是工具执行的通用返回值
type ToolResult struct {
    ToolCallID string
    Output     string
    IsError    bool
    Metadata   map[string]string `json:"metadata,omitempty"`
}

// HITLArbitrator 是领域层对人机审批能力的期望
type HITLArbitrator interface {
    RequestApproval(ctx context.Context, toolName, args, risk string) (approved bool, feedback string, err error)
}

// MemoryPort 是领域层对记忆管理能力的期望
// AgentContext 的完整定义见第 6 章,此处仅需了解它是 RunLoop 的核心状态载体
type MemoryPort interface {
    CompressIfNeeded(ctx context.Context, agentCtx *AgentContext) error
    ForceCompact(ctx context.Context, agentCtx *AgentContext) error
    SearchMemory(ctx context.Context, query string) string
}
ChatResponse.FinishReason 记录模型停止生成的原因(如 “stop”、“tool_calls”、“length”);当其值为 “length” 时表示输出被截断,状态机章节将实现对应的触顶恢复机制。MemoryPort.ForceCompact 在上下文紧急超限时强制执行深度压缩,调用时机详见状态机章节;方法签名中的 ctx 用于控制压缩过程的取消与超时。
分层依据见 5.1 节端口-适配器架构。
5.1.3 适配器层实现
有了端口定义,LLM 驱动器的角色就非常清晰,它是一个适配器,负责将外部 API 的脏活累活适配到领域层声明的干净端口上。适配器层可以厚,领域层必须薄。
go
package llm

type OpenAIProvider struct {
    apiKey  string
    baseURL string
    client  *http.Client
    model   string
}

func NewOpenAIProvider(apiKey, model string) *OpenAIProvider {
    return &OpenAIProvider{
        apiKey:  apiKey,
        baseURL: "https://api.openai.com/v1",
        client:  &http.Client{Timeout: 5 * time.Minute},
        model:   model,
    }
}

func (p *OpenAIProvider) Name() string { return "openai" }

func (p *OpenAIProvider) Chat(ctx context.Context, req domain.ChatRequest) (*domain.ChatResponse, error) {
    model := req.Model
    if model == "" {
        model = p.model
    }

    // 将 domain 类型转换为 OpenAI API 格式
    body := map[string]interface{}{
        "model":    model,
        "messages": convertMessages(req.Messages),
    }
    if len(req.Tools) > 0 {
        body["tools"] = convertToolDefs(req.Tools)
    }

    jsonBody, err := json.Marshal(body)
    if err != nil {
        return nil, fmt.Errorf("marshal request: %w", err)
    }
    httpReq, err := http.NewRequestWithContext(ctx, "POST", p.baseURL+"/chat/completions", bytes.NewReader(jsonBody))
    if err != nil {
        return nil, fmt.Errorf("create request: %w", err)
    }
    httpReq.Header.Set("Authorization", "Bearer "+p.apiKey)
    httpReq.Header.Set("Content-Type", "application/json")

    resp, err := p.client.Do(httpReq)
    if err != nil {
        return nil, err
    }
    defer resp.Body.Close()

    if resp.StatusCode != 200 {
        body, _ := io.ReadAll(resp.Body)
        return nil, &APIError{StatusCode: resp.StatusCode, Message: string(body)}
    }

    var result openaiResponse
    if err := json.NewDecoder(resp.Body).Decode(&result); err != nil {
        return nil, fmt.Errorf("decode response: %w", err)
    }

    return p.toDomainResponse(result), nil
}
5.1.4 流式解析与投递
对于需要“打字机效果”的 TUI 场景,StreamChat 是不可或缺的。OpenAI 和 Anthropic 都使用 Server-Sent Events (SSE)协议,我们需要逐行解析 data: {...} 格式的流式响应:
SSE 协议原理:SSE 建立在普通 HTTP 长连接之上,客户端发起 GET/POST 后,服务端保持连接不关闭,响应头设为 Content-Type: text/event-stream。与 WebSocket 的全双工不同,SSE 是单向(服务端 → 客户端),基于 HTTP 实现更简单,且浏览器原生支持 EventSource 自动重连(携带 Last-Event-ID)。
事件帧格式:每条 SSE 消息由若干行字段组成,以空行分隔:event: message(事件类型,可选)、data: {“choices”:[...]}(载荷,可多行)、id: 123(事件 ID,用于断线重连)。OpenAI 流式 API 简化为只发 data: 行,最后一帧为 data: [DONE] 表示流结束,解析器遇到 [DONE] 应关闭 channel 并释放 HTTP 连接。
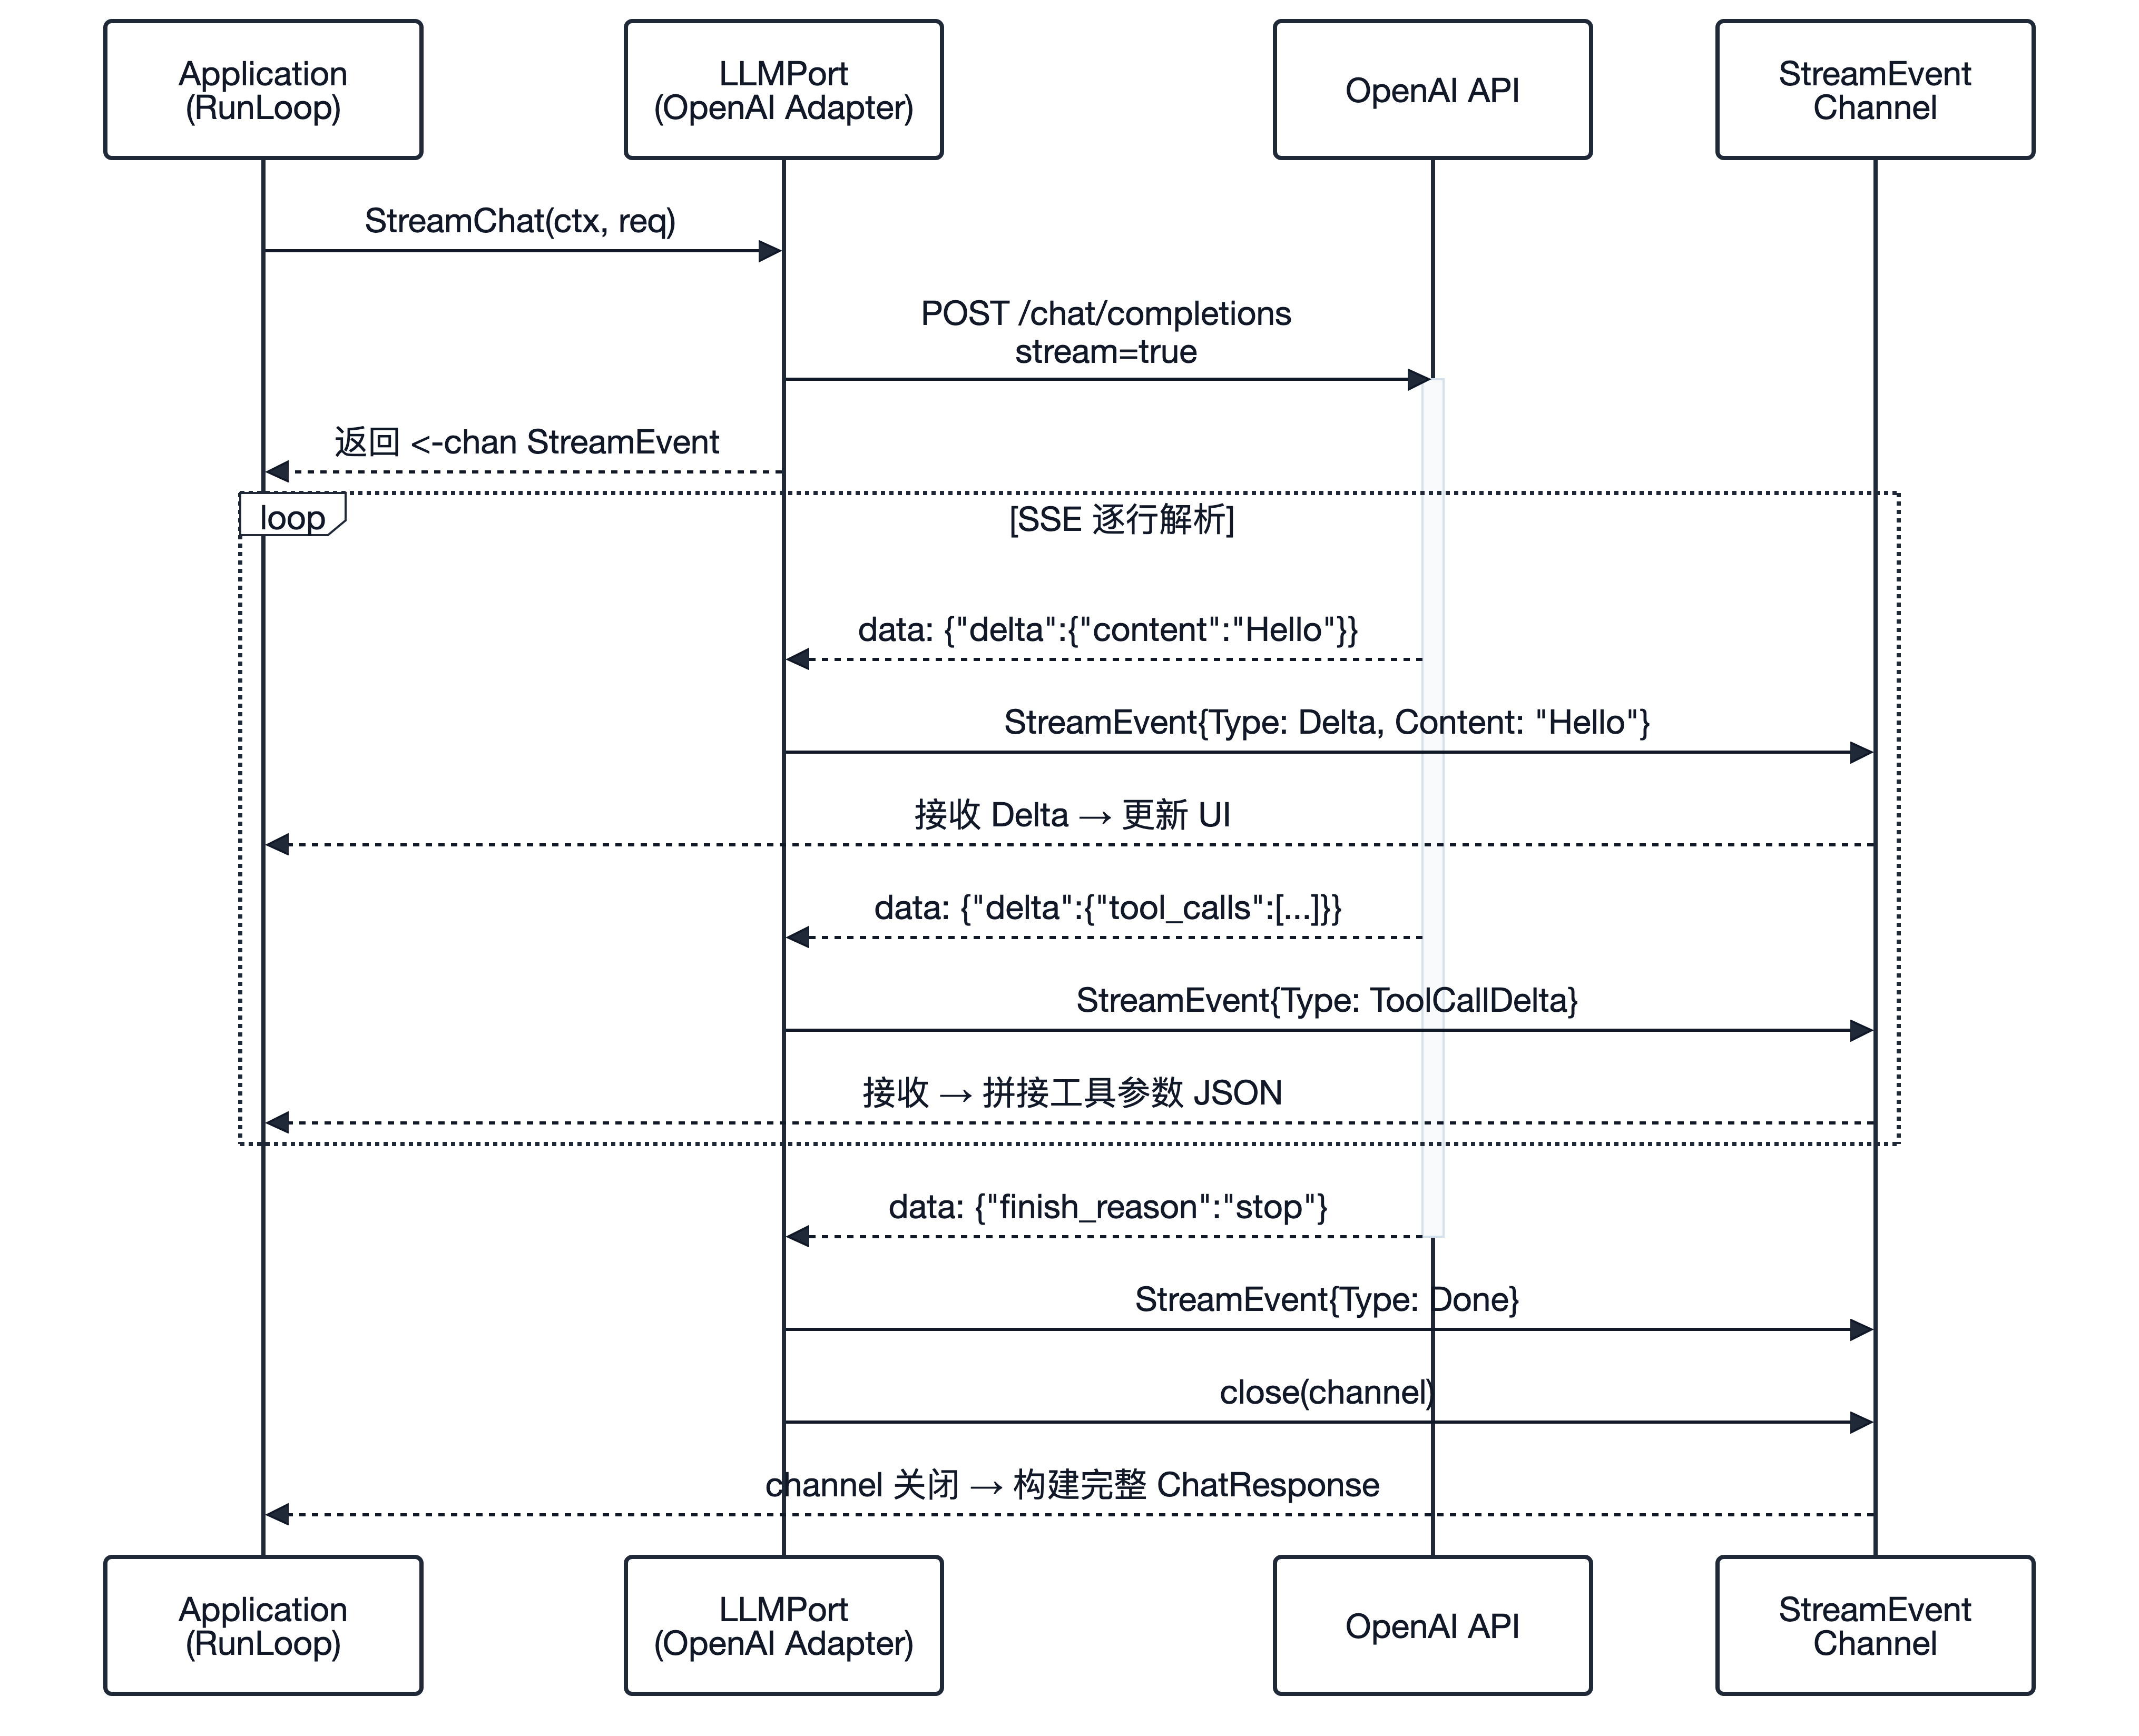
与 WebSocket 的选型差异:Agent 驱动器的流式场景只需“模型 → 客户端”单向推送,SSE 足够且防火墙友好;若需要客户端实时打断、双向心跳,才考虑 WebSocket,但这一选择意味着放弃浏览器原生 EventSource 的自动重连便利。工业实践中 OpenAI/Anthropic 均选 SSE,我们的适配器只需 bufio.Scanner 逐行读 data: 前缀即可。整条 SSE 流式链路的交互时序如图 5-1 所示。
go
func (p *OpenAIProvider) StreamChat(ctx context.Context, req domain.ChatRequest) (<-chan domain.StreamEvent, error) {
    body := map[string]interface{}{
        "model":    req.Model,
        "messages": convertMessages(req.Messages),
        "stream":   true, // 关键:开启流式
        "stream_options": map[string]bool{"include_usage": true},
    }
    if len(req.Tools) > 0 {
        body["tools"] = convertToolDefs(req.Tools)
    }

    jsonBody, err := json.Marshal(body)
    if err != nil { return nil, fmt.Errorf("marshal streaming request: %w", err) }
    httpReq, err := http.NewRequestWithContext(ctx, "POST", p.baseURL+"/chat/completions", bytes.NewReader(jsonBody))
    if err != nil { return nil, fmt.Errorf("create streaming request: %w", err) }
    httpReq.Header.Set("Authorization", "Bearer "+p.apiKey)
    httpReq.Header.Set("Content-Type", "application/json")

    resp, err := p.client.Do(httpReq)
    if err != nil {
        return nil, err
    }

    ch := make(chan domain.StreamEvent, 64)
    go func() {
        defer close(ch)
        defer resp.Body.Close()

        // tool_calls 分片到达:按 index 累积 name/arguments,流结束时再整体投递
        type accum struct {
            id   string
            name string
            args strings.Builder
        }
        pending := map[int]*accum{}
        var order []int

        flush := func() {
            for _, idx := range order {
                a := pending[idx]
                ch <- domain.StreamEvent{ToolCall: &domain.ToolCall{
                    ID:        a.id,
                    Name:      a.name,
                    Arguments: []byte(a.args.String()),
                }}
            }
        }

        var lastFinishReason string
        var usage *domain.Usage

        scanner := bufio.NewScanner(resp.Body)
        scanner.Buffer(make([]byte, 64*1024), 10*1024*1024)
        for scanner.Scan() {
            line := scanner.Text()
            if !strings.HasPrefix(line, "data:") {
                continue
            }
            data := strings.TrimSpace(strings.TrimPrefix(line, "data:"))
            if data == "[DONE]" {
                flush()
                ch <- domain.StreamEvent{Done: true, FinishReason: lastFinishReason, Usage: usage}
                return
            }

            var chunk openaiStreamChunk
            if err := json.Unmarshal([]byte(data), &chunk); err != nil {
                ch <- domain.StreamEvent{Err: fmt.Errorf("decode SSE chunk: %w", err), Done: true}
                return
            }
            if chunk.Error != nil {
                ch <- domain.StreamEvent{Err: fmt.Errorf("stream error: %s", chunk.Error.Message), Done: true}
                return
            }
            if chunk.Usage != nil {
                usage = &domain.Usage{
                    InputTokens: chunk.Usage.PromptTokens,
                    OutputTokens: chunk.Usage.CompletionTokens,
                    TotalTokens: chunk.Usage.TotalTokens,
                }
            }
            if len(chunk.Choices) == 0 {
                continue
            }
            choice := chunk.Choices[0]

            if choice.FinishReason != "" {
                lastFinishReason = choice.FinishReason
            }

            if choice.Delta.Content != "" {
                ch <- domain.StreamEvent{Delta: choice.Delta.Content}
            }
            for _, tc := range choice.Delta.ToolCalls {
                a := pending[tc.Index]
                if a == nil {
                    a = &accum{}
                    pending[tc.Index] = a
                    order = append(order, tc.Index)
                }
                if tc.ID != "" {
                    a.id = tc.ID
                }
                if tc.Function.Name != "" {
                    a.name = tc.Function.Name
                }
                a.args.WriteString(tc.Function.Arguments)
            }

            // 不在 finish_reason 出现时提前退出;最终 Usage 常在下一帧到达。
        }
        if err := scanner.Err(); err != nil {
            ch <- domain.StreamEvent{Err: fmt.Errorf("read SSE stream: %w", err), Done: true}
            return
        }
        ch <- domain.StreamEvent{Err: io.ErrUnexpectedEOF, Done: true}
    }()

    return ch, nil
}
FinishReason 与 Usage 传递:finish_reason 出现在最后一个 choice chunk 中,而 Usage 通常在其后的无 choices chunk 中到达。因此解析器记录 lastFinishReason 后仍须继续读取到 [DONE],再把 FinishReason 与 Usage 一并交给上层。若在 “tool_calls” 出现时提前 return,TUI 路径的 Token 与 Cost 将永久少算这一轮。
SSE 错误不是可忽略的噪声。默认 bufio.Scanner 只有 64 KiB token 上限,大型工具参数会触发 ErrTooLong,因此实现将上限提高到 10 MiB;JSON 破损、服务端 error 事件、扫描错误和未收到 [DONE] 的意外 EOF 均通过 StreamEvent.Err 显式上报。上层一旦看到 Err 就终止本轮,不能把残缺响应当作正常完成。
流式 Tool Call 的增量组装:与非流式不同,流式响应中 tool_calls 是分片到达的,第一个 chunk 可能只含 id 和 name 的前几个字符,后续 chunk 才追加 arguments 的 JSON 片段。适配器必须维护一个 buffer map (以 index 或 id 为 key),将每个 delta 的 function.name、function.arguments 字符串拼接,直到收到 finish_reason: “tool_calls” 或流结束,才尝试 json.Unmarshal 完整的 arguments。若直接对每个 chunk 做 Unmarshal,必然失败,这是流式 Function Calling 适配器最容易踩的坑。
接入层解决了"如何统一对接不同供应商"的问题;但当某个供应商不可用时,系统需要自动降级到备选模型——这是下一节的主题。
5.2 多模型供应商降级机制
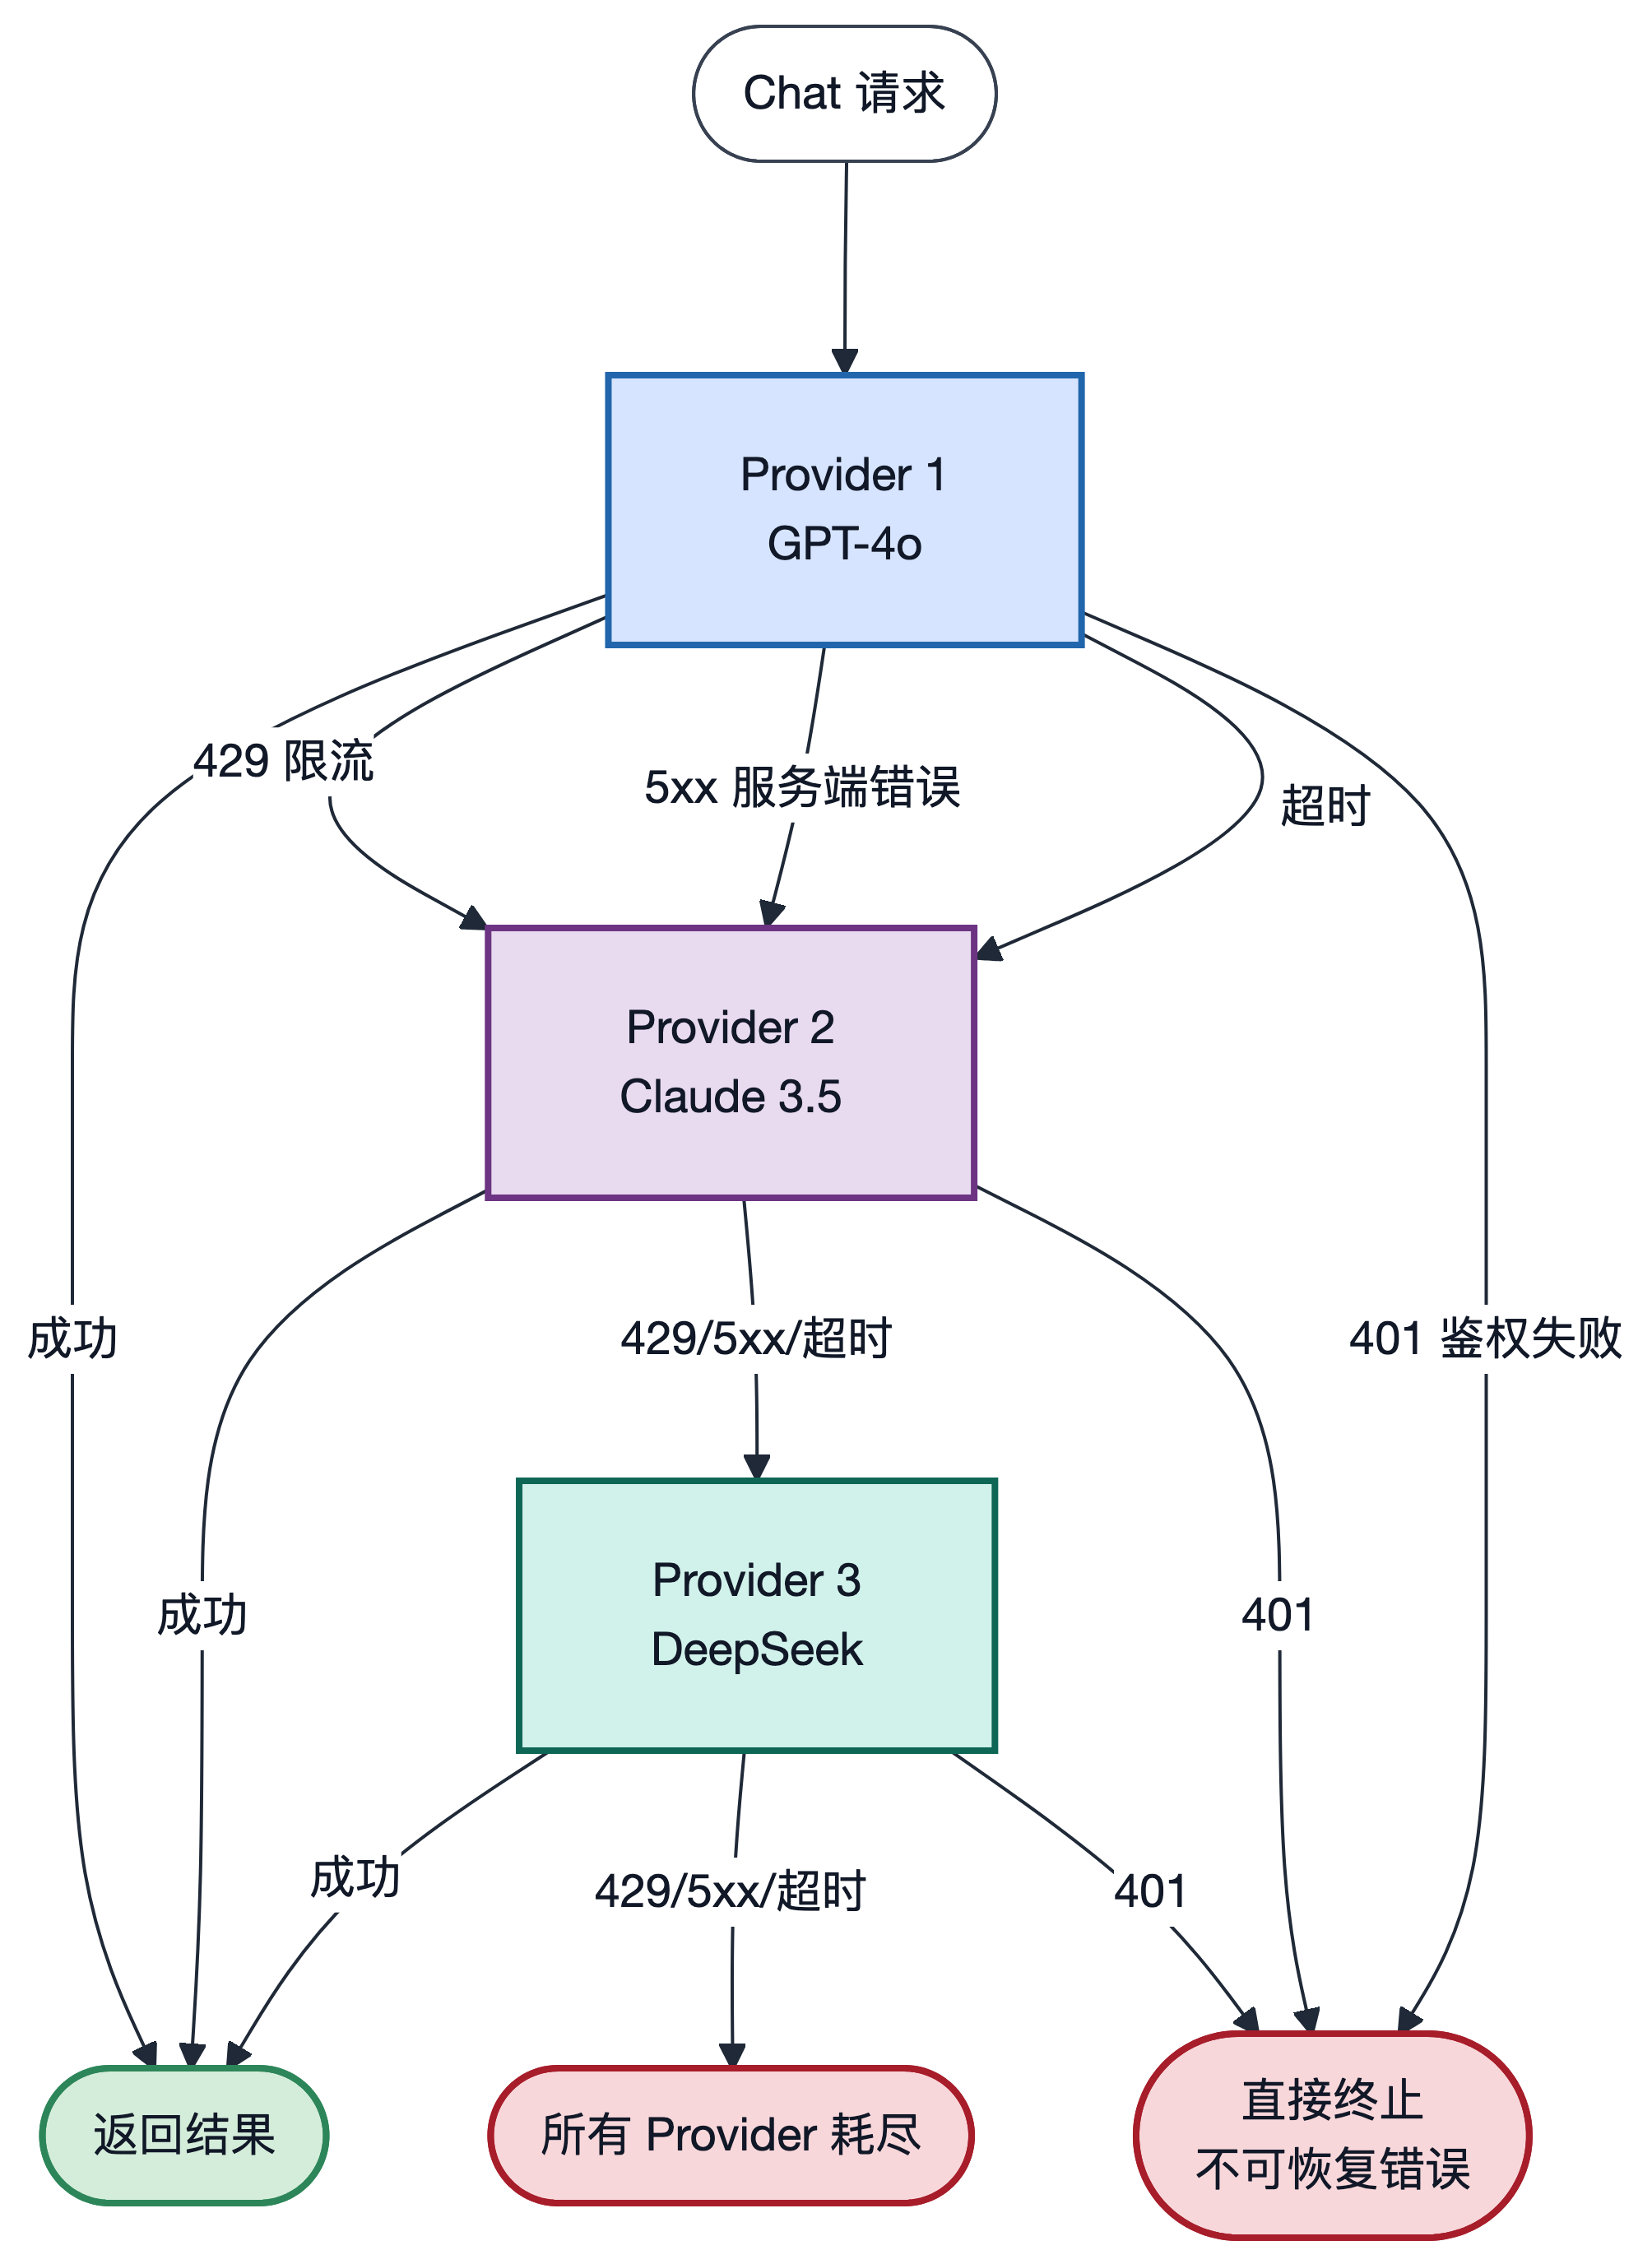
当单一模型触发限流或宕机时,Agent 不应该直接报错。我们用一个 FallbackProvider 组合多个 Provider,自动尝试下一个:
本章“熔断”与 Fallback Chain 的澄清:章首导语提到的“熔断机制”在当前实现中体现为 顺序降级(Fallback Chain),某个 Provider 返回 429/5xx 时立即尝试下一个,而不是经典熔断器(Circuit Breaker)的三态模型。顺序降级没有“失败计数窗口”和“半开探测”,每次请求都会重试首选 Provider,适合跨厂商备份场景;经典熔断适合同一端点反复失败时快速 fail-fast,避免雪崩。后续状态机章节将引入简化的连续失败计数熔断,届时两者可组合:单 Provider 外层套熔断,多 Provider 外层套 Fallback。
Fallback Chain 的能力不对等风险:不同厂商旗舰模型的工具调用能力、上下文窗口、JSON 遵从度并不相同,降级成功不等于行为等价。用户侧可能无感知,但 Agent 侧可能悄然变差:长上下文任务切到短窗口模型后,中间轮次的 tool result 被截断,模型在下一轮基于残缺信息继续推理;JSON 遵从度较弱的备用模型可能连续输出格式错误的 tool_calls,触发自愈重试循环,Token 账单在后台翻倍。Fallback 后应记录 provider_used 字段,必要时调整 temperature 或简化 tool schema;对于强依赖特定模型能力的 Agent (如长上下文代码分析),降级链末位应配置能力相近的模型,而不是随意塞一个便宜模型。
go
type FallbackProvider struct {
    providers []domain.LLMPort
}

func NewFallbackProvider(providers ...domain.LLMPort) *FallbackProvider {
    return &FallbackProvider{providers: providers}
}

func (f *FallbackProvider) Name() string { return "fallback" }

func (f *FallbackProvider) Chat(ctx context.Context, req domain.ChatRequest) (*domain.ChatResponse, error) {
    var lastErr error
    for _, p := range f.providers {
        resp, err := p.Chat(ctx, req)
        if err == nil {
            return resp, nil
        }
        lastErr = err

        var apiErr *APIError
        if errors.As(err, &apiErr) && apiErr.StatusCode == 429 {
            slog.Warn("provider rate limited, falling back", "provider", p.Name())
            continue // 限流,切换下一个
        }
        if errors.As(err, &apiErr) && apiErr.StatusCode >= 500 {
            slog.Warn("provider error, falling back", "provider", p.Name(), "status", apiErr.StatusCode)
            continue // 服务端错误,切换下一个
        }
        return nil, err // 非临时性错误(如 401),直接终止
    }
    return nil, fmt.Errorf("all providers exhausted: %w", lastErr)
}

func (f *FallbackProvider) StreamChat(ctx context.Context, req domain.ChatRequest) (<-chan domain.StreamEvent, error) {
    var lastErr error
    for _, p := range f.providers {
        ch, err := p.StreamChat(ctx, req)
        if err == nil {
            return ch, nil
        }
        lastErr = err
        var apiErr *APIError
        if errors.As(err, &apiErr) && (apiErr.StatusCode == 429 || apiErr.StatusCode >= 500) {
            continue
        }
        return nil, err
    }
    return nil, fmt.Errorf("all providers exhausted: %w", lastErr)
}
上述降级链路的完整流程如图 5-2 所示。
在组合根(main.go)中,只需一行即可装配:
组合根(见 §13.4)在此将 FallbackProvider、工具注册表和 MemoryPort 一次性装配并注入 Agent:
go
llmPort := llm.NewFallbackProvider(
    llm.NewOpenAIProvider(os.Getenv("OPENAI_API_KEY"), "gpt-5"),
    llm.NewAnthropicProvider(os.Getenv("ANTHROPIC_API_KEY"), "claude-sonnet-4-6"),
)
5.3 工具模式的反射生成
目前主流的大模型都支持 Function Calling(工具调用),其核心要求是将工具的参数定义转换为严格的 JSON Schema 传给大模型。
Function Calling 完整闭环从 API 侧开始:驱动器将 ToolDefinition 转换为 OpenAI tools 数组(每项含 type: “function”, function.name, function.description, function.parameters JSON Schema),随 messages 一并 POST 到 /chat/completions;Anthropic 侧对应 tools[].input_schema。模型在推理过程中若判断需要外部能力,会在响应中输出 tool_calls 数组(含 id, function.name, function.arguments JSON 字符串),finish_reason 设为 “tool_calls” 而不是 “stop”,表示“我需要先执行工具,再继续回答”。
更关键的是 Runtime 侧的回灌:Agent 循环解析 tool_calls,调用 ToolExecutor.ExecuteBatch 执行本地工具,将结果封装为 role: “tool” 消息(含 tool_call_id 与 output 字符串),追加到对话历史。带着 tool result 再次调用 Chat,模型基于真实数据继续生成最终回答或发起下一轮 tool call,这一 loop 可能迭代多轮,直到 finish_reason: “stop”。
在 Python 或 TS 中,你可能需要手写一大串冗长、易错的字典(Dict/Object)来描述 Schema。但在 Go 语言中,我们可以利用强大的反射和结构体标签,实现 Schema 的全自动生成。
想象一下,你只需要定义这样一个 Go 结构体:
go
type ReadFileArgs struct {
    Path     string `json:"path" jsonschema:"description=The absolute or relative path to the file"`
    MaxLines int    `json:"max_lines,omitempty" jsonschema:"description=Maximum lines to read to prevent token overflow"`
}
在底层驱动器中,我们编写一个 GenerateSchema 函数,在程序启动时通过反射扫描 ReadFileArgs:从 json tag 提取属性名,从 jsonschema tag 提取描述,再按 Go 底层类型(string、int 等)映射为 JSON Schema 的 type。反射生成 Schema 是否优于手写字典,尚无定论,复杂嵌套结构时反射可能力不从心,但简单工具参数的场景下,它几乎消除了 Schema 与 struct 漂移的风险。
go
func GenerateSchema(v interface{}) map[string]interface{} {
    t := reflect.TypeOf(v)
    if t.Kind() == reflect.Ptr {
        t = t.Elem()
    }

    properties := make(map[string]interface{})
    required := []string{}

    for i := 0; i < t.NumField(); i++ {
        field := t.Field(i)
        jsonTag := field.Tag.Get("json")
        if jsonTag == "" || jsonTag == "-" {
            continue
        }

        parts := strings.Split(jsonTag, ",")
        name := parts[0]
        optional := len(parts) > 1 && parts[1] == "omitempty"

        prop := map[string]interface{}{
            "type": goTypeToJSONType(field.Type),
        }

        // 从 jsonschema tag 中提取 description
        if schemaTag := field.Tag.Get("jsonschema"); schemaTag != "" {
            for _, part := range strings.Split(schemaTag, ",") {
                kv := strings.SplitN(part, "=", 2)
                if len(kv) == 2 {
                    prop[kv[0]] = kv[1] // 如 description=xxx, enum=a|b|c
                }
            }
        }

        properties[name] = prop
        if !optional {
            required = append(required, name)
        }
    }

    return map[string]interface{}{
        "type":       "object",
        "properties": properties,
        "required":   required,
    }
}

func goTypeToJSONType(t reflect.Type) string {
    switch t.Kind() {
    case reflect.String:
        return "string"
    case reflect.Int, reflect.Int32, reflect.Int64:
        return "integer"
    case reflect.Float32, reflect.Float64:
        return "number"
    case reflect.Bool:
        return "boolean"
    case reflect.Slice:
        return "array"
    default:
        return "string"
    }
}
这种做法保证了 Go 代码类型与给到 LLM 的 Schema 永远保持强一致,新增工具只需定义一个 struct,Schema 自动生成。
5.4 防护线与容错机制
即便你提供了有效的 JSON Schema,大模型依然有可能犯错(所谓“幻觉”),比如少写一个引号,或者凭空捏造了一个并不存在的工具调用。
对于工业级 Agent 来说,遇到 JSON 解析报错直接 Panic 退出意味着一次模型幻觉就能终止整段用户会话,正在执行的代码审查、尚未落盘的文件编辑,全部随进程退出而丢失。我们必须在 LLM 驱动器内部构建一道“强类型防线”。
5.4.1 结构化反序列化
当大模型返回工具调用的 JSON 字符串时,我们直接将其尝试绑定到(Unmarshal)之前定义好的 Go 结构体上。如果有任何类型不匹配(比如把数字包在了字符串里),Go 原生的 encoding/json 库会立即报错。
Strict Unmarshaling 的分层职责:标题中的 “Strict” 在工业实现中通常包含两层,语法层:json.Decoder.DisallowUnknownFields() 拒绝模型捏造的未知字段;语义层:Unmarshal 后做自定义校验(如 Path 不能为空、MaxLines > 0),可用 go-playground/validator 或手写 Validate() error。这与 JSON Schema 验证层 分工不同:Schema 在请求前约束模型输出格式;Strict Unmarshal 在收到响应后构成最后一道防线,Schema 管“模型应该输出什么”,Unmarshal 管“实际收到了什么”。当前示例代码用的是普通 json.Unmarshal,生产环境应升级为 DisallowUnknownFields + 自定义校验的组合。
5.4.2 数据残缺自愈机制
当捕获到解析错误或参数不合法时,驱动器绝不抛弃当前上下文。它会自动向模型追加一条系统级消息,强迫模型自行纠错。在把错误喂回去之前,还有更便宜的一刀:RepairJSON 处理围栏、尾逗号、Python 字面量这类“几乎合法”的参数,只有修复结果再次通过 json.Valid 才采纳——修不好才走下面的自愈环,避免一次失败的重写把更坏的字节交给工具。
幻觉分类与自愈策略:大模型在 Function Calling 中的“幻觉”可分三类,格式错(JSON 缺括号、类型不匹配)→ 先 RepairJSON,仍失败再 feed 解析 error 让模型重输出;捏造工具名(调用了不存在的 delete_all_files)→ 返回可用工具列表提示;参数臆造(字段不存在或值越界)→ 结合 DisallowUnknownFields 报错 + Schema 片段提醒。自愈应设重试上限(通常 2-3 次),避免无限 loop 烧钱。
对话链污染问题:错误 feedback 消息会永久留在对话历史中,若重试成功,早期的失败 attempt 仍占用 Token。工业实践有两种策略:一是保留(模型能看到自己犯过错,有助于后续遵从);二是在成功后折叠错误轮次,只保留最终正确的 tool call。无论哪种,都应在 Usage 账本中单独统计自愈重试的 Token 开销。
go
func ParseArgs[T any](rawArgs []byte) (T, error) {
    var args T
    payload := rawArgs
    if !json.Valid(rawArgs) {
        if fixed, ok := RepairJSON(rawArgs); ok {
            payload = fixed
        }
    }
    if err := json.Unmarshal(payload, &args); err != nil {
        return args, fmt.Errorf("invalid arguments: %w", err)
    }
    return args, nil
}

// 修不好才把错误喂回模型(以 OpenAI 适配器为例)
func (p *OpenAIProvider) CallTool(ctx context.Context, response string) error {
    args, err := ParseArgs[ReadFileArgs]([]byte(response))
    if err != nil {
        errorMsg := fmt.Sprintf(`{"error": "Invalid JSON parameters: %v. Please output strictly conforming JSON."}`, err)
        return p.Retry(ctx, errorMsg)
    }
    return execute(args)
}
通过这套机制,大模型的输出被严格约束在 Go 的强类型系统中。
5.5 Token 管理与并发安全
大模型按 Token 计费,厂商 API 还有严格的 RPM/TPM 限制和有限的上下文窗口,这些约束不会因为 Agent 写得优雅而消失。不加控制的话,几十个并发 Goroutine 可能在数分钟内耗尽月度配额。Token 管理不是可选优化,是驱动器的生存底线。
5.5.1 计数与预算管理
在发送请求给大模型之前,驱动器应能在本地精确估算当前的 Token 数量。等到 API 返回 413 Payload Too Large 再处理,不仅浪费一次往返,还可能让 Agent 状态机卡在半完成的 tool call 中间,回滚代价远高于前置拦截。
在 Go 中,我们可以接入类似 tiktoken-go 的分词器库:
BPE 分词原理:Byte Pair Encoding 是一种数据驱动的 prefix-free 编码,从字节级词表出发,迭代合并语料中最高频的相邻字节对,直到词表达到目标大小(如 100k)。GPT 系列用 cl100k_base (100,277 tokens),GPT-4o 及后续模型用 o200k_base (200k tokens),不同模型 encoding 不同,混用会导致计数偏差甚至 API 拒收。tkm.Encode(text, allowedSpecial, disallowedSpecial) 返回 token ID 整数数组,每个 ID 对应词表中的一个 subword;数组长度即 Token 数,直接决定 API 计费与上下文窗口占用。
go
// 离线 Token 估算机制
func EstimateTokens(messages []Message, model string) int {
    // 根据模型选择合适的分词器 (BPE)
    tkm, err := tiktoken.EncodingForModel(model)
    if err != nil {
        return 0 // fallback 处理
    }

    totalTokens := 0
    for _, msg := range messages {
        // 加上消息包裹的额外 overhead tokens
        totalTokens += 3
        totalTokens += len(tkm.Encode(msg.Content, nil, nil))
    }
    return totalTokens + 3 // 加上 assistant 预留
}
Token overhead 中 +3 / +4 的来源:OpenAI 官方 Token 计数规则对每条 message 有固定 framing overhead,每条消息 +3 tokens (<|start|>role<|end|> 等特殊 token 的等效开销),整段对话首尾各 +3 tokens (<|start|>system/priming 包装)。不同 role (system/user/assistant/tool)的精确值略有差异(assistant 回复有时按 +3 计,tool 消息另算),tiktoken-go 提供了 Encode 级别的分词能力,上述 framing overhead 需使用者按 OpenAI Cookbook 规则自行累加。代码中 +3 per message 和末尾 +3 是工程近似,生产环境建议封装一个 CountMessageTokens 工具函数统一处理各角色的 overhead,而不是在各处手写 magic number。
在驱动器的核心逻辑中,我们会维护一个全局的预算管理器。每次估算后,如果发现 totalTokens > MAX_WINDOW - BUFFER(例如 128k 窗口减去 13k 缓冲),驱动器将主动触发后续章节详述的“上下文压缩管道”,而不是盲目发送请求。
5.5.2 并发计费与速率限制
为了确保并发安全,我们使用 sync/atomic 包,在内存中维护一个全局的 Token 累加器。每一次大模型响应回来,无论有多少协程在并行,都能无锁地精准记录账单。同时,使用 Go 原生的 golang.org/x/time/rate 包(基于令牌桶算法),在 Chat 方法入口处做限流。
令牌桶算法原理:rate.NewLimiter(r, b) 中 r 是 refill rate (如 rate.Every(time.Second) = 每秒补 1 个 token),b 是 burst (桶容量),允许瞬时突发 b 个请求而不等待,之后按 rate 匀速补充。limiter.Wait(ctx) 若桶空则阻塞当前 Goroutine 直到有 token 或 ctx 取消,比 busy-loop 或 sleep 估算更精确。
与 API RPM/TPM 双限流的差异:厂商通常同时限制 RPM (Requests Per Minute,按次)和 TPM (Tokens Per Minute,按 Token 量),一个令牌桶只能管一维。工业实践需维护两个 速率限制器(Rate Limiter):请求入口用 RPM 桶防 QPS 超限,发送前用 TPM 桶按 EstimateTokens 扣减。仅限制请求次数无法防止“单次超大 prompt 打爆 TPM 配额”,高并发下若无限流,Agent 可能在数分钟内耗尽 API 配额。
go
// 全局账本与基于 Token Bucket 的限流器
var (
    totalInputTokens  atomic.Uint64
    totalOutputTokens atomic.Uint64
    // 假设 API 限制:每秒最多 5 次请求
    limiter = rate.NewLimiter(rate.Every(time.Second), 5)
)

func (p *MyProvider) Chat(ctx context.Context, req ChatRequest) (*ChatResponse, error) {
    // 1. 本地估算与预算拦截
    if EstimateTokens(req.Messages, req.Model) > GetSafeWindow(req.Model) {
        return nil, ErrPromptTooLong
    }

    // 2. 如果超过速率,自动阻塞当前 Goroutine 等待,而不是直接被服务器拒绝
    if err := limiter.Wait(ctx); err != nil {
        return nil, err
    }

    // 3. 发起真正的 HTTP 请求
    resp, err := doRequest(ctx, req)

    // 4. 并发安全地记账
    if err == nil {
        totalInputTokens.Add(uint64(resp.Usage.InputTokens))
        totalOutputTokens.Add(uint64(resp.Usage.OutputTokens))
    }
    return resp, err
}
5.6 适配器格式处理
解决了计费与限流后,驱动器还需处理不同厂商间的消息格式差异——这往往是接入多模型时最容易踩坑的地方。
Anthropic 的 Messages API 与 OpenAI 的格式差异显著。适配器的价值在这里充分体现,这些脏活全部封装在适配器内部,对 domain.LLMPort 的调用者完全透明:
Anthropic Content Block 模型:Anthropic 的消息不是纯字符串,而是 content block 数组,每 block 有 type 字段(text / tool_use / tool_result / image 等)。assistant 回复可能是 [{type:“text”, text:“...”}, {type:“tool_use”, id:“...”, name:“...”, input:{...}}] 的组合。block 顺序有约束:tool_result block 必须出现在 user role 消息中,且每个 tool_result 的 tool_use_id 必须配对先前 assistant 消息里的 tool_use.id,不能乱序或遗漏,否则 API 返回 400。
tool_use → tool_result 配对规则:一轮 tool call 的生命周期是,assistant 输出 tool_use block → 客户端执行工具 → 下一条 user 消息(注意不是 tool role)携带 tool_result block → 模型继续推理。适配器的 convertToAnthropicMessages 和 toDomainResponse 负责在这套 block 模型与 OpenAI 风格的 role: tool 消息之间双向翻译。
go
type AnthropicProvider struct {
    apiKey string
    model  string
    client *http.Client
}

func (p *AnthropicProvider) Chat(ctx context.Context, req domain.ChatRequest) (*domain.ChatResponse, error) {
    // Anthropic 要求 system 从 messages 中分离出来作为顶层字段
    systemPrompt, messages := extractSystem(req.Messages)

    body := map[string]interface{}{
        "model":      p.model,
        "max_tokens": 8192,
        "system":     systemPrompt,
        "messages":   convertToAnthropicMessages(messages),
    }
    if len(req.Tools) > 0 {
        body["tools"] = convertToAnthropicTools(req.Tools)
    }

    httpReq.Header.Set("x-api-key", p.apiKey)
    httpReq.Header.Set("anthropic-version", "2023-06-01")
    // POST /v1/messages;不能复用 OpenAI 的 /chat/completions 与 Bearer 鉴权。
    // Anthropic 返回的 tool_use 在 content blocks 中,需要逐块提取
    return p.toDomainResponse(result), nil
}
关键差异对照,如表 5-1 所示。
表 5-1 OpenAI 与 Anthropic 接口差异
| 维度 | OpenAI | Anthropic |
|---|---|---|
| 系统提示词 | messages[0].role = “system” | 顶层 system 字段 |
| 工具调用 | tool_calls[] 在 assistant message 中 | content[].type = “tool_use” |
| 工具结果 | role: “tool” 的独立消息 | role: “user” 中 type: “tool_result” 的 content block |
| 流式结束标志 | data: [DONE] | event: message_stop |
Anthropic 流式适配器按事件类型推进:message_start 读取输入 Token,content_block_start/delta/stop 组装文本与 tool_use,message_delta 读取 stop_reason 和输出 Token,message_stop 发出最终 Done;error 事件则转成 StreamEvent.Err。这条状态机与 OpenAI 的 choice chunk 结构不同,不能只替换 Base URL 来兼容。
所有这些差异对上层 Agent 完全不可见,这就是端口-适配器架构的价值。
LLM 驱动器不是“调 API 的薄封装”,而是 Agent 与外部世界之间的契约层:它把三家厂商各自为政的消息格式收束为统一的 domain.Message,把模型输出的不确定性拦截在强类型边界之内,把 Token 消耗和 API 配额纳入可预测的账本。驱动器建得是否扎实,直接决定后续状态机能否专注于“思考与行动”的循环,而不必在每个回合重复处理格式转换与容错。下一章,我们将在这层基础之上实现 Agent 的状态机与循环体。