主题
第 8 章:状态折叠与上下文流水线
:::
阅读建议:如果时间有限,聚焦三级防波堤的架构逻辑(滑动窗口、摘要压缩、RAG 检索),即可理解整体策略;Rolling Buffer 实现、Token 估算公式等适合需要调参时回读。
:::
第六、七章实现了状态机与工具箱;接下来关注长时间运行时同样关键的记忆系统。
在处理大型代码库时,终端日志、文件读取结果会大量涌入上下文。当前主流旗舰大模型虽然号称支持 128K 甚至 200K 的超长上下文窗口,但如果我们将几万行的编译报错全部生硬地塞进历史记录中,会带来两方面严重影响:
- Lost in the Middle (中间注意力丧失):模型会被无关日志干扰,忘记最初的目标。
U 型注意力曲线:Liu 等人在 Lost in the Middle 论文中系统验证了长上下文下的 recall 分布,模型对开头和结尾位置信息的检索准确率显著高于中间段落。在 needle-in-a-haystack 实验中,当关键事实被插入到上下文 50% 位置附近时,recall 率可跌至个位数;而同样信息放在前 10% 或后 10% 时,准确率接近满分。这不是个别模型的偶发 bug,而是 Transformer 架构在长序列推理中的结构性倾向。
与位置编码的关联:该现象与 RoPE、ALiBi 等相对位置编码在长序列上的精度衰减密切相关。RoPE 通过旋转矩阵编码相对距离,序列越长,远端词元 之间的角度分辨率越粗,“中间区域”的位置信号在注意力矩阵中逐渐被稀释。ALiBi 虽能外推更长上下文,但远端位置的 attention bias 同样会弱化中间段落的可区分性。换言之,Lost in the Middle 既是注意力分配问题,也是位置表征问题,模型并非“故意忽略”中间内容,而是在有限的有效注意力带宽下,首尾信号天然占优。
对 Agent 设计的启示:理解了 U 型曲线,Compaction Stack 的放置策略就有了理论依据,系统提示词(角色、约束、项目规范)必须锚定开头,因为每轮 API 调用都会完整重发,开头是模型最稳定的高 recall 区;最近几轮 user/assistant 对话保留在尾部,因为“当前任务状态”需要最高注意力权重。被 Snip 或 deepCompact 压掉的恰恰是中间段的冗长 tool 输出,它们信息密度低、位置 recall 又最差,丢弃的 ROI 最高。产品侧向用户解释“Agent 忘了早期细节”时,可以诚实说明:这不是 bug,而是当前 LLM 架构在长上下文下的已知边界。
- 钱包危机:截断前的 5000 行
npm install日志约折合 8 万 Token;若会话再跑 20 轮推理,同一批日志会被完整重发 20 次,按 Sonnet 级定价粗算,单条工具输出会大幅增加无效计费。账单不会一次性爆炸,而是随轮次线性累积。
上述问题都受 上下文窗口 容量约束:模型单次 API 调用能接收的 Token 总量有限,超出后旧消息须被截断或压缩,否则 Agent 会“失忆”并触发计费失控。
下面用 Go 语言构建三级防波堤,再现 Claude Code 和 Pi 中的 Token 压缩管道与双层记忆。
8.1 智能体记忆的理论模型与业务场景
上述两个问题,注意力稀释与 Token 账单,都指向同一根因:上下文里没有区分“此刻需要的”与“可以归档的”。要设计有效的压缩策略,先得厘清记忆该存什么、存多久。认知科学与产品实践中,智能体的记忆通常被划分为短期记忆(工作记忆)与长期记忆;对 CLI 代码助手而言,这一划分直接决定了“该记住什么”。
8.1.1 短期记忆与长期记忆的边界
- 短期记忆 / 工作记忆 短期记忆是智能体维护当前对话和任务的即时上下文系统。它主要包括:
- 会话缓冲(Context):保留最近对话历史的滚动窗口,确保当前回答的上下文相关性。
- 工作记忆:存储当前任务的临时信息,如中间计算结果、工具调用的返回日志、临时变量等。
工程映射:短期记忆受限于 LLM 的上下文窗口大小,适用于简单对话和单一任务场景。本书 8.2 节的“滑动窗口”和 8.3 节的“触发式压缩”,解决的就是短期记忆容量受限与溢出的问题。
- 长期记忆 长期记忆是智能体用于跨会话、跨任务长期保存知识的记忆形式,对应人类大脑中持久保存的事实与经历。它的实现通常依赖于外部存储,包括:
- 摘要记忆:将长对话内容提炼为关键摘要存储(如本书的 Session Memory)。
- 结构化知识库:使用关系型数据库或知识图谱存储结构化信息。
- 向量化存储:通过向量数据库实现基于语义的记忆检索。
工程映射:长期记忆使智能体能够随着时间累积经验,特别适用于知识密集型应用和需要长期个性化的场景。本书 8.4 节的“后台书记员”与 8.5 节的“项目记忆”,就是长期记忆在本地 Agent 中的轻量级落地。
8.1.2 代码助手的记忆取舍
对 CLI 代码助手而言,记忆系统的核心决策是判断哪些信息值得长期保存。短期工作记忆承载当前任务的工具返回与中间状态,随上下文窗口一起被压缩;长期记忆则沉淀项目上下文与用户偏好,代码库结构、命名风格、常用框架,以及过往的纠错指令。
没有持久记忆时,开发者往往每开新会话就要重述架构约定;引入 Project Memory 后,Agent 才能跨会话保持技术决策一致,避免重复推理同一类问题。并非所有对话都值得长期保存,Compaction Stack 要优先保留对当前任务有决策价值的片段,而不是把整段会话原样归档。
接下来,我们将用 Go 语言从底向上构建这套包含短/长期记忆的“三级防波堤”。
8.2 第一级缓冲设计
第 7 章的 BashTool 已经使用了 RollingOutputBuffer 来截断输出,本节展开其内部实现。回顾当时的场景:如果大模型意外执行了 npm install 或者 find /,海量的终端输出会迅速占满进程内存。
我们不应使用 cmd.CombinedOutput() 去等待所有输出,而要用一个基于环形缓冲区的滑动截断器来控制体积。
名称来源与实际机制的差异:工业界习惯用 “环形缓冲区(Ring Buffer)” 描述固定容量、流式写入、溢出覆盖的输出截断器,经典实现中,写指针到达数组末尾后回绕到索引 0,形成首尾相接的环,旧数据被新数据原地覆盖,内存占用恒定为 O(capacity)。Claude Code 的 Rolling Buffer 借用了这一命名,但我们的 Go 实现并非 classic ring buffer:当 lines 超过 maxLines 时,代码执行的是头尾切片拼接,保留 headSize 行头部 + tailSize 行尾部,中间整段丢弃并累加 dropped 计数,而不是环形覆盖。语义上更接近 “头尾保留缓冲(Head-Tail Retention Buffer)”。之所以仍称 Ring Buffer,是因为它与 Claude Code 源码及 Pi 文档中的术语对齐,且共享同一设计意图:恒定内存上限 + 流式写入 + 溢出时丢弃中间段。读者应注意这一实现差异。
8.2.1 滑动窗口的防线定位
在 Claude Code 的四级压缩管道里,工具结果预算(Tool Result Budget) 排在最前面,它不等 Token 累积到危险线才动手,而是在工具刚执行完、结果还没写入 messages 之前就介入。
要理解它的必要性,先看清 Agent 上下文里 Token 的两条增长路径,如表 8-1 所示。
表 8-1 上下文 Token 增长路径
| 增长来源 | 典型场景 | 单次体量 | 是否可重复发送 |
|---|---|---|---|
| 对话骨架 | user 提问、assistant 推理、tool_call 参数 | 几百~几千 Token | 每轮 API 调用都会重发 |
| 工具输出 | npm install 日志、cat 大文件、测试报告 | 可达数万 Token | 每轮 API 调用都会重发 |
关键洞察:工具输出是 Token 爆炸的第一元凶,且往往信息密度极低。 5000 行依赖解析日志里,真正有用的可能只有最后 20 行的 ERR! 报错。不做截断,后果是双重的:Go 进程可能因内存占满而 OOM;更隐蔽的是,一旦写入 messages,此后每一轮对话都会完整重发,不是浪费一次,而是浪费 N 次。
因此第一道防线的定位是:在源头止血,把单次工具调用的输出体积锁死在可控上限内,而不是等它进入历史后再想办法删。
8.2.2 滑动窗口截断原理
这个策略直接借鉴 Claude Code 的 applyToolResultBudget() 和滚动缓冲,不是随机截断,而是基于终端输出的信息分布规律做有选择的保留。
为什么保留开头?
- 命令本身和初始参数(
npm install --legacy-peer-deps) - 早期的配置警告、版本冲突提示
- 环境信息(Node 版本、路径错误等)
为什么保留结尾?
- 编译/安装的最终状态(
success/failed) - 错误堆栈几乎总在末尾,这是模型决定“下一步怎么办”的最关键信号
- exit code 相关的摘要信息
为什么丢弃中间?
- 重复的进度条、逐行依赖解析、重复的
Downloading...日志 - 这些信息对“理解发生了什么”贡献极低,却常常占据上下文中的大头
用一个具体例子说明。假设 npm install 产出了约 5000 行输出,截断后模型看到的内容分为三段:
头部保留区(约 50 行)——命令本身与初始输出:
> npm install
npm WARN deprecated inflight@1.0.6
added 847 packages in 23s中段丢弃区(约 4800 行)——重复的下载日志:
npm http fetch GET 200 https://registry.npmjs.org/lodash/-/lodash-4.17.21.tgz
npm http fetch GET 200 https://registry.npmjs.org/express/-/express-4.18.2.tgz
... [重复 4800 行,全部丢弃] ...尾部保留区(约 50 行)——最终状态与错误堆栈:
npm ERR! code ERESOLVE
npm ERR! ERESOLVE unable to resolve dependency tree
npm ERR! Found: react@17.0.2
npm ERR! Could not resolve dependency: peer react@"^18.0.0" from react-dom@18.2.0
模型看到截断后的结果,依然能准确判断:“依赖冲突,React 版本不匹配,需要升级或 --legacy-peer-deps”。中间 4800 行的 download 日志对它毫无价值。
与后续压缩的区别: 第一道防线是写入前截断(工具执行时),第二道防线 Snip 是写入后修剪(历史消息里)。前者防“洪水入库”,后者防“水库水位上涨”。
go
type RollingOutputBuffer struct {
    maxLines int
    mu       sync.Mutex
    lines    []string
    dropped  int
    headSize int // 头部保留行数
}

func NewRollingOutputBuffer(maxLines int) *RollingOutputBuffer {
    headSize := maxLines / 5 // 保留 20% 的头部
    if headSize < 50 {
        headSize = 50
    }
    return &RollingOutputBuffer{
        maxLines: maxLines,
        headSize: headSize,
        lines:    make([]string, 0, maxLines),
    }
}
8.2.3 读写接口实现
RollingOutputBuffer 的价值在于同时满足两个约束:工具输出必须实时可写(Bash 命令不断产出),又必须在写完后给大模型看时控制 Token 总量。下面的 Write 方法在行数超限时保留头部和尾部、丢弃中间冗余行,而 String 方法在拼接时插入截断标记,让模型明确知道“中间有信息被省略”,避免产生完整性幻觉。
为了能直接用作 cmd.Stdout 和 cmd.Stderr 的写入目标,我们必须实现 io.Writer:
go
func (b *RollingOutputBuffer) Write(p []byte) (n int, err error) {
    b.mu.Lock()
    defer b.mu.Unlock()

    newLines := strings.Split(string(p), "\n")
    b.lines = append(b.lines, newLines...)

    if len(b.lines) > b.maxLines {
        dropCount := len(b.lines) - b.maxLines
        b.dropped += dropCount

        tailSize := b.maxLines - b.headSize
        head := make([]string, b.headSize)
        copy(head, b.lines[:b.headSize])

        tail := make([]string, tailSize)
        copy(tail, b.lines[len(b.lines)-tailSize:])

        b.lines = append(head, tail...)
    }
    return len(p), nil
}

func (b *RollingOutputBuffer) String() string {
    b.mu.Lock()
    defer b.mu.Unlock()

    if b.dropped == 0 {
        return strings.Join(b.lines, "\n")
    }

    head := b.lines[:b.headSize]
    tail := b.lines[b.headSize:]

    var sb strings.Builder
    sb.WriteString(strings.Join(head, "\n"))
    sb.WriteString(fmt.Sprintf(
        "\n\n... [%d lines truncated for context efficiency] ...\n\n",
        b.dropped,
    ))
    sb.WriteString(strings.Join(tail, "\n"))
    return sb.String()
}

func (b *RollingOutputBuffer) Dropped() int {
    b.mu.Lock()
    defer b.mu.Unlock()
    return b.dropped
}
8.2.4 溢出落盘策略
当截断发生时,被丢弃的中间日志不应该彻底消失。我们把头尾摘要异步写入磁盘,并在返回给大模型的结果中标注路径:
go
func (b *RollingOutputBuffer) SpillToDisk(sessionID, toolCallID string) (string, error) {
    b.mu.Lock()
    defer b.mu.Unlock()

    if b.dropped == 0 {
        return "", nil
    }

    spillPath := filepath.Join(".agent", "spill", sessionID, toolCallID+".log")
    if err := os.MkdirAll(filepath.Dir(spillPath), 0755); err != nil {
        return "", err
    }

    f, err := os.Create(spillPath)
    if err != nil {
        return "", err
    }
    defer f.Close()

    for _, line := range b.lines {
        fmt.Fprintln(f, line)
    }

    return spillPath, nil
}
Spill-to-Disk 的实现边界澄清:上述 SpillToDisk 写入磁盘的是 b.lines,即截断后保留的头+尾行集合,而不是子进程 stdout 的完整原始流。中间被 Write() 丢弃的 dropCount 行在内存中已不可恢复,落盘文件同样无法还原它们。这与 “完整日志备份” 的直觉相悖,但是有意为之的工程取舍:classic ring buffer 覆盖旧数据后,被覆盖段同样永久丢失;我们的头尾策略至少保证落盘内容包含命令起始上下文和最终错误/状态,模型通过 read_file 按需拉取 spill 文件时,通常已足够定位问题。若业务场景要求零丢失审计(如金融合规日志),必须在 Write() 阶段同步 tee 到独立的全量日志文件,而不是依赖截断后的 Spill,那是另一条数据通路,不在 Rolling Buffer 的职责范围内。
在 BashTool.Execute 返回时,如果检测到截断,我们在输出末尾追加:
[...系统截断了 5231 行日志。头尾摘要已保存至 .agent/spill/<id>.log,如需查看请使用 read_file 工具...]这不仅保护了内存和上下文窗口,更赋予了大模型“感知错误规模”的能力,它知道被截断了多少行,可以决定是否需要通过 read_file 读取落盘的头尾摘要以获取更多细节。
8.3 第二级触发式压缩
即便第一道防线拦住了单次暴涨,随着对话轮次增加,Token 仍会不可逆地堆积:每轮 user 提问、assistant 推理、tool_call 参数都会永久留在 messages 里,且每一轮 API 调用都会把完整历史重发一遍。
Compactor 是本书实现的压缩管理器,它实现 domain.MemoryPort 接口,负责监控 Token 总量并在阈值触发时执行分级压缩。在其内部,我们用一个轻量级的 estimateTokens 函数实时估算当前上下文的 Token 总量(详见 §8.6 的 TokenEstimator 双模式分析)。现在将它与状态机结合,实现 Claude Code 式的双阈值渐进压缩,注意,这不是“到线就核摘要”的一步到位,而是分两级逐步升级:
Token 用量
    │
    │                              ┌─ 深度压缩(deepCompact)
    │                              │  整个历史 → LLM 摘要 → 2 条消息
    │                         hardLimit ─────────────
    │                              │
    │                    ┌─ 轻度压缩(Snip)
    │                    │  只截断历史中的冗长 tool 输出,对话骨架不动
    │               softLimit ─────────────
    │                    │
    │  安全区(不干预)
    └──────────────────────────────────────────→ 对话轮次
8.3.1 定点修剪的核心原理
在 Claude Code 源码里,Snip Compact 和 Microcompact 是两种不同粒度的“原地瘦身”,我们合并实现为 snipToolOutputs。理解它,要先回答三个问题:
问题一:为什么不直接删整条消息?
messages 数组不是普通日志,它是一条有结构约束的对话链:
system → user → assistant(tool_calls) → tool(result) → assistant(text) → user → ...如果删掉中间的 tool(result) 但保留 assistant(tool_calls),模型会看到“我调用了 read_file,但结果去哪了?”,产生严重幻觉。如果删掉整组 tool 交互,模型会忘记“我读过哪些文件”。
Snip 的策略是:消息结构完整保留,只缩减 tool 角色的 Content 体积。模型依然知道“第 3 轮我执行了 grep,返回了结果”,只是结果从 8000 字变成了 2500 字(头 1500 + 尾 1000)。
问题二:为什么只压 tool 消息,不压 assistant 和 user?如表 8-2 所示。
表 8-2 消息类型截断策略
| 消息类型 | Token 占比(长会话中的常见分布) | 信息密度 | 能否安全截断 |
|---|---|---|---|
tool | 通常最高 | 低(日志、文件内容) | 可以,头尾通常够用 |
assistant | 中等 | 高(推理链、决策) | 不行,截断会丢推理 |
user | 通常最低 | 高(原始需求) | 不行,截断会丢目标 |
轻度压缩的关键在于:在不动对话骨架的前提下,精准削减占体积最大、信息密度最低的 tool 输出。这是一刀切摘要(deepCompact)之前的“低成本尝试”,零 API 调用,纯字符串操作,毫秒级完成。
问题三:为什么需要 softLimit,不能等到 hardLimit 再一次性摘要?
因为 LLM 摘要是有成本的(额外 API 调用 + 信息损失):
- 太早摘要:10 轮对话就压成一段话,模型忘记 5 分钟前的关键细节
- 太晚摘要:Token 溢出,API 返回 413,Agent 直接崩溃
- 双阈值的价值:在 70% 水位时先用 Snip “挤一挤”,往往能把 Token 降回安全区,避免触发昂贵的 LLM 摘要。只有 Snip 挤不够了,才升级到 deepCompact
Claude Code 的四级管道其实就是逐级升级、尽量延迟核选项的设计哲学。我们简化为两级,但保留了同样的梯度思想。
Microcompact 与 Snip 的关键差异:Claude Code 源码中,二者是不同粒度的原地瘦身,本书将 Snip 的 tool 输出截断与 Microcompact 的骨架压缩合并实现为 snipToolOutputs,但概念上必须区分。Snip 针对 tool 角色的 Content 字段做字符串级头尾截断,消息实体完整保留,只是体积缩小;Microcompact 则压缩 tool_call 的请求体与返回体,保留函数名、参数摘要和结果骨架(如 “read_file(path=utils.go) → 847 lines, modified imports”),将完整 JSON/大段文本替换为结构化一行摘要。简言之:Snip 是“同一消息变薄”,Microcompact 是“同一交互变骨架”。生产级实现应分两级触发,先 Snip 挤体积,仍超标再 Microcompact 骨架化,最后才 AutoCompact 核摘要。
8.3.2 触发条件与阈值设定
在前文解构 Claude Code 时我们看到,其压缩触发公式是:
触发压缩 当且仅当 currentTokens > effectiveContextWindow - bufferTokens其中 bufferTokens 是留给下一轮模型输入输出的安全空间(通常为 13K)。我们先用最直观的逻辑理解核心链路,当 Token 总量超过硬阈值,直接触发深度摘要:
go
// 单阈值版本,仅用于说明"触发 → 摘要 → 替换"的核心链路
threshold := agentCtx.MaxContextTokens - agentCtx.BufferTokens
// estimateTokens 即 §8.6 TokenEstimator.EstimateMessages 的简写
if estimateTokens(messages) > threshold {
    summary := compactHistory(ctx, messages) // LLM 生成摘要
    agentCtx.ReplaceMessages([]Message{messages[0], {Role: "user", Content: summary}})
}
这段伪码抓住了压缩的要点,但在工程上过于粗暴,它在 70%~ 100% 区间内也会直接跳到 LLM 摘要,浪费大量 API 调用。完整实现采用 双阈值策略:softLimit (70%)处先做零成本的工具输出截断,只有突破 hardLimit 才启动昂贵的 LLM 摘要。这就是 CompressIfNeeded 的完整逻辑:
8.3.3 切断与多级摘要
压缩不是简单的 Messages = Messages[:3]。我们需要解决两个棘手问题:
问题一:切断点不能落在 ToolCall/ToolResult 配对之间
如果切断后,历史中留下了一个 assistant 消息包含 tool_calls 字段,但后面紧跟的 tool 消息被切掉了,大模型会产生严重幻觉(“我明明调用了工具,结果呢?”)。因此我们必须找到安全的切断点:
go
func findSafeCutPoint(messages []Message) int {
    // 从后往前扫描,找到第一个"干净"的边界
    for i := len(messages) - 1; i > 0; i-- {
        msg := messages[i]
        // 安全边界:user 消息之后、或者完整处理了 tool 结果之后
        if msg.Role == "user" {
            return i
        }
        // assistant 消息没有 tool_calls 也是安全的
        if msg.Role == "assistant" && len(msg.ToolCalls) == 0 {
            return i + 1
        }
    }
    return 1 // 至少保留 system prompt
}
问题二:深度压缩该保留什么、丢弃什么?
当 Snip 已无法把 Token 压回安全区,就必须启动第三道防线 deepCompact,用廉价模型把整段历史浓缩成结构化摘要。这与 Snip 有关键区别,如表 8-3 所示。
表 8-3 定点修剪与深度压缩对照
| 维度 | 定点修剪 | 深度压缩 |
|---|---|---|
| 触发时机 | 超过 softLimit (70%) | 超过 hardLimit (窗口 - 13K buffer) |
| 操作对象 | 仅 tool 消息的 Content | 除 system 外的全部历史 |
| 实现方式 | 字符串头尾截断 | 调用 LLM 生成摘要 |
| API 成本 | 零 | 一次额外 LLM 调用 |
| 信息损失 | 低(中间日志本就可丢) | 高(细节被概括) |
| 消息数量 | 不变 | 从 N 条 → 2 条 |
深度压缩不是简单的 Messages = Messages[:3]。摘要 Prompt 必须明确要求保留五类关键信息(原始目标、关键决策、文件路径、当前进度、错误与修复),否则模型会在下一轮“重新探索”已经做过的事。
go
func (c *Compactor) compactHistory(ctx context.Context, messages []Message) (string, error) {
    // 构造压缩专用的 prompt
    compactPrompt := `You are a context compaction engine. Summarize the following conversation
into a structured summary that preserves:

1. The original user request and goal

2. Key decisions made and their rationale

3. Files that were read or modified (with paths)

4. Current progress status and next steps

5. Any errors encountered and how they were resolved

Format as a structured document. Be concise but preserve all actionable details.`

    // 序列化对话历史
    var historyBuf strings.Builder
    for _, msg := range messages[1:] { // 跳过 system prompt
        fmt.Fprintf(&historyBuf, "[%s]: %s\n---\n", msg.Role, truncateForCompaction(msg.Content))
    }

    resp, err := c.llm.Chat(ctx, domain.ChatRequest{
        Model: "gpt-5-mini", // 用轻量模型做压缩
        Messages: []Message{
            {Role: "system", Content: compactPrompt},
            {Role: "user", Content: historyBuf.String()},
        },
    })
    if err != nil {
        return "", err
    }

    return resp.AssistantMessage.Content, nil
}

func truncateForCompaction(content string) string {
    const maxPerMessage = 2000
    if len(content) <= maxPerMessage {
        return content
    }
    return content[:1000] + "\n...[truncated]...\n" + content[len(content)-800:]
}
8.3.4 压缩的完整决策链
把前面两节串起来,CompressIfNeeded 就是整个第二级水库的调度中枢。每次 RunLoop 调用 LLM 之前,按以下顺序决策:
estimateTokens(messages)
        │
        ├─ current ≤ softLimit(70%)     → 什么都不做,直接调 LLM
        │
        ├─ softLimit < current ≤ hardLimit → snipToolOutputs()
        │                                     遍历所有 tool 消息
        │                                     Content > 3000 字 → 头1500+尾1000
        │                                     重新估算 Token
        │                                     往往可显著降低 Token 占用,避免触发摘要
        │
        └─ current > hardLimit          → compactHistory()
安全切点 → LLM 摘要 → 替换为 2 条消息bufferTokens(通常 13K)的意义:不是等到窗口 100% 满才压缩,而是提前留出下一轮模型输入输出的空间。如果等到 128K 才动手,下一轮 assistant 回复 + 新的 tool 结果会直接溢出。
双阈值调度入口
将上述决策流图转化为代码,就是 CompressIfNeeded 方法——RunLoop 每轮调用 LLM 前的必经检查点。
go
func (c *Compactor) CompressIfNeeded(ctx context.Context, agentCtx *AgentContext) error {
    // estimateTokens 委托给 TokenEstimator.EstimateMessages(实现见 §8.6)
    current := c.estimator.EstimateMessages(agentCtx.GetMessages())
    softLimit := int(float64(agentCtx.MaxContextTokens) * 0.7)
    hardLimit := agentCtx.MaxContextTokens - agentCtx.BufferTokens

    if current <= softLimit {
        return nil
    }

    if current <= hardLimit {
        c.snipToolOutputs(agentCtx) // 轻度压缩:截断冗长的工具输出
        return nil
    }

    // 深度压缩
    return c.deepCompact(ctx, agentCtx)
}
深度压缩与轻度截断实现
当 Token 突破 hardLimit 时,deepCompact 负责安全切点定位与 LLM 摘要替换;而 snipToolOutputs 则是零 API 成本的字符串级截断。两者共同构成第二级压缩的执行层。
go
func (c *Compactor) deepCompact(ctx context.Context, agentCtx *AgentContext) error {
    messages := agentCtx.GetMessages()
    cutPoint := findSafeCutPoint(messages)
    summary, err := c.compactHistory(ctx, messages[1:cutPoint])
    if err != nil {
        return fmt.Errorf("deep compact failed: %w", err)
    }
    agentCtx.ReplaceMessages(append(
        []Message{messages[0]},
        Message{Role: "user", Content: "[Summary of prior conversation]\n" + summary},
    ))
    agentCtx.ReplaceMessages(append(agentCtx.GetMessages(), messages[cutPoint:]...))
    return nil
}

func (c *Compactor) snipToolOutputs(agentCtx *AgentContext) {
    agentCtx.mu.Lock()
    defer agentCtx.mu.Unlock()

    for i := range agentCtx.Messages {
        if agentCtx.Messages[i].Role == "tool" && len(agentCtx.Messages[i].Content) > 3000 {
            content := agentCtx.Messages[i].Content
            agentCtx.Messages[i].Content = content[:1500] +
                "\n...[snipped for context efficiency]...\n" +
                content[len(content)-1000:]
        }
    }
}
8.4 第三级持久化与检索
上下文压缩虽然能缓解 Token 压力,但大模型也因此“失忆”了。10 分钟前读取的某段核心业务代码,可能被压缩成了“我之前查阅了 utils.go”。
Compactor 的双阈值压缩是同步的——它在每轮循环内完成裁剪。但被裁掉的信息并非一定要丢失:我们可以在主循环之外,用一个异步书记员把关键事实持久化到磁盘,等需要时再检索回来。这正是 Pi 架构中后台书记员与预加载检索的思路。
8.4.1 后台状态记录器
不要在主对话流里让大模型记笔记。在 Go 中,我们利用 Goroutine 开销较低的特性,在主 RunLoop 之外挂载一个后台协程。
核心机制:主循环每隔一定轮次或当 Token 超过阈值时,将当前的完整 Messages 快照丢入一个 Channel:
go
type MemoryManager struct {
    snapChan     chan []Message
    llm          domain.LLMPort
    storagePath  string
    minInterval  int // 最少间隔多少轮才触发一次摘要
    lastTurn     int
}

func NewMemoryManager(llm domain.LLMPort, storagePath string) *MemoryManager {
    return &MemoryManager{
        snapChan:    make(chan []Message, 2), // 缓冲 2 个快照,防止主循环阻塞
        llm:         llm,
        storagePath: storagePath,
        minInterval: 5,
    }
}

func (m *MemoryManager) MaybeTrigger(agentCtx *AgentContext) {
    if agentCtx.TurnCount-m.lastTurn < m.minInterval {
        return
    }

    snapshot := agentCtx.GetMessages() // 不可变快照
    select {
    case m.snapChan <- snapshot:
        m.lastTurn = agentCtx.TurnCount
    default:
        // Channel 满了,跳过本轮(非阻塞)
    }
}
后台协程持续消费 Channel 中的快照,使用廉价模型生成结构化摘要:
go
func (m *MemoryManager) RunScribe(ctx context.Context) {
    for {
        select {
        case <-ctx.Done():
            return
        case snapshot := <-m.snapChan:
            m.generateAndStoreMemory(ctx, snapshot)
        }
    }
}

func (m *MemoryManager) generateAndStoreMemory(ctx context.Context, messages []Message) {
    const scribePrompt = `Extract structured memory entries from this conversation.
For each key action, record:
- [FILE] path: brief description of what was found or changed
- [DECISION] what was decided and why
- [ERROR] what went wrong and how it was resolved
- [PROGRESS] current status toward the goal

Output as a bullet list. Be extremely concise.`

    var historyText strings.Builder
    for _, msg := range messages {
        if msg.Role == "system" {
            continue
        }
        content := msg.Content
        if len(content) > 500 {
            content = content[:500] + "..."
        }
        fmt.Fprintf(&historyText, "[%s] %s\n", msg.Role, content)
    }

    resp, err := m.llm.Chat(ctx, domain.ChatRequest{
        Model: "gpt-5-mini",
        Messages: []Message{
            {Role: "system", Content: scribePrompt},
            {Role: "user", Content: historyText.String()},
        },
    })
    if err != nil {
        log.Printf("WARN: memory scribe failed: %v", err)
        return
    }

    entry := fmt.Sprintf("\n---\n[Turn %d | %s]\n%s\n",
        len(messages),
        time.Now().Format("15:04:05"),
        resp.AssistantMessage.Content,
    )

    memPath := filepath.Join(m.storagePath, "MEMORY.md")
    os.MkdirAll(filepath.Dir(memPath), 0755)

    f, err := os.OpenFile(memPath, os.O_APPEND|os.O_CREATE|os.O_WRONLY, 0644)
    if err != nil {
        return
    }
    defer f.Close()
    f.WriteString(entry)
}
8.4.2 关键词检索方案
很多开源项目喜欢引入重量级的向量数据库(如 Milvus、Qdrant)做 RAG(Retrieval-Augmented Generation,检索增强生成) 检索。但对于本地 Agent 场景,这太重了。我们的方案是基于文件元数据的关键词检索:Agent 不必把所有知识塞进上下文,遇到问题时从外部资料库按需召回相关内容,从而处理远超窗口容量的大型代码库。
标准 RAG 链路与本书方案选型:工业界 RAG 的标准链路为 chunk → embed → 向量索引 → Top-K 召回 → rerank → inject,在百万级文档、语义模糊查询场景下效果最佳,但依赖 embedding 模型、向量数据库和 reranker 三套基础设施。本书选用关键词 + 文件元数据方案,并非否定 RAG,而是基于本地 Agent 的工程约束:MEMORY.md 体量通常在 KB ~低 MB 级,全量扫描毫秒级完成,向量检索的 latency 优势在此尺度下难以兑现;单二进制 + 文件系统是 Pi/Claude Code 的部署哲学,引入 Qdrant/Milvus 与 embedding API 违背这一约束;Session Memory 条目已是 LLM 生成的结构化摘要([FILE]、[DECISION] 等标签),对路径名、函数名、错误码的精确查询,关键词匹配往往比语义向量更可靠,当然,这一判断在跨语言同义检索上可能吃亏。当项目记忆突破 ~10MB 或需要跨仓库语义搜索时,再升级为标准 RAG 链路是自然的演进路径。
检索方案对比:倒排索引(关键词精确匹配)胜在零模型依赖和极低内存开销,但无法理解同义词;向量检索(HNSW/IVF)胜在语义泛化和跨语言召回,代价是 embedding 模型 + 向量索引 + 运维复杂度。本地 Agent 的 MEMORY.md 体量处于前者占优的区间。
go
func (m *MemoryManager) SearchMemory(ctx context.Context, query string) string {
    memPath := filepath.Join(m.storagePath, "MEMORY.md")
    data, err := os.ReadFile(memPath)
    if err != nil {
        return "" // 无记忆可用
    }

    entries := strings.Split(string(data), "\n---\n")
    queryTerms := extractKeyTerms(query)

    type scoredEntry struct {
        text  string
        score int
    }

    var scored []scoredEntry
    for _, entry := range entries {
        if entry == "" {
            continue
        }
        score := 0
        lower := strings.ToLower(entry)
        for _, term := range queryTerms {
            if strings.Contains(lower, strings.ToLower(term)) {
                score++
            }
        }
        if score > 0 {
            scored = append(scored, scoredEntry{entry, score})
        }
    }

    // 按相关度降序排列,取 Top-5
    sort.Slice(scored, func(i, j int) bool {
        return scored[i].score > scored[j].score
    })

    var result strings.Builder
    limit := min(5, len(scored))
    for i := 0; i < limit; i++ {
        result.WriteString(scored[i].text)
        result.WriteString("\n")
    }

    return result.String()
}

func extractKeyTerms(query string) []string {
    words := strings.Fields(query)
    // 过滤掉常见停用词
    stopWords := map[string]bool{
        "the": true, "a": true, "an": true, "is": true, "are": true,
        "请": true, "帮": true, "我": true, "那个": true, "这个": true,
        "的": true, "了": true, "吗": true, "把": true, "在": true,
    }
    var terms []string
    for _, w := range words {
        if !stopWords[strings.ToLower(w)] && len(w) > 1 {
            terms = append(terms, w)
        }
    }
    return terms
}
extractKeyTerms 与 Contains 计数的局限与权衡:当前实现对每条记忆 entry 做 strings.Contains 命中计数。这种做法的缺陷是:同一 term 出现多次仍只计 1 次,无法区分 “顺带提到 utils.go” 与 “整段核心都在讨论 utils.go”;同时缺乏 IDF 惩罚,常见停用词的召回噪声较高。
既然存在这些缺陷,为什么我们没有直接引入 BM25 (TF-IDF 的进阶版,稀疏检索的基线)或者向量数据库?
这同样是一个基于产品部署形态的工程权衡。Contains 计数是一种极致轻量级的 MVP 实现:零预处理、零外部依赖、零内存索引开销。 对于体积在几 MB 以内的工作区记忆,Go 的 strings.Contains 暴力遍历延迟极低(微秒级),是本地 CLI Agent 的最优解。引入外部向量库或者自己手搓倒排索引,只会徒增用户的安装成本和进程负担。
当然,如果你正在构建的是一个企业后台常驻服务(Daemon),需要检索高达 GB 级别的历史工单或代码库底座,这套纯内存暴搜方案就会成为瓶颈。在那种重型生产场景下,建议直接外挂 Elasticsearch (使用 BM25)或 Milvus (使用 Embedding)等专门的基础设施。
8.4.3 记忆检索与模型推理的双轨并发
在前文解构 Claude Code 时,我们曾提到它使用了极其硬核的“双轨制拉链(Zipper)并发”:主线程直接去请求昂贵的大模型推理,暗线线程去请求便宜的小模型做记忆检索。检索完成后,在流式输出的中途强行把记忆“拉链式”注入进去。
然而,在 go-coder 的工程实现中,如何将这种前沿的并发架构落地,是一个巨大的挑战。如果强行在 Streaming 中途注入上下文,会破坏 OpenAI messages 数组“必须在请求前静态组装完成”的接口约束,导致实现复杂度飙升。
工程往往是妥协的艺术。为了在“不拖慢主循环”和“代码可维护性”之间取得平衡,我们实现了一种工程化的“有界双轨并发”:主线 Goroutine 与暗线记忆检索 Goroutine 依然是两条并行的轨道,但我们在主线发起真正的 LLM 网络请求之前,设置了一个极短的同步拦截点。
用户输入新问题时,系统在启动 RunLoop 之前先唤醒暗线 Goroutine 异步检索 Session Memory;主线并不立刻请求 LLM,而是进入最多 2 秒的阻塞等待(select 超时控制)。若 2 秒内暗线检索完成,两轨汇合、注入记忆上下文;若超时,主线果断抛弃暗线、直接进入 RunLoop,宁可少带一点记忆,也不延长用户的等待时间。2 秒上限是经验值,并非严格最优,具体阈值需结合检索延迟与产品容忍度调整。
真实时序代码如下:
go
func (a *Agent) HandleUserQuery(ctx context.Context, agentCtx *AgentContext, userInput string) error {
    agentCtx.AppendMessage(domain.Message{Role: "user", Content: userInput})

    var (
        memoryAttachment string
        memoryOnce       sync.Once
    )

    // 链路 1(暗线):后台异步检索记忆
    memDone := make(chan struct{})
    go func() {
        defer close(memDone)
        result := a.memory.SearchMemory(ctx, userInput)
        if result != "" {
            memoryOnce.Do(func() {
                memoryAttachment = result
            })
        }
    }()

    // 链路 2(主线):有界等待记忆检索完成(设 2 秒超时上限)
    select {
    case <-memDone:
    case <-time.After(2 * time.Second):
        // 记忆检索超过 2 秒就放弃,保障用户体验
    }

    if memoryAttachment != "" {
        agentCtx.AppendMessage(domain.Message{
            Role: "system",
            Content: "[Retrieved Memory]\n" + memoryAttachment +
                "\n[Use this context if relevant to the current task.]",
        })
    }

    // 启动主循环
    return a.RunLoop(ctx, agentCtx)
}
这种 “检索前置 + 有界等待” 的设计,让你在无需引入复杂向量数据库的前提下,用文件系统和 Goroutine 实现 Agent 的长效记忆,记忆在 LLM 首轮请求前就绪,2 秒超时兜底防止检索阻塞主线。
8.4.4 扩展阅读:向量检索与检索增强生成
8.4.2 已说明本地 Agent 为何选用关键词检索。若记忆规模突破 ~10MB、或需要跨文档语义召回,标准 RAG 链路是自然演进方向,Milvus/Qdrant、pgvector、sqlite-vec 等选型与 Embedding 模型的细节,可参考各项目官方文档,本书不再展开。
8.5 跨会话长期记忆架构演进
Session Memory 解决的是单次会话内的记忆延续。但跨会话呢?用户昨天让 Agent 重构了认证模块,今天又问“上次改认证的时候动了哪些文件”,Session Memory 无能为力。
我们需要第二层:长期记忆(Long-Term Memory),将关键决策、文件变更记录甚至用户的偏好习惯持久化,并在未来的会话中精准召回。
8.5.1 极简方案:基于工作区的实体记忆
在 Loop Engineering 的最佳实践中,这被称为“基于工作区的实体记忆”。与其一上来就引入复杂的向量数据库,不如采用最极简、最可靠的方案:把状态写在文件里(如 TODO.md 或 PROJECT_MEMORY.md),文件放在仓库里,让 Git 来管理状态。 模型在每次对话之间会完全遗忘,但仓库记得。
go
func (m *MemoryManager) PersistProjectMemory(sessionID string, summary string) error {
    projectMemPath := filepath.Join(m.storagePath, "PROJECT_MEMORY.md")

    entry := fmt.Sprintf("\n## Session %s (%s)\n%s\n",
        sessionID[:8],
        time.Now().Format("2006-01-02 15:04"),
        summary,
    )

    f, err := os.OpenFile(projectMemPath, os.O_APPEND|os.O_CREATE|os.O_WRONLY, 0644)
    if err != nil {
        return err
    }
    defer f.Close()

    _, err = f.WriteString(entry)
    return err
}
在每次 Session 结束时(即 RunLoop 返回 Completed 状态时),自动触发项目记忆的持久化。下次新会话启动时,系统提示词 中可以注入最近几条项目记忆作为上下文。
Project Memory 的注入、检索与冲突解决:PersistProjectMemory 在 Session 结束时写入 PROJECT_MEMORY.md,每条 entry 含 session ID 前缀、时间戳和 LLM 生成的 session 摘要。新会话启动时的注入策略:读取 PROJECT_MEMORY.md,按时间倒序取最近 3 ~ 5 条 entry (Token 预算通常 500 ~ 1500),拼入 系统提示词 的 [Project History] 段落,不放 user 消息,避免与首轮 user 输入争首尾注意力位。检索机制:Project Memory 不走 SearchMemory 关键词路径,而是全量预加载 + 截断,文件体量可控(通常 <50KB),启动时一次性读入即可;Session Memory 才按需 SearchMemory(query) 做动态召回。与 Session Memory 的冲突解决:二者职责分层,Project Memory 回答“跨会话发生了什么”(架构决策、改过的模块),Session Memory 回答“本次会话内做过什么”(当前分支的具体文件操作)。若同一事实两处皆有(如都记录了 “修改了 auth.go”),系统提示词 中 Project 段在前、Session 检索结果在后注入,模型倾向于采信更具体、更新的 Session 条目;压缩后 Session 检索成为唯一动态记忆源,Project Memory 作为冷启动锚点。产品侧可配置 projectMemoryMaxEntries 与 sessionMemoryTopK 避免因重复注入而超出预算。
8.5.2 进阶方案:向量数据库与检索增强生成
当 Agent 作为云端 SaaS 服务长期伴随用户时,纯文本的 PROJECT_MEMORY.md 会迅速膨胀至无法全量预加载的程度。此时,长期记忆的架构必须向 RAG 演进。
在 RAG 模式下,每次 Session 结束时产生的不仅仅是一段摘要文本,而是被切分为多个 Chunk,经过 Embedding 模型(如 text-embedding-3-small)向量化后存入向量数据库(如 Milvus、Qdrant 或 pgvector)。
当新会话启动时,系统不再全量加载历史,而是将用户的新 Prompt 同样向量化,在向量库中进行 KNN 相似度检索,召回最相关的 Top-K 条历史记忆注入上下文。这种模式极大地提高了 Agent 的记忆容量上限,使其能够从数万条历史对话中精准捞取“三个月前关于数据库连接池的讨论”。
8.5.3 终极方案:图数据库与 Mem0 架构
向量检索解决了“语义相似性”问题,但无法解决“实体关系演进”问题。例如,用户在 1 月份说“我喜欢用 4 个空格缩进”,在 3 月份又说“以后所有 Go 项目改用 Tab 缩进”。向量检索可能会同时召回这两条记忆,导致模型指令冲突。
为了解决这一痛点,业界前沿的记忆架构(如开源项目 Mem0)引入了知识图谱。
在图记忆架构中,记忆不再是孤立的文本块,而是被 LLM 提取为 (Subject) - [Predicate] -> (Object) 的三元组。例如:
(User) - [Prefers] -> (Tab Indentation)(Project_A) - [Uses] -> (PostgreSQL)
当用户表达新偏好时,系统会触发一个后台的 Memory Updater Agent。该 Agent 会在图数据库(如 Neo4j 或 Memgraph)中查询现有的实体关系,如果发现冲突,则执行图合并与边更新,将旧的 [Prefers] 边废弃或更新权重。
在每次对话前,系统通过图遍历提取与当前任务相关的子图,将其序列化为 系统提示词 中的 <user_profile> 和 <project_context> 标签。这种基于图的记忆机制,赋予了 Agent 真正的“心智成长”能力,它不仅能记住事实,还能随着时间推移,动态修正对用户画像和项目全貌的认知。
8.6 预算追踪器设计
§8.5 描绘的向量库与知识图谱是记忆架构的演进远景,但无论上层架构如何进化,所有压缩与检索决策最终都要回答同一个最基础的问题:当前上下文究竟占用了多少 Token?回到本章的工程实现,这个看似简单的计数动作,正是贯穿三级缓冲体系的地基。
三级缓冲体系(§8.2–§8.4)解决了"如何压缩"的问题,但"何时触发压缩"需要一个实时的 Token 计数器来裁定——这就是预算追踪器的职责。前文 CompressIfNeeded 中反复出现的 estimateTokens 调用,正是这套计量基础设施在压缩决策链中的体现。
下面补上贯穿整个压缩管道的计量基础设施——Token 估算器。在生产环境中,我们需要同时支持精确计算和快速估算两种模式:
go
type TokenEstimator struct {
    model string
}

func (e *TokenEstimator) EstimateMessages(messages []Message) int {
    total := 0
    for _, msg := range messages {
        total += e.EstimateText(msg.Content)
        total += 4 // 每条消息的结构化开销(role, separators)

        // tool_calls 也会消耗 Token
        for _, tc := range msg.ToolCalls {
            total += e.EstimateText(tc.Name)
            total += e.EstimateText(string(tc.Arguments))
            total += 10 // tool_call 的结构化开销
        }
    }
    return total
}

func (e *TokenEstimator) EstimateText(text string) int {
    // 快速估算:英文约 4 字符 = 1 token,中文约 2 字符 = 1 token
    // 生产环境应使用 tiktoken-go 等精确分词器
    asciiCount := 0
    unicodeCount := 0
    for _, r := range text {
        if r < 128 {
            asciiCount++
        } else {
            unicodeCount++
        }
    }
    return asciiCount/4 + unicodeCount/2 + 1
}
TokenEstimator 双模式与误差分析:上文 EstimateText 是快速估算模式,按 rune 范围粗分 ASCII / Unicode,套用 ascii/4 + unicode/2 + 1 heuristics,单次遍历 $O(n)$,适合 RunLoop 每轮压缩决策的热路径。精确模式应切换为 tiktoken-go 等官方分词器,按模型 vocab 逐 token 编码,仅在 CompressIfNeeded 触发压缩前、或 billing 对账时调用,避免每轮全量精确分词拖慢主循环。切换策略:TokenEstimator 持有 precise bool 字段,默认 false;当 currentTokens > softLimit * 0.9 时自动切换为精确模式做二次确认,防止 heuristic 低估导致 API 413。误差上界:英文代码 ascii/4 对 GPT/claude 的 BPE 通常低估 10%~ 25%(短标识符、符号密集 JSON 的 token 密度高于 4 chars/token);中文 unicode/2 对 CJK 通常高估 5%~ 15%(常用汉字在 cl100k_base 中多为 1 ~ 2 token/字,但词组会被合并)。混合文本的综合误差可达 ±20%,因此 bufferTokens(13K)不仅是留给下一轮输出的空间,也是 estimator 误差的安全垫,绝不应把 heuristic 估算值当作硬上限贴线运行。
8.7 记忆架构全景图
将三级防波堤和双层记忆组合在一起,形成完整的记忆管道,如图 8-1 所示:
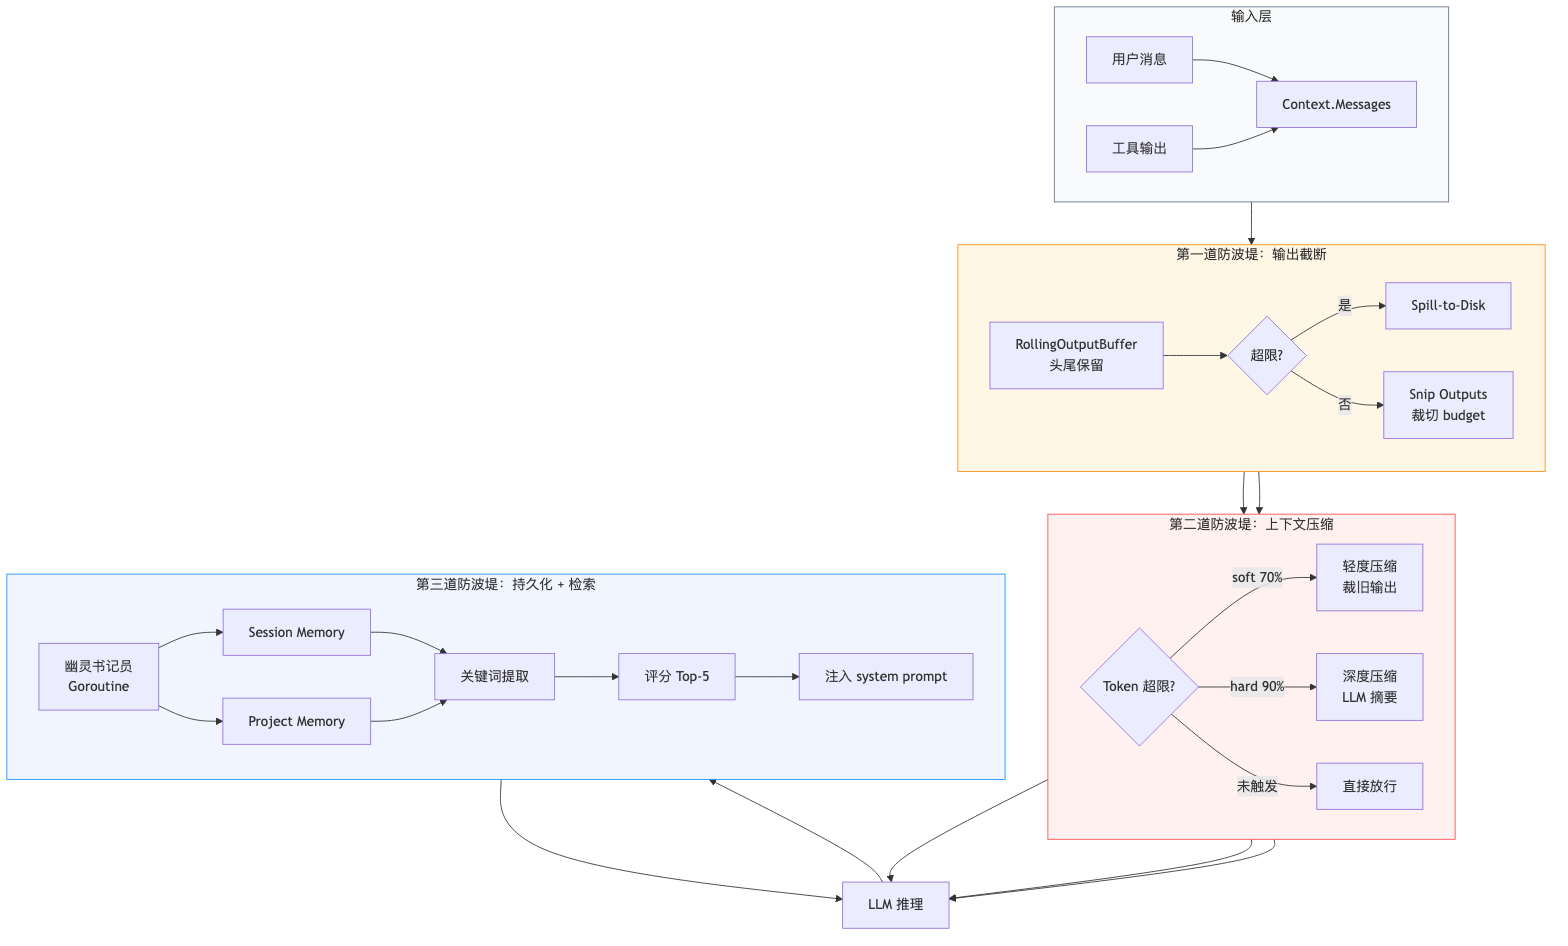
用户输入 → 记忆检索(暗线并发)
                ↓
           [注入相关记忆]
                ↓
         RunLoop 循环开始
                ↓
    ┌─→ Token 预算检查 ─→ 超软阈值? → snipToolOutputs(轻度压缩)
    │                    ─→ 超硬阈值? → compactHistory(深度压缩)
    │         ↓
    │   调用 LLM 生成回复
    │         ↓
    │   工具执行(RollingBuffer 截断保护)
    │         ↓
    │   结果回流 → 追加到 Messages
    │         ↓
    │   每 N 轮 → 触发后台书记员(异步摘要)
    │         ↓
    └── TurnCount++ → 下一轮循环
                ↓
         Session 结束 → 持久化到 PROJECT_MEMORY.md
总之,记忆管理的关键不是“记住一切”,而是在有限窗口内保住决策所需的最小上下文,三级防波堤各自守一条溢出路径,缺任何一级,长会话都会在 Token 成本或 recall 质量上失控。
在此基础上,当 Agent 出现执行错误需要纠正时,下一章将介绍如何用 Go 实现人机协同与终端挂起仲裁。