主题
第 12 章:运行时观测与评估
:::
阅读建议:如果时间有限,聚焦“追踪 → 验证 → 评估 → 优化”四层闭环的设计逻辑,即可把握可观测性全貌;slog 配置、OpenTelemetry Span 代码、Grader 接口适合搭建监控时回读。
:::
当我们用 Go 语言将 Agent 封装成二进制可执行文件(CLI)并分发给团队使用时,一旦发生故障,排查成本会急剧上升。
- “我的 Agent 在执行时一直卡住,也不报错。”
- “它昨晚突然疯狂调用 API,烧了我 50 美金,到底发生了什么?”
- “我刚重构了底层模型接口,怎么保证它还能正确写出 React 组件?”
这些问题通常很难仅靠 TUI 界面或零散的 log.Println 记录定位。面向生产环境的智能体因此需要系统化的可观测性。接下来探讨如何在 Go 中构建这些能力,以及如何为 Agent 搭建自动化评估管线。
12.1 可观测性三支柱
前面三条用户原话,卡住、烧钱、重构后质量未知,分别指向“单次会话卡在哪一步”“全局消耗是否失控”“变更后行为是否退化”三类诊断需求。可观测性三支柱就是为回答这些问题而设计的:Logs 记录离散事件,Metrics 聚合时间序列,Traces 串起因果链,三者从不同维度还原“系统在某一时刻究竟发生了什么”。
12.1.1 结构化诊断实现
Logs 记录离散事件及其上下文(错误堆栈、工具调用参数、模型返回摘要),适合事后精确定位单次会话的异常点。12.2 节用 log/slog 实现:每条日志携带 SessionID、TurnCount,并与 Trace ID 关联。
12.1.2 成本与可用性监控
Metrics 是对系统行为的时间序列聚合,QPS、错误率、Token 生成速率、P99 延迟等,适合回答“整体是否在恶化”以及触发告警。在 Agent 场景中,Token 速率骤降往往对应上下文膨胀;错误率分项(429 vs 工具超时 vs Grader 失败)直接指明优化优先级。生产环境建议用 Prometheus 补齐:agent_runs_total、llm_latency_seconds、agent_cost_usd_total 等。12.4 节的 Context 消费探针是 Metrics 层的轻量实现。
12.1.3 全链路时空图设计
Traces 把一次请求的完整调用链串成因果树,揭示跨组件的耗时分布与依赖关系。12.3 节用 OpenTelemetry 实现:LLM 调用、Tool 执行、HITL 挂起各成 Span,Jaeger 瀑布图回答“卡在哪一步”。
本章的实现重心落在 Logs + Traces + Cost (成本探针) 三条线上,它们与 Agent 的“回合制”执行模型天然契合。排查故障时,先用 Metrics 判断是全局性故障还是个别 Session 异常,再用 Trace 钻取到具体 Span,最后用 Logs 阅读该 Session 的完整叙事。
12.2 结构化日志管理
在复杂的 Agent 循环中,并发极多,普通的文本日志非常难以过滤。从 Go 1.21 开始,标准库内置了 log/slog,是记录 Agent 状态的合适工具。
核心准则:所有的日志必须带上 SessionID 和 TurnCount。
go
import (
    "log/slog"
    "os"
)

// 初始化一个输出为 JSON 格式的 Logger,方便导入 ELK 或 Datadog
logger := slog.New(slog.NewJSONHandler(os.Stdout, &slog.HandlerOptions{
    Level: slog.LevelDebug,
}))
slog.SetDefault(logger)

func (a *Agent) RunLoop(ctx context.Context, agentCtx *AgentContext) error {
    // 每次进入 Loop,绑定当前会话的上下文
    l := slog.With(
        slog.String("session_id", agentCtx.SessionID),
        slog.Int("turn_count", agentCtx.TurnCount),
        slog.String("role", a.Role),
    )

    l.Info("Starting new thought cycle")

    // ...
    if err != nil {
        l.Error("API call failed", slog.String("error", err.Error()), slog.Int("retries", retryCount))
    }
}
当我们使用 slog 后,排查问题就变成了简单的条件查询:检索特定 session_id 下,错误级别为 Error 的所有日志,我们就能清晰看到 Agent 到底卡在了哪一步。
12.2.1 上下文传递与关联规则
结构化日志的核心价值在于关联,能够从一条日志出发,还原出整个 Session 的完整故事线。关联规则分为两层:垂直关联(同一 Session 内跨 Turn 的日志通过 session_id 串联)和水平关联(同一 Turn 内跨组件的日志通过 turn_count + trace_id 串联)。垂直关联回答“这个 Session 经历了哪些 Turn,每个 Turn 的状态转移是什么”;水平关联回答“这一轮里 LLM 调用、Tool 执行、HITL 审批各自的耗时和结果”。
实现上,slog.With 在 RunLoop 入口绑定 session_id 和初始 turn_count,每次 Turn 递增时通过 l = l.With(slog.Int(“turn_count”, agentCtx.TurnCount)) 派生新 Logger。工具执行层再追加 tool_name、tool_call_id,形成三级关联键:session_id → turn_count → tool_call_id。排查时按 session_id 过滤可得全貌,按 turn_count 缩窄到具体回合,按 tool_call_id 定位到单次工具调用的输入输出。这种层层钻取的方式与 OpenTelemetry 中从 Trace 到 Span,再到 Attributes 的观察方式相似,但两者并非同一种数据结构。
12.2.2 敏感信息脱敏与日志级别切换
Agent 的日志天然包含高敏感数据:用户输入的 prompt 可能含有业务机密,LLM 响应可能复述 API Key,工具执行的 Bash 命令可能暴露数据库密码或内网地址。如果这些信息原样写入 ELK 或 Datadog,等于把密钥发送到了日志聚合平台,一旦泄露,影响面远超单次对话。
脱敏策略分为两层:结构化字段脱敏与自由文本扫描。结构化字段脱敏在 slog.Handler 的 Handle 方法中拦截:对已知的 key (如 api_key、authorization、password)直接替换为 “*REDACTED*”。自由文本扫描则用正则表达式对 Content 类字段做模式匹配,常见的 pattern 包括 sk-[a-zA-Z0-9]{20,}(OpenAI Key)、ghp_[a-zA-Z0-9]{36}(GitHub Token)、Bearer\s+[^\s]+。匹配到的子串替换为同长度的 * 序列,保留上下文可读性。
go
type SanitizingHandler struct {
    inner   slog.Handler
    patterns []*regexp.Regexp
}

func (h *SanitizingHandler) Handle(ctx context.Context, r slog.Record) error {
    sanitized := slog.NewRecord(r.Time, r.Level, r.Message, r.PC)
    r.Attrs(func(a slog.Attr) bool {
        if isSecretKey(a.Key) {
            a = slog.String(a.Key, "*REDACTED*")
        } else if a.Value.Kind() == slog.KindString {
            a = slog.String(a.Key, h.sanitize(a.Value.String()))
        }
        sanitized.AddAttrs(a)
        return true
    })
    return h.inner.Handle(ctx, sanitized)
}
日志级别的动态切换同样重要。开发阶段需要 Debug 级别输出每轮 prompt 全文,便于调试;生产环境则应设为 Warn 以上,避免日志量爆炸(一个 128K 上下文的 Agent 单轮日志可达 500KB)。推荐通过环境变量 LOG_LEVEL 在启动时配置,或通过 HTTP /admin/log-level 端点在运行时热切换,后者在排查线上故障时尤为关键:临时调到 Debug,复现问题后立即恢复 Warn,无需重启服务。
12.2.1 节介绍的 slog.With 派生机制(入口绑定、逐层追加)在并发场景下的最佳实践是:将派生后的 Logger 存入 context.Context(自定义 loggerKey),而不是作为参数逐层传递。RunLoop 注入 → Tool.Execute(ctx, ...) 读取 → LLM.Chat(ctx, ...) 读取,三层共享同一 Logger 实例,Goroutine 间不会因全局变量产生竞态。这与 OpenTelemetry 的 Context 传播模式同构,都在请求入口一次性注入,在边界处读取。
日志与 Trace 的 correlation 是生产可观测性的关键一环。在 OTel Span 创建时,SDK 会自动生成 trace_id 和 span_id;我们只需在 RunLoop 入口的 slog.With 中追加这两个字段(通过 trace.SpanFromContext(ctx).SpanContext() 读取),此后该 Session 的每一条 JSON 日志都会携带 trace_id。在 Jaeger 或 Datadog 中点击某个慢 Span,可以直接跳转到 ELK/Loki 中过滤 trace_id=<same> 的全部日志,从 Trace 瀑布图到 Log 流的无缝关联,就是可观测性联动的核心价值。
12.3 全链路追踪机制
比日志更强大的是链路追踪(Tracing)。一个完整的 Agent 回合包含:思考、调用大模型、调用 Bash 工具、调用文件工具、大模型再总结。这些步骤是串并行的,仅仅看日志很难知道到底哪个环节最耗时;Tracing 记录每步的耗时、Token 消耗与工具调用,便于在用户投诉“Agent 又卡了”时快速定位瓶颈。
12.3.1 Provider 初始化与导出配置
在 Go 中集成 OpenTelemetry (OTel)时,仅调用 tracer.Start 还不够。运行时需要同时注册 TracerProvider、MeterProvider 和 W3C Trace Context 传播器。本地开发可选用 stdout Exporter,生产环境则通过 OTLP/gRPC 将 Trace 和 Metrics 发送到 OpenTelemetry Collector:
go
traceExporter, err := otlptracegrpc.New(ctx)
if err != nil {
    return nil, fmt.Errorf("create OTLP trace exporter: %w", err)
}
metricExporter, err := otlpmetricgrpc.New(ctx)
if err != nil {
    return nil, fmt.Errorf("create OTLP metric exporter: %w", err)
}

tp := sdktrace.NewTracerProvider(
    sdktrace.WithBatcher(traceExporter),
    sdktrace.WithResource(res),
    sdktrace.WithSampler(sdktrace.ParentBased(sdktrace.TraceIDRatioBased(0.1))),
)
mp := sdkmetric.NewMeterProvider(
    sdkmetric.WithResource(res),
    sdkmetric.WithReader(sdkmetric.NewPeriodicReader(metricExporter)),
)
otel.SetTracerProvider(tp)
otel.SetMeterProvider(mp)
otel.SetTextMapPropagator(propagation.NewCompositeTextMapPropagator(
    propagation.TraceContext{}, propagation.Baggage{},
))
配套工程根据 GO_CODER_OTEL_EXPORTER=stdout|otlp 选择导出器;如果设置了 OTEL_EXPORTER_OTLP_ENDPOINT,则默认启用 OTLP。程序关闭时依次 Shutdown MeterProvider 和 TracerProvider,将缓冲中的指标与 Span 刷出。
12.3.2 LLM 与工具的 Span 埋点
Provider 完成初始化后,Agent、LLM 和 Tool 才能在同一条 Context 传播链上建立父子 Span。
go
import (
    "go.opentelemetry.io/otel"
    "go.opentelemetry.io/otel/trace"
)

var tracer = otel.Tracer("go-coder/application")

// 改造 LLM 调用,加入 Span
func (llm *MyProvider) Chat(ctx context.Context, req ChatRequest) (*ChatResponse, error) {
    ctx, span := tracer.Start(ctx, "llm.inference")
    defer span.End()

    // 把关键指标记录到追踪图里
    span.SetAttributes(
        attribute.String("model", req.Model),
        attribute.Int("input_tokens", EstimateTokens(req.Messages, req.Model)),
    )

    resp, err := doActualCall(ctx, req)

    if err != nil {
        span.RecordError(err)
        span.SetStatus(codes.Error, "api request failed")
    } else {
        // 记录输出花费的时间和 Token
        span.SetAttributes(attribute.Int("output_tokens", resp.Usage.OutputTokens))
    }

    return resp, err
}
配套工程在 agent.run 中创建根 Span,在 llm.inference 中记录 Provider、Token 和终止原因,并为每个 tool.execute 创建兄弟 Span。同时,agent.runs、agent.errors 和 agent.turns 三个 Metric 由同一 MeterProvider 导出。
12.3.3 链路信息传播原理
OpenTelemetry 的数据模型可以概括为三层:Trace 代表一次完整的请求生命周期(对应 Agent 的一次 RunLoop 或一次 Verification 尝试),由全局唯一的 trace_id 标识;Span 是 Trace 中的一个操作单元,拥有 span_id、起止时间戳和键值属性;Context 则是 Span 在调用链中的“隐形载体”,tracer.Start(ctx, name) 返回的新 ctx 内嵌了当前 Span 的引用,下游函数只要接受并传递这个 ctx,OTel SDK 就能自动建立父子关系。
父子 Span 模型适用于串行调用:RunLoop 开启根 Span → LLM_Inference 作为子 Span → 其内部的 HTTP 重试再作为孙 Span。当 Agent 并发执行 5 个 Tool 时,模型变为 兄弟 Span (Sibling Spans):ExecuteBatch 开启一个父 Span,其下并行创建 5 个子 Span,它们共享同一个父节点、拥有相同或相近的起始时间,但在 Jaeger 瀑布图上表现为 5 条并排的时间条。Go 的惯用法是在每个 Goroutine 启动前调用 tracer.Start(ctx, “Tool_”+name),注意必须传入父 Context 的副本(ctx 本身是并发安全的),OTel 会自动将新 Span 挂载到正确的父节点下,无需手动管理 Span 树。
跨 Goroutine 传播的核心规则只有一条:永远传递 ctx,不要传递 Span 对象本身。context.Context 在 Go 中是 immutable 的,WithValue 和 OTel 的 Span 注入都是返回新 Context;Goroutine 闭包捕获的是创建时刻的 Context 快照,因此每个并发 Tool 的 Span 不会互相污染。如果某个 Tool 内部还有子操作(如 Bash 命令的网络请求),继续 tracer.Start(ctx, ...) 即可形成三级嵌套,整条 Agent 回合的“思维时空图”由此完整呈现。
当你在 Jaeger 或 Zipkin 中打开 Trace 时,可看到完整的调用链结构:一条较长的时间轴对应大模型推理,随后并行展开多条较短的时间轴对应并发 Tool 执行,最后汇总结束。
你的 Agent 的执行路径由此转化为可分析的调用链视图。
12.3.4 瀑布图阅读与分析
Jaeger 的 Trace 视图其实就是一棵按时间轴展开的调用树。阅读时关注三个核心概念:关键路径 是从 Trace 开始到结束耗时最长的那条串行链路,优化 Agent 延迟,首先压缩 Critical Path 上的 Span,而不是平均缩短所有 Span。空闲时间 表现为两个 Span 之间的空白间隙,通常意味着 Goroutine 调度延迟、Channel 等待或模型 API 的排队时间,如果 LLM Span 结束后到第一个 Tool Span 开始之间有显著间隙,说明 Agent 的状态机转换或 JSON 解析存在瓶颈。尾部延迟 则通过对比 P50 与 P99 Trace 的瀑布图形态来诊断:P99 上某个 Tool Span 突然拉长,往往是特定输入触发的慢路径(大文件读取、网络超时重试)。
定位“卡住”的实操步骤:第一,找到 Trace 总时长异常长的 Session;第二,在瀑布图中定位最后一个仍在运行或耗时最长的 Span,如果卡在 LLM_Inference,问题在模型侧或上下文过大;如果卡在 Tool_Bash 且无子 Span,问题在 shell 命令阻塞(如无 -timeout 的 go test);如果所有 Span 都已结束但 Trace 总时长仍很长,说明根 Span 的 defer span.End() 之前存在未被 Instrument 的代码段(状态机循环、内存压缩)。这就是我们在 12.1 中强调 Logs 与 Traces 互补的原因,Span 告诉你“卡在哪”,Log 告诉你“为什么卡”。
12.4 成本监控探针设计
Trace 帮我们定位了“卡在哪”,但企业部署 Agent 还需要回答另一个问题——“花了多少钱”。在企业内部,成本风控往往与可用性同等重要,我们需要实时监控当前任务的消费金额。
成本放大的速度往往超出直觉。一次看似简单的“帮我重构这个模块”请求,背后可能触发 15 轮 Think-Act-Observe 循环。每一轮都要把完整的对话历史、系统提示词、工具定义和最新的工具返回结果重新发送给模型,这是当前主流 LLM API 的无状态调用模型决定的。如果第 3 轮工具返回了一份 5000 行的编译日志却没有做截断,这 8 万 Token 的日志会在后续 12 轮请求中被完整重发,仅这一条工具输出就贡献了近 100 万 Token 的累计消耗。叠加多轮循环中的上下文膨胀、工具结果回流、模型路由失误(本可用轻量模型处理的简单任务被发到了旗舰模型),一次失控的会话在几分钟内烧掉 50 美元并不罕见。这就是第八章必须在源头构建三级压缩管道的根本原因,不做 Token 压缩,成本曲线会随轮次近乎线性地失控。
但压缩只能降低单次请求的体积,无法阻止循环本身的失控。比如 Agent 陷入“搜索→再搜索→再解释”的无意义震荡,或者 Grader 反复不通过导致 Verification Loop 跑满重试次数,每多一轮都是真金白银。因此,除了上游的 Token 压缩,还需要一层独立的实时消费监控与硬熔断机制。
在 Go 中,通过向 context.Context 注入自定义的账单统计结构,可以有效实现全局的无侵入监控。
go
type contextKey string
const costTrackerKey contextKey = "costTracker"

type CostTracker struct {
    mu            sync.Mutex
    TotalCostUSD  float64
    MaxAllowedUSD float64
}

// 在入口处注入
tracker := &CostTracker{MaxAllowedUSD: 2.0} // 本次任务最多花 2 美元
ctx = context.WithValue(context.Background(), costTrackerKey, tracker)

// 在 LLM 返回结果后,扣除费用
func recordCost(ctx context.Context, inputTokens, outputTokens int, model string) error {
    tracker, ok := ctx.Value(costTrackerKey).(*CostTracker)
    if !ok { return nil }

    cost := calculateCost(inputTokens, outputTokens, model)

    tracker.mu.Lock()
    defer tracker.mu.Unlock()
    tracker.TotalCostUSD += cost

    if tracker.TotalCostUSD > tracker.MaxAllowedUSD {
        return fmt.Errorf("资金熔断!已消费 $%.2f,超过上限 $%.2f", tracker.TotalCostUSD, tracker.MaxAllowedUSD)
    }
    return nil
}
如果在某次执行后 recordCost 返回了熔断错误,这个 Error 会顺着状态机一路向上抛出,触发我们之前写的安全防线并优雅挂起程序,彻底杜绝“破产跑路”的可能。
calculateCost(inputTokens, outputTokens, model) 的定价逻辑遵循 模型供应商的分价模型:input tokens 与 output tokens 按不同单价计费(例如 Claude Sonnet 4 的 input 约 $3/M tokens,output 约 $15/M tokens,output 通常贵 3-5 倍,因为自回归生成的算力成本更高)。精确实现应维护一张 map[string]ModelPricing 定价表,分别乘以 input/output 计数后相加;对于支持 Prompt Cache 的模型,还需区分 cache_read_tokens(通常按 input 价格的 10% 计费)和 cache_write_tokens(按 input 价格的全价或折扣价计费),否则成本统计会系统性偏高或偏低。
context.WithValue 的读取链遵循 Go 的单向传播语义:WithValue(parent, key, tracker) 返回的新 Context 在调用链中向下传递,ctx.Value(costTrackerKey) 在任意深度读取时沿链表向上查找第一个匹配的 key。这意味着 RunLoop 入口注入一次 CostTracker 指针后,LLM Provider、Tool 中间件、甚至 Grader 内部的 recordCost(ctx, ...) 都能无侵入地访问同一份累计账单,指针共享保证了 TotalCostUSD 的原子累加对所有读者可见。注意:WithValue 应仅用于请求级元数据,不应滥用为通用参数传递;且 key 必须是自定义未导出类型(如 type contextKey string),避免与其他包的 key 冲突。
熔断逻辑的设计要点:MaxAllowedUSD 是软预算(单次任务上限),与 TUI 章节中展示的 calculateCost 累计 burn rate 配合,形成“实时可见 + 硬熔断”的双层风控。当 recordCost 返回熔断错误时,该 Error 应被 OTel Span 记录(span.RecordError),并在 slog 中输出当前 TotalCostUSD 和触发熔断的调用点,这样事后审计可以精确还原“在哪一轮、哪次 LLM 调用”导致了超支。
上述探针解决的是“感知”问题,知道花了多少钱。但工业级 Agent 的成本工程远不止监控,而是一条从预防、优化到兜底的完整链路。本书在多个章节中分别实现了这条链路的不同环节,此处做一次系统性串联。
第一层:Token 源头压缩。 成本的根源是 Token 消耗,而 Token 消耗的最大变量是上下文长度。记忆压缩章节的三级压缩管道,Buffer 截断(§8.2,单次工具输出的头尾裁剪)→ Snip 压缩(§8.3 softLimit,批量裁剪历史中的冗长工具输出)→ deepCompact 摘要(§8.3 hardLimit,LLM 全量重写历史),直接从源头减少每轮 LLM 请求的 input token 数量。以 20 轮长会话为例,执行一次 deepCompact 后,后续每轮 input token 通常会明显下降;若不做压缩,同一任务在 30 轮后单次请求的 input 量会随历史累积持续膨胀,成本曲线近乎线性失控。
第二层:Prompt Cache 利用。 Anthropic 和 OpenAI 均支持 Prompt Caching:当连续请求的 prompt 前缀重复度高时(如 系统提示词 + 工具定义 + 历史对话前 N 轮),API 侧会命中缓存,cache_read_tokens 按 input 价格的约 10% 计费。Agent Loop 天然具备高缓存命中率,因为每轮请求只是在上一轮的 messages 数组末尾追加新内容,前缀完全一致。工程上需注意两点:其一,系统提示词 和 tools 定义应放在 messages 数组最前端且保持稳定,避免中途插入动态内容破坏前缀连续性;其二,CostTracker 应区分 cache_read_tokens 和 cache_creation_tokens 分别计价,混用会导致成本统计出现明显偏差。
第三层:模型路由与降级。 并非所有任务都需要最强模型。一种任务分级路由机制(详见第 14 章)可根据 prompt 长度和工具集复杂度将任务分为 Economy / Standard / Premium 三档,分别路由到不同价格的模型。一个简单的文件读取任务用轻量模型处理,成本仅为旗舰模型的 1/10。路由层与 LLM 驱动器章节的多 Provider 降级链配合:Premium 模型超时或限流时自动降级到 Standard,既保障可用性又控制峰值成本。
第四层:预算熔断与审计。 即前文的 CostTracker 硬熔断机制,加上 12.5 节中 maxRetries × MaxTurns 的二维轮次预算。两者协同构成成本的最终防线,即使路由和压缩都未能阻止异常消耗,预算熔断也能将单次任务的损失控制在 MaxAllowedUSD 以内;缺少这层兜底时,一次 runaway 循环可在数分钟内耗尽月度 API 预算。
四层策略的优先级应从上到下依次部署:源头压缩的 ROI 最高(一次实现,每轮受益),Prompt Cache 几乎零成本(架构天然适配),模型路由需要业务分级策略,而预算熔断是最后的安全网。
12.5 内嵌验证回环体系
成本探针守住了"花了多少钱"的经济安全网,但生产级 Agent 还要回答一个同等重要、甚至更棘手的问题:钱花对了吗,产出的结果真的正确吗?成本可以用 Token 精确计量,质量却无法自动保证——这正是本节验证回环要填补的空白。
前面几章中,我们的 RunLoop 是一个“执行到完成”的线性循环:模型思考 → 调用工具 → 观察结果 → 继续思考。这个循环的问题在于,它只做事,不检查质量。
想象一下:你让 Agent 重构一个 Go 项目,它修改了 5 个文件后直接宣布“任务完成”,但其实第 3 个文件引入了编译错误。用户不得不手动执行 go build 才发现问题。
工业级 Agent 需要一个验证回环:在 Agent 认为自己“做完了”之后,自动运行一组检查器(Grader),如果不通过,就把失败原因喂回模型,让它自行修正。这就是 LangChain 所说的 “Verification Loop”,包裹在 Agent Loop 外层的第二层循环。
12.5.1 验证回环结构设计
LangChain 将 Verification 作为 Agent Executor 链路上的后置节点,Validation 与 Generation 通过 Message 通道解耦,范式是 Generate → Validate → Reflect → Retry。本书采用类似的分层思想,但把验证提升为独立的 VerificationLoop 编排器:内层 RunLoop 跑完一个“任务完成”周期后,外层再统一运行 []Grader;失败时注入 [SYSTEM] 反馈并重置状态。主要工程差异在于:MaxTurns 与 maxRetries 可独立配置,验证不消耗推理轮次;Grader 以 Go 接口切片组合,类型检查在编译期完成。两种路径都指向“外层质检、内层执行”,选型取决于团队更熟悉 Chain 拼装还是显式编排器,本书倾向后者,以便与 Clean Architecture 的分层一致。
12.5.2 评估接口与工作机制
go
type GradeResult struct {
    Pass     bool
    Feedback string // 失败时的诊断信息,会喂给大模型
    Score    float64
}

type Grader interface {
    Name() string
    Grade(ctx context.Context, agentCtx *AgentContext) GradeResult
}
Grader 可以是确定性的(编译检查、lint 检查、测试通过率),也可以是模型驱动的(用另一个 LLM 评审输出质量)。确定性 Grader 成本低、结果精确,应该优先使用。
模型驱动 Grader 说白了就是 LLM-as-a-Judge 模式:向一个(通常更便宜或更专注的)模型发送 评分量表提示词,要求它根据预定义的维度(代码可读性、测试覆盖率、需求完成度)对 Agent 的输出进行 Pass/Fail 或 1-5 分打分,并将 Feedback 字符串作为诊断信息返回。Rubric 的设计质量直接决定 Grader 的可靠性,好的 Rubric 包含:明确的评判标准、正反面示例(few-shot)、以及“若不确定则判 Fail”的保守指令。
上下文隔离是模型 Grader 的关键架构决策。推荐做法是 不共享 Agent 的完整对话历史,而是仅向 Judge 模型传递:(1) 原始用户任务描述 (2) Agent 的最终输出或 diff 摘要 (3) 可选的确定性 Grader 结果(如编译日志)。这样可以避免 Judge 被 Agent 的中间推理“带偏”,也显著降低 Token 成本。若确实需要评估“规划过程是否合理”,应单独传递 GetToolCallTrajectory() 的摘要,而不是全量 Message 列表。
幻觉风险是 LLM-as-a-Judge 的固有缺陷:Judge 可能“编造”不存在的代码问题,或对明显正确的输出给出错误否定。缓解策略包括:优先用确定性 Grader 做硬门槛,模型 Grader 仅作软评分;要求 Judge 输出必须引用具体证据(文件名、行号、错误信息);对 Judge 结果本身做抽检(人工或交叉 Judge)。在生产环境中,模型 Grader 应定位为 “辅助信号” 而不是 “唯一门禁”,这与 12.5.3 中 CompileGrader / TestGrader 优先的设计哲学一致。
12.5.3 内置实现方案
前面定义了 Grader 接口,接下来给出三个最常用的内置实现:编译检查、测试运行和静态分析。它们共享同一模式——通过 exec.CommandContext 调用外部工具链,根据退出码判定通过与否,并将标准输出作为反馈写入 GradeResult。这种设计使得新增检查器(如安全扫描、类型检查)只需复制同一模板并替换命令即可。
go
type CompileGrader struct {
    WorkDir string
}

func (g *CompileGrader) Name() string { return "compile" }

func (g *CompileGrader) Grade(ctx context.Context, agentCtx *AgentContext) GradeResult {
    cmd := exec.CommandContext(ctx, "go", "build", "./...")
    cmd.Dir = g.WorkDir
    output, err := cmd.CombinedOutput()
    if err != nil {
        return GradeResult{
            Pass:     false,
            Feedback: fmt.Sprintf("编译失败:\n%s", string(output)),
        }
    }
    return GradeResult{Pass: true, Score: 1.0}
}

type TestGrader struct {
    WorkDir string
}

func (g *TestGrader) Name() string { return "test" }

func (g *TestGrader) Grade(ctx context.Context, agentCtx *AgentContext) GradeResult {
    cmd := exec.CommandContext(ctx, "go", "test", "./...", "-count=1", "-timeout=60s")
    cmd.Dir = g.WorkDir
    output, err := cmd.CombinedOutput()
    if err != nil {
        return GradeResult{
            Pass:     false,
            Feedback: fmt.Sprintf("测试失败:\n%s", string(output)),
        }
    }
    return GradeResult{Pass: true, Score: 1.0}
}

type LintGrader struct {
    WorkDir string
}

func (g *LintGrader) Name() string { return "lint" }

func (g *LintGrader) Grade(ctx context.Context, agentCtx *AgentContext) GradeResult {
    cmd := exec.CommandContext(ctx, "golangci-lint", "run", "./...")
    cmd.Dir = g.WorkDir
    output, err := cmd.CombinedOutput()
    if err != nil {
        return GradeResult{
            Pass:     false,
            Feedback: fmt.Sprintf("Lint 警告:\n%s", string(output)),
        }
    }
    return GradeResult{Pass: true, Score: 1.0}
}
12.5.4 编排器设计与注入
go
type VerificationLoop struct {
    agent      *Agent
    graders    []Grader
    maxRetries int
}

func NewVerificationLoop(agent *Agent, maxRetries int, graders ...Grader) *VerificationLoop {
    return &VerificationLoop{
        agent:      agent,
        graders:    graders,
        maxRetries: maxRetries,
    }
}

func (v *VerificationLoop) Run(ctx context.Context, agentCtx *AgentContext) error {
    for attempt := 0; attempt <= v.maxRetries; attempt++ {
        // 内层:标准 Agent Loop
        if err := v.agent.RunLoop(ctx, agentCtx); err != nil {
            return err
        }

        // 外层:验证关卡
        allPassed := true
        var feedback strings.Builder
        for _, g := range v.graders {
            result := g.Grade(ctx, agentCtx)
            slog.Info("grader completed",
                slog.String("grader", g.Name()),
                slog.Bool("pass", result.Pass),
                slog.Float64("score", result.Score),
                slog.Int("attempt", attempt+1),
            )

            if !result.Pass {
                allPassed = false
                feedback.WriteString(fmt.Sprintf("[%s] %s\n", g.Name(), result.Feedback))
            }
        }

        if allPassed {
            slog.Info("verification passed", slog.Int("attempts", attempt+1))
            return nil
        }

        if attempt == v.maxRetries {
            return fmt.Errorf("verification failed after %d attempts", v.maxRetries+1)
        }

        // 将失败反馈注入对话,触发下一轮自我修正
        agentCtx.AppendMessage(domain.Message{
            Role: "user",
            Content: fmt.Sprintf(
                "[SYSTEM] 你的输出未通过自动验证,请修正以下问题后重试:\n%s"+
                    "\n请直接修复,不要道歉或解释原因。",
                feedback.String(),
            ),
        })

        // 重置状态,允许 Agent 继续执行
        agentCtx.CurrentState = StateThinking
        agentCtx.Transition = Transition{Reason: "Verification_Retry"}
    }

    return nil
}
在组合根中,只需一行升级即可启用验证回环:
go
// 原来的调用
// err := agent.RunLoop(ctx, agentCtx)

// 升级为验证回环
vLoop := NewVerificationLoop(agent, 2, // 最多重试 2 次
    &CompileGrader{WorkDir: workDir},
    &TestGrader{WorkDir: workDir},
)
err := vLoop.Run(ctx, agentCtx)
现在 Agent 的执行变成了双层循环(如图 12-1 所示):
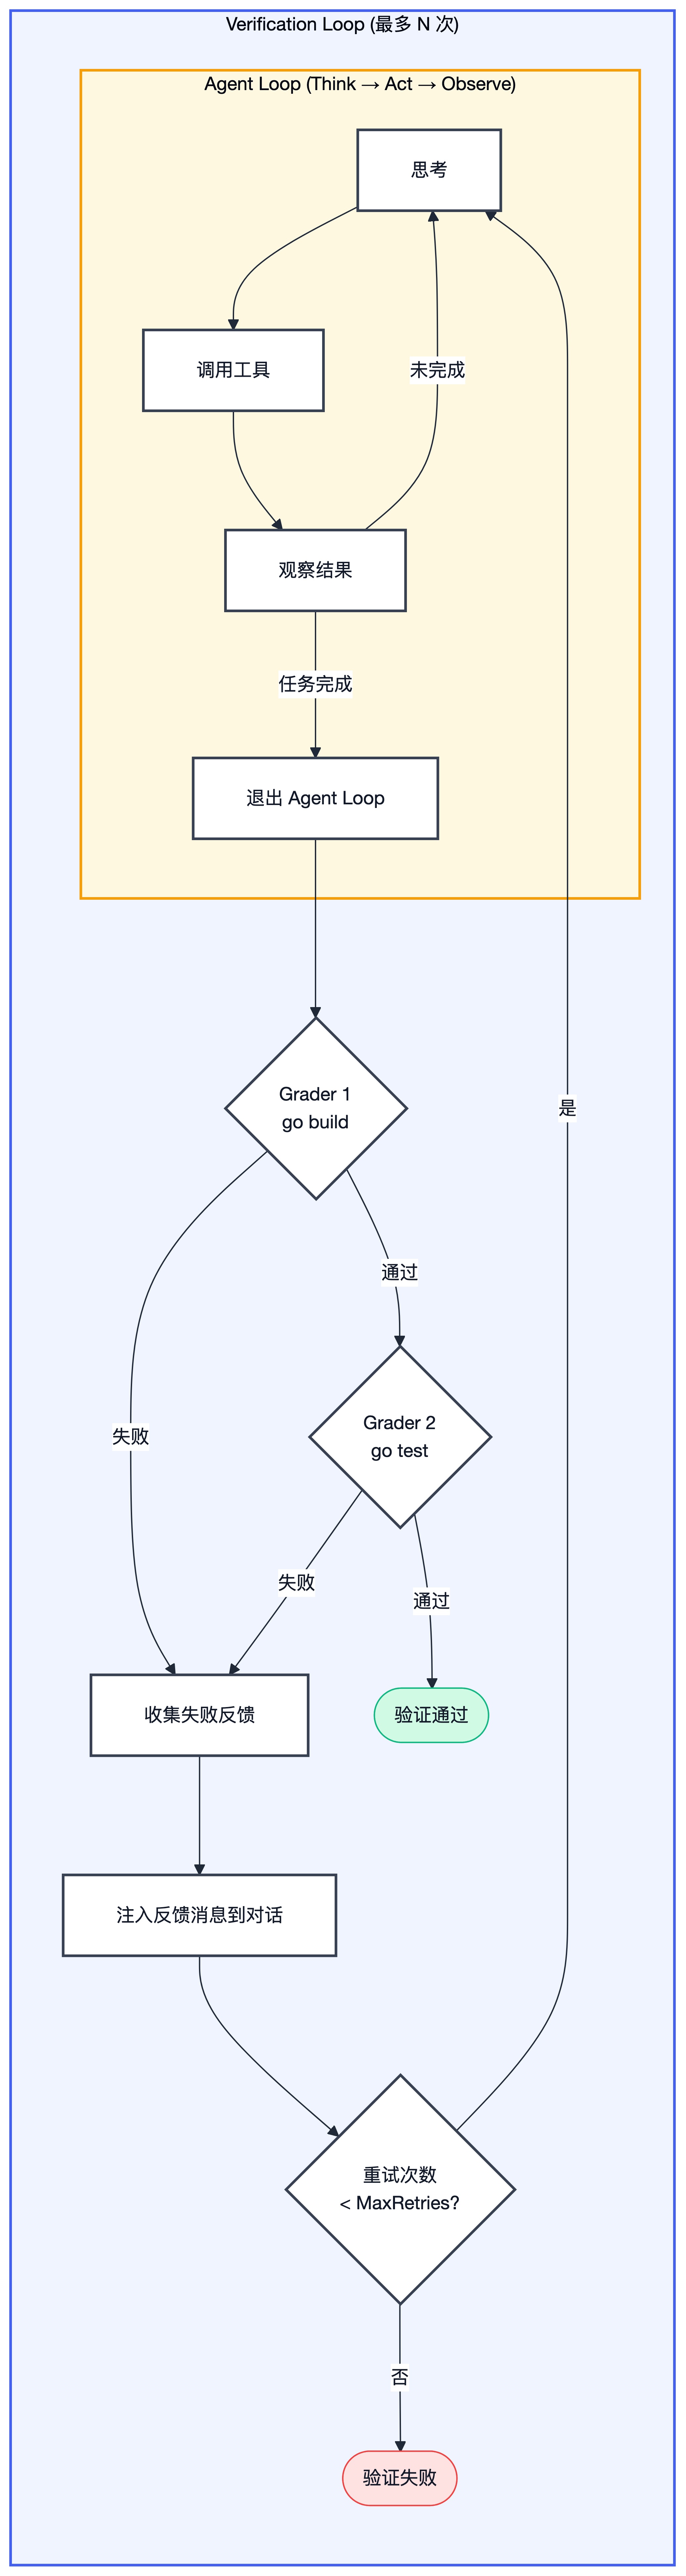
text
┌── Verification Loop (最多 3 次) ──────────────────────┐
│   ┌── Agent Loop (Think → Act → Observe) ──────────┐  │
│   │   Turn 1 → Turn 2 → ... → "任务完成"            │  │
│   └────────────────────────────────────────────────┘  │
│   ↓                                                    │
│   Grader: go build ✅ → go test ❌                      │
│   ↓                                                    │
│   注入反馈 → 重新进入 Agent Loop                        │
│   ┌── Agent Loop ──────────────────────────────────┐  │
│   │   根据测试报错修复 → "任务完成"                    │  │
│   └────────────────────────────────────────────────┘  │
│   ↓                                                    │
│   Grader: go build ✅ → go test ✅  → 通过!            │
└────────────────────────────────────────────────────────┘
12.5.5 轮次预算管理策略
Verification Loop 的每次重试都会向 agentCtx.Messages 注入一段 [SYSTEM] 反馈,其中包含所有失败 Grader 的完整输出(如 go test 的全量报错、golangci-lint 的数十条警告)。如果同一个编译错误在 3 轮 Verification 中反复出现,Agent 的对话上下文中会累积 3 份高度相似的 compile log,这就是 上下文膨胀 问题。膨胀的直接后果是:后续 LLM 调用的 input tokens 线性增长、延迟上升、模型注意力被大量重复错误信息稀释,反而降低修复成功率。
maxRetries 与 Agent MaxTurns 构成二维预算:maxRetries=2 意味着最多 3 次 Verification 尝试(初始 + 2 次重试),每次尝试内层 Agent 最多消耗 MaxTurns 轮推理。总推理轮次的上界约为 (maxRetries + 1) × MaxTurns,但实际往往更低,因为 Agent 可能在第 2 轮就宣布“任务完成”触发 Grader。工程建议:重试时将 Feedback 截断或摘要(只保留前 50 行编译错误 + 错误类型统计),而不是全量注入;同时考虑在重试前调用 ForceCompact(ctx, agentCtx) 清除已解决问题的中间 Tool 输出,仅保留最终代码状态和最新 Feedback。
两者应独立配置而不是合并为单一计数器:LangChain 式的 max_iterations 将验证与推理混为一体,在复杂任务中极易出现“验证还没跑,推理轮次已耗尽”的尴尬。本书的分离设计允许你对高风险任务设置 MaxTurns=15, maxRetries=3,对低风险任务设置 MaxTurns=5, maxRetries=0,精确把握成本与质量的平衡。
权衡提示:验证回环会增加延迟和 Token 消耗(每次重试可能花费数千个 Token)。对于“修复 Bug”、“重构代码”等对正确性要求高的任务,这个代价非常值得;但对于“帮我写个注释”这类低风险任务,直接跳过验证即可。可以通过任务标签或配置来动态控制是否启用。
12.6 评估流水线搭建
软件工程的最后一道防线是自动化测试。但是,你如何写单元测试去断言一个每次说话都不一样的大模型?
业界标准的做法是搭建 Eval 管线。我们借用 SWE-bench 的思想,在 Go 中实现一套基于断言机制的轻量级测试框架。
12.6.1 自动化评测范式引入
SWE-bench 是当前 Agent 代码修复能力的事实标准基准,其评测原理可以拆解为四步流水线:(1) 任务实例化,从真实 GitHub Issue 提取问题描述和对应仓库快照(某个 commit 下的代码库) (2) Agent 生成 Patch,Agent 在沙箱中读取 Issue、浏览代码、输出 unified diff 格式的修复补丁 (3) Patch 应用,评测框架将 Patch 自动 git apply 到代码库,若 Patch 格式非法或与应用上下文冲突则直接判 Fail (4) 测试套件判定,运行该仓库的现有测试(通常包含 fail-to-pass 测试和 pass-to-pass 回归测试),只有全部通过才计为 Resolved。
SWE-bench 的核心设计哲学是 “行为结果导向”,不评判 Agent 的中间推理是否“合理”,只评判最终 Patch 是否让测试从红变绿。这与本章 12.5 的 go build 断言同构,但 SWE-bench 的规模(数千个真实 Issue、多仓库、多语言)和严格性(Patch 必须可应用、回归测试不能破坏)使其成为模型能力的“高考”。在 Go 中搭建 Eval Pipeline 时,不必复刻 SWE-bench 的全部复杂度,但应继承其 Issue → 沙箱 → 断言 的三段式结构,并根据团队场景定制测试集。
12.6.2 评估的分层设计
工业级 Eval Pipeline 不是一组扁平的测试函数,而是分层组织的能力矩阵。难度曲线:从 L1 (单行语法修复)到 L5 (跨模块重构),确保模型升级时在简单题上不退步、在难题上有区分度。回归集:每次 Prompt 或模型变更后必跑的核心用例(约 20-30 个),运行频率高、反馈快,是 CI 门禁。完整集:覆盖所有难度级别的数百个用例,用于发布前的全面评估,运行频率低( nightly / weekly)。
Flaky 处理是 Agent Eval 特有的挑战,同一测试用例在不同运行中可能因模型的非确定性而通过或失败。标准做法是 多次运行 + 统计显著性:对每个用例运行 N 次(通常 N=3 或 5),以 pass rate ≥ 阈值(如 2/3)作为最终判定,而不是单次 pass/fail。Eval 报告应输出 confidence interval (如 “85% ± 5%”)而不是单点分数,避免“跑一遍 90 分、再跑一遍 70 分”的误判。对于已知的 flaky 用例,标记为 Skip 或降低权重,并单独追踪其 pass rate 趋势,如果某用例的 pass rate 持续下降,说明 Agent 在该类任务上确实在退化,而不是随机波动。
核心思想:不要断言它说了什么,只断言它的行为结果。
go
// 这是一个集成测试函数
func TestAgent_CanFixSyntaxError(t *testing.T) {
    // 1. 准备沙箱环境
    tmpDir := t.TempDir()
    // 故意写一个有语法错误的 Go 文件
    badCode := "package main\n\nfunc main() { fmt.Printl(\"missing n\") }\n"
    os.WriteFile(filepath.Join(tmpDir, "main.go"), []byte(badCode), 0644)

    // 2. 初始化 Agent,限制只允许它思考 3 轮
    agentCtx := &AgentContext{
        MaxTurns: 3,
        Messages: []Message{{Role: "user", Content: "修复当前目录下的语法错误"}},
    }

    // 3. 运行 Agent
    err := agent.RunLoop(context.Background(), agentCtx)
    require.NoError(t, err)

    // 4. 断言行为结果(验证它的工作成果)
    cmd := exec.Command("go", "build", "main.go")
    cmd.Dir = tmpDir
    err = cmd.Run()

    // 如果编译通过了,说明 Agent 成功找到了文件,修改了代码,保存了文件
    assert.NoError(t, err, "Agent failed to fix the syntax error")
}
12.6.3 复杂能力的量化评估
上述通过编译状态来评估的方法适合“修复 Bug”等明确结果的任务。但在工业场景中,我们还需要评估智能体的宏观规划与工具使用效率。比如:完成同样的重构任务,Agent A 盲目乱找文件耗费了 20 轮对话,而 Agent B 通过合理的 grep 和 AST 分析 只用了 5 轮。
针对这类评估,我们需要在 Eval 管线中引入轨迹断言机制。
12.6.4 轨迹数据与追踪对比
轨迹 是 Agent 一次完整执行过程中所有可观测行为的时序记录,在数据结构上通常表示为 []ToolCallEvent 切片,每个元素包含:ToolName、Arguments(序列化后的参数)、Result(输出摘要或错误信息)、Timestamp、Duration、IsError 等字段。采集点分布在 Agent 状态机的 Act 阶段,每次 Tool.Execute 返回后,将调用元数据 append 到 AgentContext 的内部事件流中;若已接入 OTel,同一时刻也会有一个对应的 Tool Span 结束。
Trajectory 与 OTel Span 是 同一行为的两种投影:Span 是分布式追踪视角(带 trace_id、父子关系、跨服务传播),Trajectory 是 Agent 领域视角(带 Tool 语义、Eval 断言友好的结构化字段)。推荐在 Tool.Execute 处双写,既 span.End() 又 agentCtx.RecordToolCall(event),Eval 管线读取 Trajectory 做断言,生产环境读取 Span 做性能分析,两者通过 trace_id + span_id 关联。对于需要断言“调用顺序”的场景(如先 Grep 后 EditFile),Trajectory 的数组顺序即为 Ground Truth;对于需要断言“并发行为”的场景,则回查 OTel 中 sibling Spans 的时间重叠关系。
在执行完毕后,我们不仅要检查最终文件是否正确,还要提取 AgentContext 中完整保存的事件流轨迹,对其进行断言:
go
func TestAgent_PlanningEfficiency(t *testing.T) {
    // ... 前置准备:要求 Agent 把一个大文件拆分成多个小文件 ...

    err := agent.RunLoop(context.Background(), agentCtx)
    require.NoError(t, err)

    // 除了断言结果,还要进行多维度的“轨迹断言”
    trajectory := agentCtx.GetToolCallTrajectory() // 自定义方法,提取所有调用记录

    // 1. 断言:是否在乱改代码前,先进行了信息收集?
    firstTool := trajectory[0].ToolName
    assert.Contains(t, []string{"glob", "grep", "read_file"}, firstTool, "Agent 应该先进行检索而不是直接修改")

    // 2. 断言效率:总轮数是否在合理范围内?
    assert.LessOrEqual(t, agentCtx.TurnCount, 8, "任务过于冗长,规划能力存在缺陷")

    // 3. 断言精确度:是否出现了无效的工具调用(比如读取不存在的文件报错)
    errorCount := countFailedToolCalls(trajectory)
    assert.LessOrEqual(t, errorCount, 1, "幻觉严重,调用了过多无效工具")
}
通过这种结合了最终状态断言与行为轨迹断言的双轨评估机制,配合几十个不同难度的测试集(从改单行 Bug 到重构整个目录),你就拥有了一个类似于 OpenAI 用来评测大模型的“天梯榜”。每当你修改了 系统提示词 或者替换了新模型,只需跑一遍 Eval,分数变化一目了然。
12.7 自动调优机制
自动调优建立在前几节的观测基础之上。先用一张表回顾全书的多层循环体系,如表 12-1 所示——其中循环 3(事件驱动触发)将在第十三章展开,本节聚焦循环 4:谁来自动化“改进”?
表 12-1 多层循环与本书对应
| 层级 | 功能 | 本书对应 |
|---|---|---|
| 循环 1:Agent Loop | 模型循环调用工具直到任务完成 | 状态机章节 |
| 循环 2:Verification Loop | 输出自动验证,不通过则带反馈重试 | 12.5 |
| 循环 3:Event-driven 循环 | Webhook / Cron / MQ 触发,Agent 后台常驻运行 | 13.7 |
| 循环 4:Trace 驱动调优 | 聚合生产 Trace,自动提炼配置改进建议 | 12.7(本节) |
| 可观测层 | Trace/日志/指标记录每一步行为 | 12.1-12.3 |
循环 3(事件驱动触发)是循环 1/2 的调度外壳,决定“何时启动 Agent”,完整实现见第十三章;本节进入循环 4——谁来自动化“改进”?
每次 Agent 运行都会产生丰富的 Trace 数据:调用了哪些工具、在哪一步失败、哪个 Grader 反复不通过、哪种任务消耗 Token 最多。这些数据蕴含着巨大的优化信号。第四层循环的目标是:从生产 Trace 中自动提取失败模式,反哺回 Agent 配置。
12.7.1 追踪驱动的迭代调优
爬山优化 是经典局部搜索优化:在状态空间中,从当前配置出发,遍历邻域内的候选状态,若某候选的目标函数值更优则 Accept 并移动过去,否则 Reject 并尝试下一个邻居;重复直到找不到更优邻居(到达局部最优)。其致命弱点是局部最优陷阱,若初始点位于次优峰附近,算法会卡在该峰顶而无法到达全局最优。
本书 12.6 的实现是 启发式半自动调优,而不是严格意义上的 Hill Climbing 优化算法。严格 Hill Climbing 需要:(1) 明确定义的状态空间(如 Prompt 模板的 token 序列) (2) 可量化的目标函数(如 Eval pass rate) (3) 系统性的邻域生成(如 Prompt 的 paraphrase 变体) (4) 自动 Accept/Reject 决策。我们的 AnalyzeTraces + GenerateImprovements 流程只覆盖了 (4) 的人工审批版本,LLM 分析师生成建议,人类决定是否采纳,且缺少 (2) 的自动回测闭环。保留“Hill Climbing”这一命名,是因为其核心隐喻仍然成立:从当前运营状态(Trace 统计)出发,向“更好”的配置方向小步移动,避免一次性大幅改动导致系统崩溃。若追求术语精确,也可称其为 “Trace-Driven Config Iteration” 或 “Ops Feedback Loop”,但“Hill Climbing”更直观地传达了“小步迭代、持续爬坡”的产品心智。这一 Trace 驱动调优 流程定期从生产 Trace 中提取失败模式,生成配置改进建议并经人工审批后生效,使 Agent 系统随使用量增加而持续改进。
系统的全景架构,如图 12-2 所示:
12.7.2 追踪聚合与模式分析
单次 Trace 只能看到个案,而将数十上百条 Trace 聚合后才能发现系统级趋势:哪个 Grader 最容易失败、哪个工具报错率最高、是否存在反复出现的错误模式。AnalyzeTraces 负责完成这一步统计汇总,其输出将作为下一节自动调优的输入数据源。
go
type TraceAnalysis struct {
    TotalRuns           int
    AvgTurns            float64
    AvgCostUSD          float64
    TopFailingGraders   []GraderStats
    TopFailingTools     []ToolStats
    CommonErrorPatterns []ErrorPattern
}

type ErrorPattern struct {
    Pattern   string
    Frequency int
    Example   string
}

func AnalyzeTraces(traces []AgentTrace) TraceAnalysis {
    var analysis TraceAnalysis
    analysis.TotalRuns = len(traces)

    var totalTurns, totalCost float64
    graderFails := make(map[string]int)
    toolErrors := make(map[string]int)

    for _, t := range traces {
        totalTurns += float64(t.TurnCount)
        totalCost += t.TotalCostUSD

        for _, g := range t.GraderResults {
            if !g.Pass {
                graderFails[g.GraderName]++
            }
        }
        for _, tc := range t.ToolCalls {
            if tc.IsError {
                toolErrors[tc.ToolName]++
            }
        }
    }

    analysis.AvgTurns = totalTurns / float64(len(traces))
    analysis.AvgCostUSD = totalCost / float64(len(traces))
    analysis.TopFailingGraders = rankByFrequency(graderFails)
    analysis.TopFailingTools = rankByFrequency(toolErrors)
    analysis.CommonErrorPatterns = extractPatterns(traces)
    return analysis
}
12.7.3 优化建议生成逻辑
上一节完成了数据聚合,但人工逐条分析 TraceAnalysis 仍然耗时。一个直觉是:既然大模型擅长从结构化数据中提炼规律,不如让它充当“Agent 系统的性能分析师”,自动生成可操作的优化建议。下面的 GenerateImprovements 将聚合统计注入 Prompt,要求模型输出针对具体配置项的修改方案:
go
func GenerateImprovements(ctx context.Context, llm domain.LLMPort, analysis TraceAnalysis) ([]Suggestion, error) {
    prompt := fmt.Sprintf(`你是一个 Agent 系统的性能分析师。
以下是最近 %d 次运行的统计数据:

- 平均轮数: %.1f
- 平均费用: $%.2f
- 最常失败的检查器: %v
- 最常报错的工具: %v
- 反复出现的错误模式: %v

请分析根因,并给出具体的优化建议。每条建议必须包含:

1. 问题描述
2. 建议修改的配置项(system_prompt / tool_config / grader_config)
3. 具体的修改内容`,
        analysis.TotalRuns, analysis.AvgTurns, analysis.AvgCostUSD,
        analysis.TopFailingGraders, analysis.TopFailingTools,
        analysis.CommonErrorPatterns,
    )

    resp, err := llm.Chat(ctx, domain.ChatRequest{
        Messages: []domain.Message{{Role: "user", Content: prompt}},
    })
    if err != nil {
        return nil, err
    }

    return parseSuggestions(resp.AssistantMessage.Content), nil
}
12.7.4 幻觉防护机制
自动调优面临的最大风险是 LLM 分析师自身的幻觉。GenerateImprovements 的输出是未经验证的自然语言建议,大模型作为分析师时,极易基于统计相关性“编造”因果链。例如,它可能会得出结论说“test Grader 失败率高是因为系统提示词太长”,而实际的根因往往只是测试环境缺少某个依赖包。
因此,每条生成的建议必须经过严格的验证门禁才能生效。在实际工程落地中,通常采用以下三级验证流程:
- L1 — 静态审查:建议是否指向了明确的配置项(如
system_prompt/tool_config/grader_config)?修改内容是否具体可操作?如果建议模糊(比如仅说“请优化提示词”),则直接拦截并丢弃。 - L2 — 评估回跑:在隔离分支应用建议的配置变更,运行前文所述的 Eval 回归测试集(约 20-30 个核心用例)。测试完成后再观察数据变化:只有在拦截率不下降,且目标指标(如平均轮数、平均成本)确实改善时,才允许进入 L3 阶段。
- L3 — A/B 对比(可选):在真实的生产流量中按 10%/90% 分流新旧配置。运行 24-48 小时后对比 Trace 聚合指标,确认完全无回归现象后,再进行全量切换。
三级验证门禁解决的是“建议生成后如何把关”的问题。而在上游,我们还可以通过工程手段,从源头上压缩幻觉的产生空间:
- 限制信息范围:向分析师 Prompt 中只注入聚合统计数据(如
AnalyzeTraces的输出),坚决不给原始 Trace 全文,从而压缩模型“凭空捏造虚假失败案例”的空间。 - 强制证据引用:要求 LLM 生成的每条建议,必须引用
CommonErrorPatterns中的具体 Pattern 和发生频率作为数据依据。 - 严格的 Schema 校验:对分析师的输出进行强结构化解析(通过
parseSuggestions映射为具体的[]Suggestion结构体),一旦发现字段缺失或逻辑异常则直接丢弃重试。
最终,人机协同审批将作为这套机制的终极防线(详见第九章)。执行层全自动运行,决策层由人类守门,这与前面所讲的“Grader 自动打分,人类最终定夺”的分工哲学是一脉相承的。
12.7.5 自动化生效闭环流程
与前面的循环不同,第四层循环的周期是天/周级别,而不是实时。一种典型的落地方式:
text
每日 Cron 任务
  │
  ├─ 1. 从 OTel 后端拉取最近 24 小时的 Trace
  ├─ 2. 运行 AnalyzeTraces() 聚合统计
  ├─ 3. 调用 GenerateImprovements() 生成建议
  ├─ 4. 输出 Markdown 报告 + 自动提 PR 修改配置
  └─ 5. 人工审批后合并(人机协同)
注意第 5 步的人工审批:与 循环 1/2 中的全自动执行不同,配置调优直接影响 Agent 的全局行为,必须有人类把关。这也是 HITL 在更高层级的体现,执行层自动化,决策层人类守门。
12.7.6 模型微调与持续优化
上文所述的自动调优,主要局限于修改工具的逻辑和调整外围的 系统提示词。
但在极端的垂直领域中,如果大模型天生就不擅长输出 JSON,或者频繁在调用某个公司极其古老的内部 API 时产生结构幻觉,仅仅在外围加 循环 和改 Prompt 已经触及了能力的天花板。
最高阶的 Agent 工程,不仅在模型外面套循环,还会用循环产生的数据反哺模型自身的权重。利用我们在可观测性体系中收集到的、带有正向奖励的成功执行轨迹,工程团队可以构建高质量的数据集。将这些精挑细选的(状态 → 工具调用)样本,送入开源基座模型进行 SFT 或 DPO。
最终,你会得到一个被你们自己的 Agent Loop 喂养出来的、“特化于调用你们公司内部 API” 的定制大模型。这是可观测性反哺 AI 系统的终极闭环,不过 SFT/DPO 的数据质量与标注成本仍是主要瓶颈,小规模团队往往先从 prompt 与工具配置调优入手,再视 ROI 决定是否上微调。
12.8 模块化测试回顾
至此,我们已经将原本难以观测的 Agent 变得完全可度量,并串联起追踪 → 验证 → 评估 → 优化的完整闭环:
- 结构化追踪(12.1–12.3):
slog结构化日志 + OpenTelemetry 链路追踪 + Context 成本熔断;Metrics 层建议通过 Prometheus 补齐。 - 验证回环(12.5):Agent Loop 外层包裹 Grader,编译不过、测试不过的代码无法直接交付。
- Eval 管线(12.6):结果断言与轨迹断言双轨,为 Agent 建立自动化天梯榜。
- 爬坡优化(12.7):从生产 Trace 提取失败模式,生成配置调优建议(启发式半自动,而不是严格 Hill Climbing)。
循环 3(事件驱动后台常驻)在第十三章展开,它让 Agent 从“人工启动的工具”进化为“无人值守的服务”。
至此,Agent 已具备工业级生产所需的可观测性、验证能力与评估管线,并可在运行过程中持续改进。
第十三章将把前文的代码模块组装为独立的 main.go;在终端执行 go-coder run 后,Agent 即可按配置启动运行。