主题
第 6 章:状态机与循环机制实现
:::
阅读建议:如果时间有限,聚焦状态枚举与转移规则和崩溃恢复与 Checkpoint 两个主题,即可把握状态机全貌;Jaccard 相似度算法、JSONL 持久化等工程细节适合实装时回读。
:::
在前几章的源码解构中,我们得出了一个明确的工程结论:简单场景多用递归实现 Agent,工业级产品采用状态机实现 Agent。
从系统分层的角度来看,Agent 的运行机制可以被划分为两层循环:
- 推理循环:单次 LLM API 调用内部的“输入 → 推理 → 输出”过程,这一层完全由模型权重决定,工程代码无法介入。
- 编排循环:工程代码驱动的多轮流转,调用 LLM、解析 tool_calls、执行工具、将结果注回上下文、判断是否继续。状态追踪、异常熔断、HITL 审批均在此层实现。
本章构建的状态机就是这个编排循环引擎。我们写代码(如 go-coder)不是为了替代大模型的推理,而是为了管理每轮推理之间的状态流转,触发、暂停、验证和重试。更高层的事件驱动调度(何时启动一次完整的编排循环)将在第十二、十三章展开。
状态机的形式化定义
有限状态机可以用三元组 $(S, E, \delta)$ 描述:状态集合 $S$、事件集合 $E$、转移函数 $\delta: S \times E \to S$。本书的 AgentState 枚举就是 $S$ 的实例,StateThinking、StateExecuting 等六个状态覆盖 Agent 生命周期;RunLoop 各阶段产生的事件(无 tool call、Token 触顶、工具返回)驱动 $\delta$ 在状态间跳转。Guard (守卫条件)进一步约束转移:例如 THINKING → EXECUTING 要求 len(resp.ToolCalls) > 0,THINKING → COMPACTING 要求 Token 逼近红线,分支逻辑因此收敛到一张可审计的转移表,而不是散落在递归 return 里。
当 Agent 需要连续执行几十次“思考-行动-观察”的循环时,如果使用递归调用(即自己调用自己),哪怕内存没有爆栈,一旦遇到中断或者外部事件注入(如用户打断),整个函数调用栈将难以恢复。Call Stack 绑在进程上,挂起 30 分钟等待审批时,它不会替你保存 continuation。
递归 vs 状态机:为何 Call Stack 无法 cheap resume
递归实现的 Agent,每一轮 ReAct 循环对应一次函数调用帧。帧里保存着局部变量、返回地址、闭包捕获,这些都是瞬态的、与进程地址空间绑定的。当用户按下 Ctrl+C、进程被 OOM Killer 干掉、或者你需要把 Agent 挂起 30 分钟等待人类审批时,整个调用栈要么被销毁,要么被阻塞在深层 select 里,没有任何标准机制能把“第 17 轮思考到一半”这个 continuation 序列化到磁盘并在另一台机器上恢复。
此外,checkpoint 成本也不容忽视:递归方案若要支持断点续跑,必须在每个递归入口/出口手动保存完整调用上下文,等价于自己实现一套协程(Coroutine)。Go 的 goroutine 虽然轻量,但 goroutine 的栈同样无法直接 json.Marshal;context.Context 只能传递取消信号,不能保存“执行到哪一步”。状态机 + 显式 AgentContext 的做法,其实就是把 continuation 从隐式的 call stack 提升为显式的堆对象:CurrentState 告诉你“现在处于哪个阶段”,Messages 告诉你“历史是什么”,TurnCount 告诉你“跑到第几轮”,恢复时只需反序列化这个 struct,从 RunLoop 的 for 循环顶部重新进入,状态机自然知道该走哪条边。
协程/事件循环能 cheap resume 的核心机制是 continuation 外置:执行状态不藏在栈帧里,而落在一个可持久化、可共享、可观测的数据结构中。for 循环每迭代一次只是变量的重新赋值,没有栈帧的创建与销毁,Turn 100 和 Turn 1 的内存 footprint 几乎相同。这就是为什么 Pi、Claude Code、LangGraph 不约而同地选择了“显式状态 + 循环驱动”而不是“递归调用 LLM”,不是 Go 或 Python 的语言限制,而是可恢复性、可审计性、可并发性这三重工程约束的必然推论。
下面将超越简单的 Prompt 拼接模式,直接使用 Go 语言从零实现一个具备高并发、可挂起、可阻断的工业级 ReAct(Reason + Act) 状态机:每轮先推理(Reason),再调用工具执行(Act),将环境反馈作为 Observation 注回上下文,形成闭环。
ReAct 的核心机制:Thought → Action → Observation 三角闭环
ReAct 论文提出的不是简单的“先想后做”,而是一个闭环控制论系统:模型在每一轮生成 Thought (内部推理轨迹,通常以自然语言呈现),基于 Thought 做出 Action (对外部世界的操作,如调用搜索 API、读写文件),环境返回 Observation (Action 的执行结果),Observation 被追加到上下文后驱动下一轮 Thought。三角闭环的关键在于:Observation 不是模型凭空想象的,而是来自真实世界的反馈,文件不存在就是不存在,编译报错就是报错,搜索结果为空就是空。
在本书的 RunLoop 映射中,这个三角闭环有精确的代码对应:StateThinking 阶段 LLM 返回的 AssistantMessage 携带 Thought (文本内容)和 Action (ToolCalls 数组);StateExecuting 阶段 ExecuteBatch 产生 Observation,以 role: “tool” 的消息追加到 Messages;下一轮 StateThinking 时,模型读取完整的 Thought-Action-Observation 历史,形成新的 Thought。整个 Messages 数组就是 ReAct 轨迹的可序列化、可回放、可审计的外部记忆。
与纯 Chain-of-Thought (CoT)的本质区别在于:CoT 只有 Thought,没有 Action 和 Observation。CoT 让模型“在脑子里把题做完”,对于需要查数据库、读文件、调用 API 的任务,CoT 只能幻觉出不存在的数据。ReAct 则把推理锚定在可验证的外部反馈上:当 Observation 与 Thought 中的预期矛盾时(“我以为文件存在,但 cat 返回 File not found”),模型在下一轮 Thought 中必须 reconcile 这个矛盾,要么修正假设,要么换策略,要么向用户报告 blocker。没有 Observation 的 CoT 可以在错误假设上无限推理下去;有 Observation 的 ReAct 在错误假设上最多浪费一轮 Action 的成本。
6.1 核心数据结构设计
在构建工业级 Agent 引擎时,我们绝不能像写 Demo 脚本那样,把所有的变量、计数器、对话历史随意散落在各个函数中。我们需要一个极其严谨的、类似于“操作系统线程控制块(TCB)”的数据结构,将单次任务执行中所有的状态统一包裹起来。我们将它命名为 AgentContext。
注意区分:它不是 Go 标准库的 context.Context(那是用来控制超时和级联取消的),而是用于持久化、状态流转和挂起恢复的业务级上下文。
6.1.1 结构体组成
为了确保状态机的健壮性,AgentContext 被严格划分为四个区域。
go
type AgentContext struct {
    // ===== 基础身份 =====
    SessionID string
    CreatedAt time.Time

    // ===== 对话历史(Append-Only)=====
    Messages []Message

    // ===== 状态机核心指标 =====
    TurnCount        int
    MaxTurns         int
    ConsecutiveFails int        // 连续工具报错次数(熔断器指标)
    CurrentState     AgentState
    Transition       Transition // 记录每一轮的退出原因

    // ===== Token 经济学 =====
    TokensUsed       int64 // 累计消耗的 Token 数
    MaxContextTokens int   // 模型上下文窗口极限(如 128000)
    BufferTokens     int   // 安全缓冲区(如 13000)

    // ===== 输出触顶恢复 =====
    OutputTruncated    bool // 上一轮是否因 max_output_tokens 被截断
    EscalationAttempts int  // 已尝试的输出恢复次数

    // ===== 并发保护 =====
    mu sync.RWMutex `json:"-"`
}
Append-Only Messages 的设计原理
Messages 采用 append-only 语义,历史只增不改、只追加不原地修改,这不是懒惰,而是三层工程约束的交汇点。第一层是 audit/replay:ReAct 轨迹的每一轮 Thought-Action-Observation 都有严格的时间序,若允许原地修改历史,就无法回答“模型在第 7 轮到底看到了什么”这类调试问题;append-only 让轨迹成为天然的 event log,可观测性章节的 Tracing 可以直接对齐。第二层是 prompt caching:主流 模型供应商(Anthropic、OpenAI)对 prompt 前缀做 hash 缓存,前缀不变则 cache hit,按折扣价计费;append-only 保证每次 LLM 调用时,旧消息的 prefix hash 稳定,只有尾部新增部分需要重新计算。第三层是并发读写:主循环 append 新消息的同时,后台流式输出或 HITL 模块可能并发读取历史;append-only + 快照副本避免了读-写-改的竞争窗口。
与 compaction (记忆压缩章节)的“删除/替换旧消息”看似矛盾,实则通过版本化快照解决:compaction 不是原地删除 Messages[i],而是生成一条新的 summary 消息替换一段旧区间的逻辑视图,物理上可以是 append 一条 role: “system” 的压缩摘要,然后标记旧消息为 archived 或在发送给 LLM 前过滤掉。这样 audit log 仍保留完整原始轨迹(用于合规回放),而 LLM 看到的 effective context 是压缩后的视图。Append-only 管的是存储语义,compaction 管的是视图语义,两者正交,不冲突。
6.1.2 字段设计解析
为什么需要 TokensUsed 和 MaxContextTokens?
在前文解构 Claude Code 时我们看到,其 AutoCompact 会在 Token 逼近 effectiveContextWindow - 13000 时触发。我们的 AgentContext 必须内置这套“油量表”,每次 LLM 返回时累加 usage.total_tokens,在每轮循环起点检查是否触碰红线。
13000 这个数字如何推导?
BufferTokens = 13000 是为输出 completion、并发工具 Observation 和 compaction 摘要调用预留的安全余量,Claude Code 在 max_output 8192、典型 tool result 4K、计数偏差与摘要开销叠加后取了一个偏保守的下界。具体数值会随模型 max_output 和工具箱体量调整,不必机械照搬。
触发条件 TokensUsed >= MaxContextTokens - BufferTokens 的含义是:在还有空间完成 compaction 调用之前主动转入 StateCompacting。宁可早一点瘦身,也不等到 413 Payload Too Large 才被动发现溢出,紧急压缩路径(handleAPIError)存在,但每次 413 都是一次失败的 API 调用和额外 latency。
为什么需要 OutputTruncated?
当大模型的单次回复触碰了输出 Token 上限(如 8K 或 64K),API 会返回 finish_reason: “length” 而不是 “stop”。此时模型的回复是不完整的,它可能正在写一段代码,写到一半就被截断了。如果不处理,大模型下一轮会道歉并重新开始,浪费大量 Token。Claude Code 的做法是注入一条隐藏提示:“Output token limit hit. Resume directly — no apology...”。我们在 Go 中同样需要这个恢复机制。
finish_reason 与状态机语义
LLM API 返回的 finish_reason 是 provider 对“模型为何停止生成”的机器可读声明,直接驱动 RunLoop 的分支逻辑,如表 6-1 所示。
表 6-1 finish_reason 与状态机映射
| finish_reason | 语义 | 状态机影响 |
|---|---|---|
stop | 模型自然结束(遇到 stop sequence 或认为话说完了) | 正常路径:检查 tool_calls,无则 → FINISHED |
length | 输出 Token 触顶被截断 | 设置 OutputTruncated=true,跳过工具执行,注入续写提示后 continue |
tool_calls | 模型主动发起工具调用(OpenAI 格式) | 正常路径:→ EXECUTING |
content_filter | 内容被安全过滤器拦截 | 应 → ERROR 或注入降级提示;当前实现需补充此分支 |
stop vs length 的分野至关重要:两者都可能伴随 tool_calls 字段,但 length 意味着 tool call JSON 可能不完整,若盲目执行截断的 tool call,会得到 malformed 参数错误。RunLoop 在 length 时 continue 跳过工具执行,这就是这个 Guard 的体现。content_filter 在 production Agent 中不可忽略,它意味着模型输出被截断且无法通过续写恢复,需要向用户报告,而不是 silent retry。
为什么需要 mu sync.RWMutex?
因为在我们的设计中,大模型可能通过流式一边在输出内容,后台的工具执行器同时在往 Messages 数组里追加执行结果。如果不加锁,Go 经典的并发写入会导致 panic: concurrent map/slice write。
6.1.3 状态枚举与流转规则
go
type AgentState string
const (
    StateThinking    AgentState = "THINKING"
    StateExecuting   AgentState = "EXECUTING"
    StateWaitingHITL AgentState = "WAITING_HITL"
    StateCompacting  AgentState = "COMPACTING"
    StateFinished    AgentState = "FINISHED"
    StateError       AgentState = "ERROR"
)

type Transition struct {
    Reason string // 如 "Completed", "Max_Turns", "Context_Canceled", "Loop_Deadlock"
    Detail string
}

var ErrMaxTurns = errors.New("agent reached max turns, forced stop")
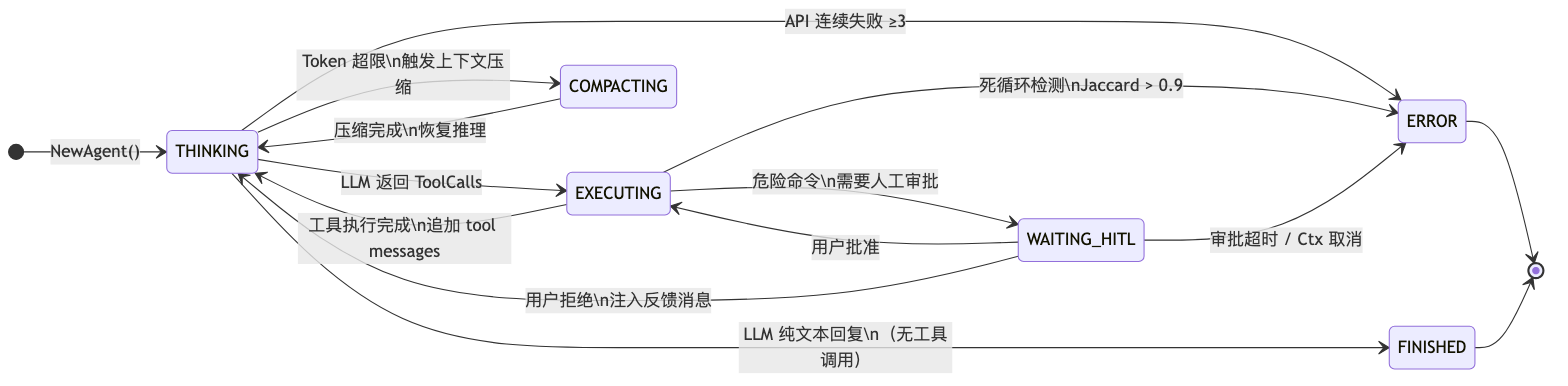
合法的状态流转路径如下:
THINKING → EXECUTING      (模型决定调用工具)
THINKING → FINISHED       (模型决定停止,无工具调用)
THINKING → COMPACTING     (Token 红线触发)
THINKING → ERROR          (API 调用失败且无法恢复)
EXECUTING → THINKING      (工具执行完毕,回到思考)
EXECUTING → WAITING_HITL  (工具需要人类授权)
WAITING_HITL → EXECUTING  (人类批准,继续执行)
WAITING_HITL → THINKING   (人类拒绝,错误反馈给模型)
COMPACTING → THINKING     (压缩完成,继续思考)
任意状态 → ERROR (context.Context 取消)可挂起/可阻断:StateWaitingHITL 的实现预告
状态转移图中出现了 WAITING_HITL 节点,但本章的 RunLoop 尚未实现完整的挂起/唤醒逻辑,checkCircuitBreaker 中虽然将 CurrentState 设为 StateWaitingHITL,却没有 select 等待人类输入的分支。这是刻意的分层:本章交付的是循环驱动与状态转移,后续 HITL 章节才接入 HITL 仲裁器。
挂起的正确位置不在 Tool.Execute 内部。把 RequestApproval 写进工具,看起来解耦了 RunLoop 与权限策略,实则把“能否跨进程恢复”堵死了:goroutine 卡在 select 上时,checkpoint 里没有待批工具列表,IM 网关也无法在下一次 Webhook 里续跑。工业实现是循环级原子暂停:阶段六在 ExecuteBatch 之前调用无阻塞的 Decide,任一工具需要人审,就把整批调用写入 AgentContext.PendingBatch,状态切到 WAITING_HITL,Run 返回 StatusPaused。CLI 用同步适配器把暂停转成终端提问;服务端则落盘等待 Continue(resolutions)。本章的 RunLoop 仍直接 ExecuteBatch,把审批留白;HITL 章节补上 Decide / Paused / Continue 这条可序列化的挂起链。下图展示了 Agent 状态机的完整流转路径,其中 WAITING_HITL 即为挂起态的占位,如图 6-1 所示。
6.1.4 线程安全的消息管理
go
func (ac *AgentContext) AppendMessage(msg Message) {
    ac.mu.Lock()
    defer ac.mu.Unlock()
    ac.Messages = append(ac.Messages, msg)
}

func (ac *AgentContext) GetMessages() []Message {
    ac.mu.RLock()
    defer ac.mu.RUnlock()
    snapshot := make([]Message, len(ac.Messages))
    copy(snapshot, ac.Messages)
    return snapshot
}

func (ac *AgentContext) ReplaceMessages(msgs []Message) {
    ac.mu.Lock()
    defer ac.mu.Unlock()
    ac.Messages = msgs
}

func NewAgentContext(systemPrompt, userPrompt string, maxContext int) *AgentContext {
    return &AgentContext{
        SessionID:        generateUUID(),
        CreatedAt:        time.Now(),
        Messages: []Message{
            {Role: "system", Content: systemPrompt},
            {Role: "user", Content: userPrompt},
        },
        MaxTurns:         30,
        MaxContextTokens: maxContext,
        BufferTokens:     13000,
        CurrentState:     StateThinking,
    }
}
注意 GetMessages() 返回的是快照副本而不是指针。这确保了后台书记员(记忆压缩章节)拿到的历史不会被主循环的并发写入污染,与 Claude Code 中为了缓存友好性而采用的 Immutable 哲学一脉相承。
Prompt Caching 与 Immutable 快照
LLM Prompt Caching 的工作原理是 prefix hash 匹配:模型供应商对 prompt 的前缀段(通常从 system message 到某个稳定分界点)计算 hash,若后续请求的 prefix hash 与缓存条目一致,则 cache hit,cached tokens 按折扣价(Anthropic 约为正常价格的 10%)计费,latency 也显著降低,因为前缀无需重新做 prefill 计算。Cache 的粒度通常是“前缀必须字节级一致”,改一个字符,hash 就变了,整段 prefix 重新计费。
Immutable 哲学(只 append 不 mutate + 读时返回副本)与 prompt caching 形成天然联盟:GetMessages() 返回快照副本,意味着调用方无法意外修改 AgentContext 内部的 Messages slice,每次 Chat() 调用时,旧消息的 prefix 在物理内存中位置不变,provider 侧 hash 稳定。若返回指针或允许原地修改,一次并发写入就可能破坏 prefix 一致性,导致 cache miss 和费用飙升。这不是微优化,长 session 的 Agent 可能累积 100K+ tokens 的历史,cache hit 与 miss 的单次调用成本差距可达 10 倍。
6.2 主循环的构建
下面参考 Claude Code 和 Pi 的核心逻辑,用 Go 中的 for 循环实现状态机的主循环。
首先,定义 Agent 结构体。注意,这里我们严格遵循 DDD 的依赖方向,Agent 只依赖领域层定义的端口接口(domain.LLMPort、domain.ToolExecutor),而不依赖任何具体实现。
go
package agent

import "go-coder/internal/domain"

type Agent struct {
    llm      domain.LLMPort
    tools    domain.ToolExecutor
    memory   domain.MemoryPort
    hitl     domain.HITLArbitrator // HITL 章节实现
    role     string
}

func NewAgent(
    llm domain.LLMPort,
    tools domain.ToolExecutor,
    memory domain.MemoryPort,
    hitl domain.HITLArbitrator,
) *Agent {
    return &Agent{llm: llm, tools: tools, memory: memory, hitl: hitl, role: "default"}
}
DDD 准则:
Agent结构体的每一个字段都是接口而不是结构体指针。它不关心大模型是 OpenAI 还是 Claude,不关心工具箱里有几个工具。这种面向端口编程的方式,让 Agent 天然具备了可测试性,单元测试中注入 Mock 实现即可。
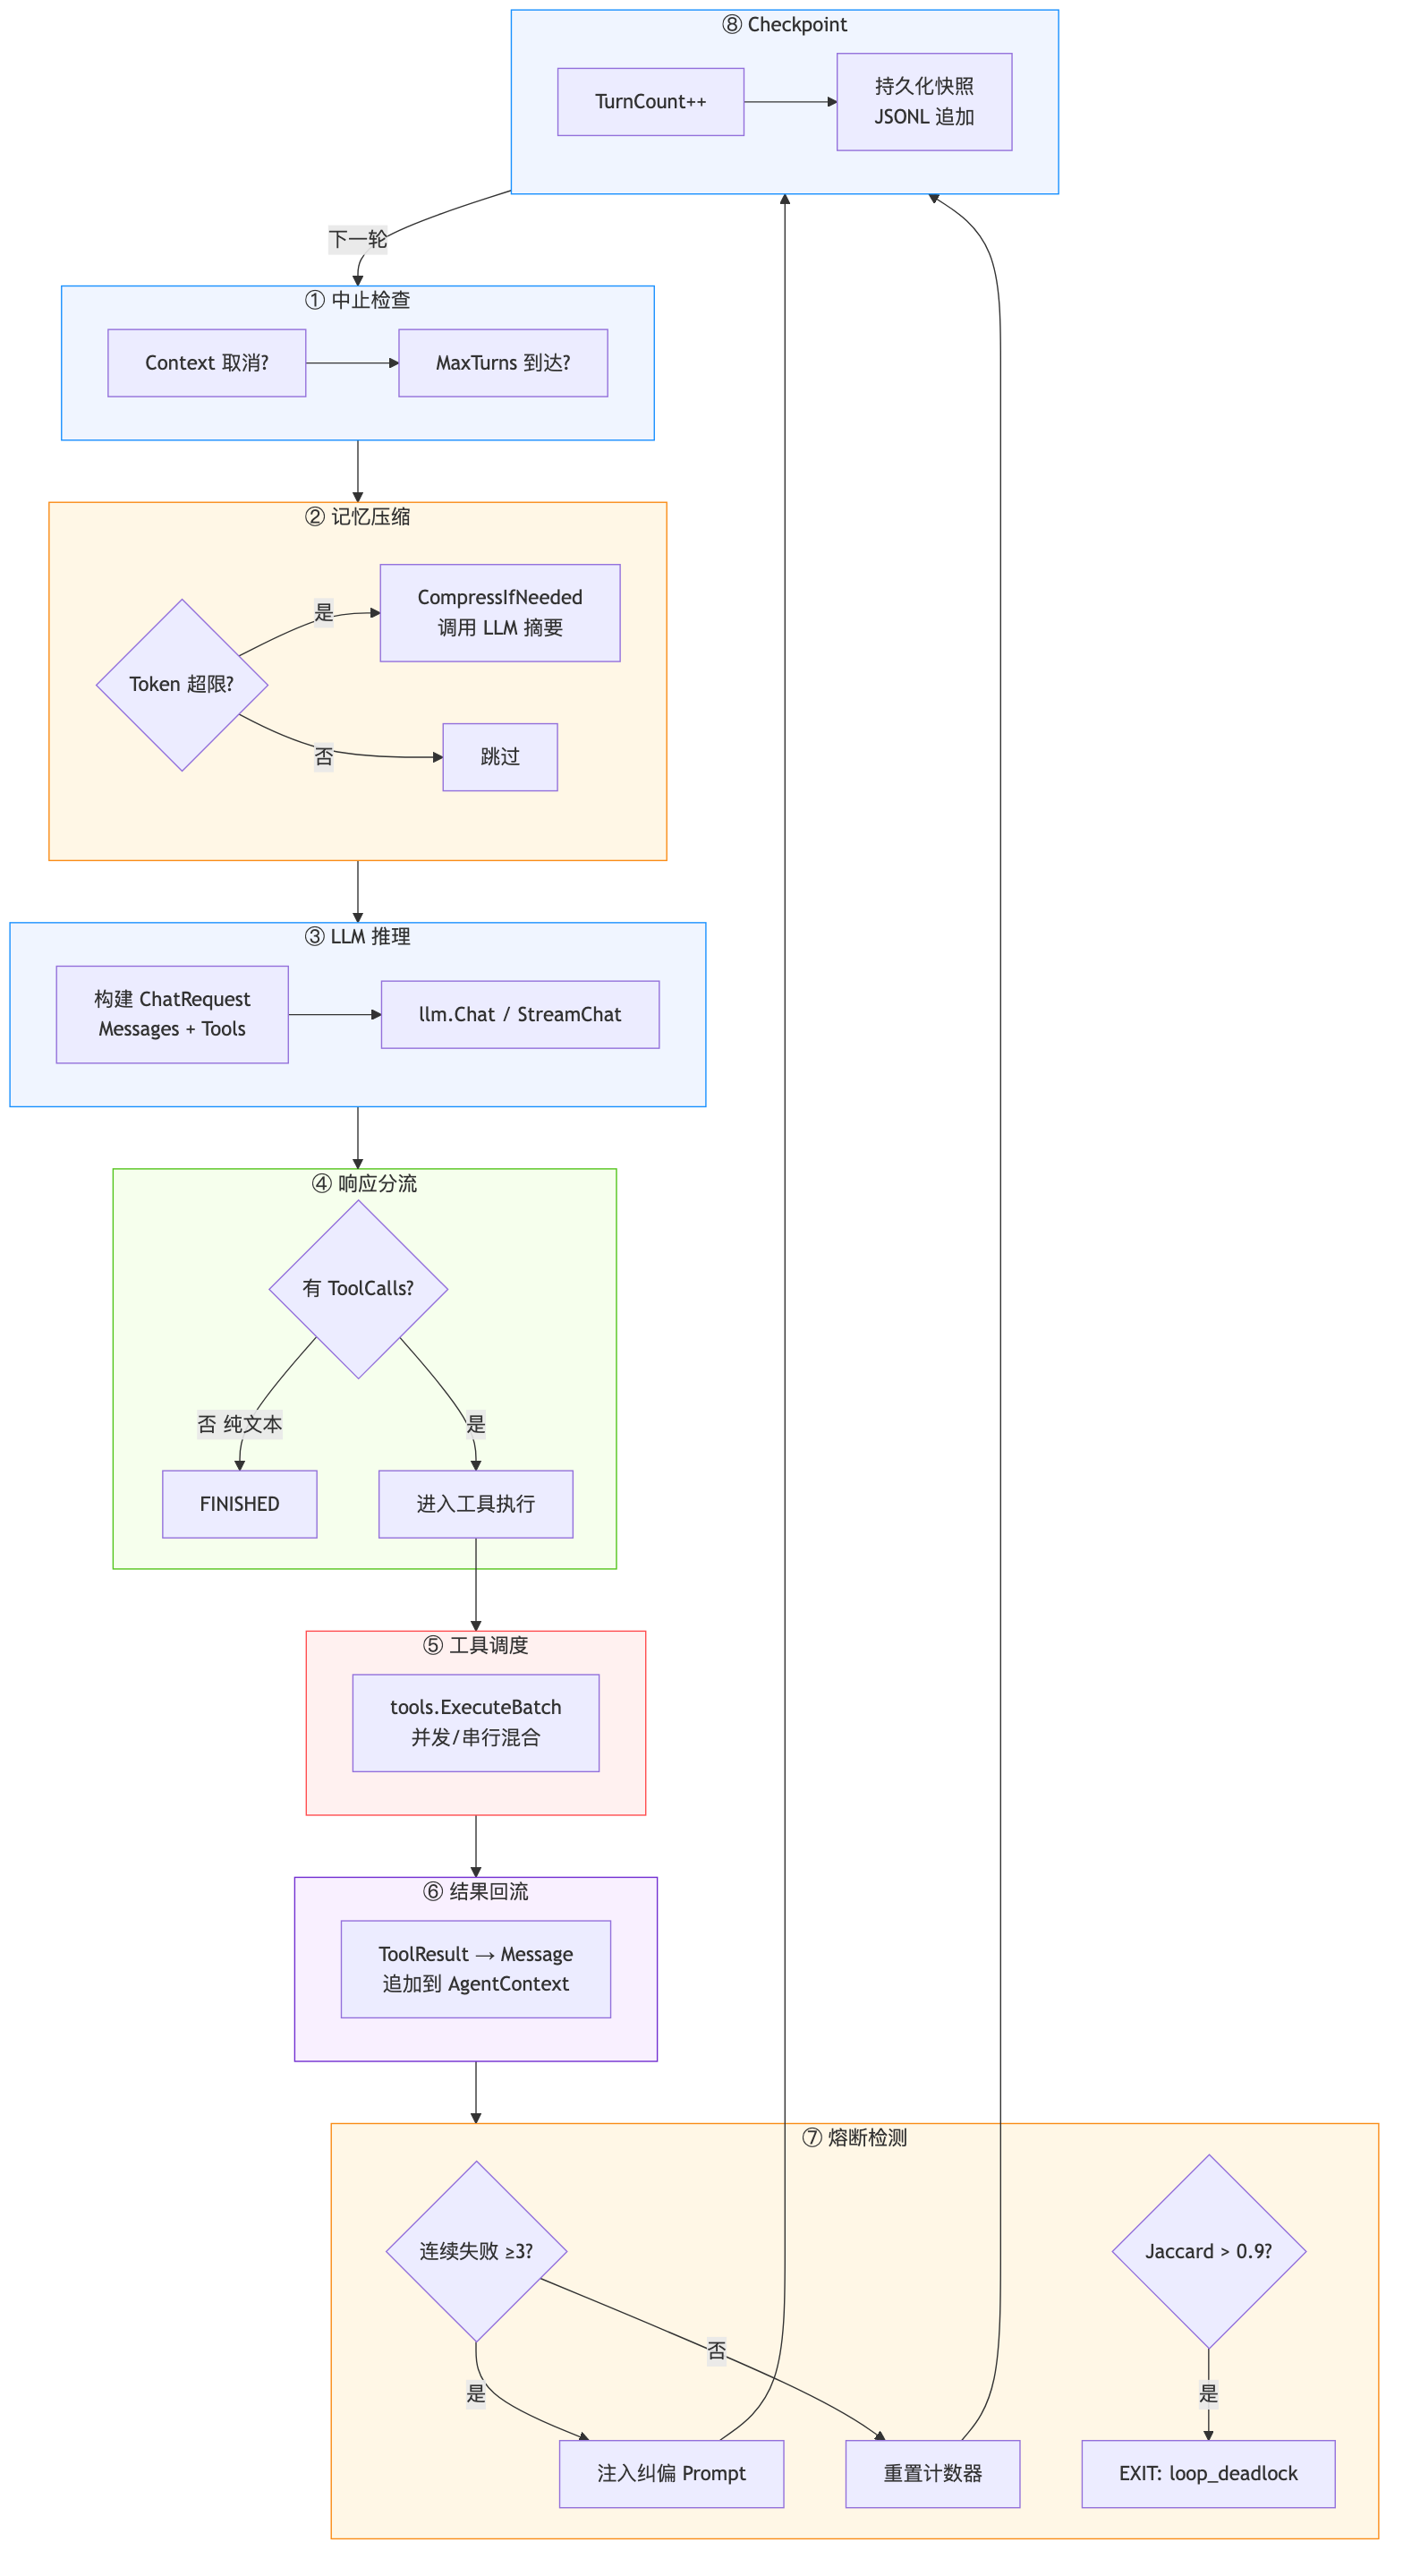
6.2.1 主循环实现
go
func (a *Agent) RunLoop(ctx context.Context, agentCtx *AgentContext) error {
    for {
        // ========== 阶段零:物理中止检查 ==========
        if err := ctx.Err(); err != nil {
            agentCtx.Transition = Transition{Reason: "Context_Canceled", Detail: err.Error()}
            return err
        }

        if agentCtx.TurnCount >= agentCtx.MaxTurns {
            agentCtx.Transition = Transition{Reason: "Max_Turns_Exceeded"}
            return ErrMaxTurns
        }

        // ========== 阶段一:上下文卫生(Context Hygiene) ==========
        agentCtx.CurrentState = StateCompacting
        if err := a.memory.CompressIfNeeded(ctx, agentCtx); err != nil {
            agentCtx.CurrentState = StateError
            return err
        }

        // ========== 阶段二:输出触顶恢复 ==========
        if agentCtx.OutputTruncated {
            a.injectContinuationPrompt(agentCtx)
            agentCtx.OutputTruncated = false
        }

        // ========== 阶段三:调用大模型 ==========
        agentCtx.CurrentState = StateThinking

        resp, err := a.llm.Chat(ctx, domain.ChatRequest{
            Messages: agentCtx.GetMessages(),
            Tools:    a.tools.GetDefinitions(),
        })
        if err != nil {
            if a.handleAPIError(agentCtx, err) {
                continue // 可恢复错误,重试
            }
            agentCtx.CurrentState = StateError
            return err
        }

        agentCtx.TokensUsed += int64(resp.Usage.TotalTokens)
        agentCtx.AppendMessage(resp.AssistantMessage)

        // ========== 阶段四:检查输出是否被截断 ==========
        if resp.FinishReason == "length" {
            agentCtx.OutputTruncated = true
            agentCtx.EscalationAttempts++
            if agentCtx.EscalationAttempts > 3 {
                agentCtx.Transition = Transition{Reason: "Output_Escalation_Failed"}
                return errors.New("output repeatedly truncated, cannot recover")
            }
            agentCtx.TurnCount++
            continue // 跳过工具执行,直接让模型续写
        }
        agentCtx.EscalationAttempts = 0

        // ========== 阶段五:是否需要执行工具? ==========
        if len(resp.ToolCalls) == 0 {
            agentCtx.CurrentState = StateFinished
            agentCtx.Transition = Transition{Reason: "Completed"}
            return nil
        }

        // ========== 阶段六:执行工具 ==========
        agentCtx.CurrentState = StateExecuting
        toolResults := a.tools.ExecuteBatch(ctx, resp.ToolCalls)

        for _, tr := range toolResults {
            agentCtx.AppendMessage(domain.Message{
                Role:       "tool",
                Content:    tr.Output,
                ToolCallID: tr.ToolCallID,
                IsError:    tr.IsError,
            })
        }

        // ========== 阶段七:熔断检测 ==========
        a.checkCircuitBreaker(agentCtx, toolResults)

        if detectLoopDeath(agentCtx.GetMessages()) {
            agentCtx.Transition = Transition{Reason: "Loop_Deadlock"}
            return ErrLoopDeadlock
        }

        // ========== 阶段八:状态推进 ==========
        agentCtx.TurnCount++
        agentCtx.Transition = Transition{Reason: "Next_Turn"}

        // AgentContext 持久化自身状态(崩溃恢复)
        if err := agentCtx.PersistCheckpoint(); err != nil {
            log.Printf("WARN: checkpoint persistence failed: %v", err)
        }
    }
}
本章 RunLoop 在阶段六仍直接 ExecuteBatch。第九章会在此之前插入无阻塞的 Decide:需要人审则写入 PendingBatch 并返回 Paused,由 Continue 再执行。这样第六章可以把循环讲完整,又不把审批协议提前摊开。
上下文卫生(Context Hygiene)的完整含义
“Context Hygiene”不是 compaction 的同义词,而是每次 LLM 调用前的上下文预处理流水线,目标是让送入模型的 messages 干净、合规、不溢出。其核心是 Token 预算检查与 compaction (本章 CompressIfNeeded),但不止于此:还要 Dedup 合并重复的 tool result、Strip 剥离无关元数据、修复 role 顺序以满足 provider 格式约束。
本章 RunLoop 在循环开头只实现了 compaction 入口;去重、剥离与 role 修复在记忆压缩章节的 CompressIfNeeded 和书记员模块中展开。Hygiene 的设计哲学是:脏 context 比空 context 更危险,溢出可以压缩,重复或错位的消息却会让模型产生系统性幻觉。RunLoop 主循环各阶段的完整流程,如图 6-2 所示。
6.2.2 健壮性设计要点
每轮结束时 RunLoop 调用 agentCtx.PersistCheckpoint() 将状态写入磁盘(详见 6.7 节),进程崩溃重启后反序列化即可续跑。外层 context.Context 提供全局阻断:用户按 Ctrl+C 或超时到达时,所有网络请求与循环步进一并终止。阶段零是前置守卫(物理中止与轮次上限),阶段一至八是核心处理管道,合计九步的划分使得任何一轮的行为都能通过 Transition.Reason 回溯。
6.3 规划器接口与循环解耦
上一节的 RunLoop 把 ReAct 行为硬编码在主循环里:模型返回 tool_calls 就执行,没有就结束。这对“思考-行动-观察”的基本循环已经足够,但忽略了一个日益重要的工程维度,规划(Planning)策略的可替换性。
随着“原生会思考”的模型(如 Claude extended thinking、OpenAI o-series reasoning)出现,规划不再只有 ReAct 提示词一种范式。至少存在两条技术路线:
- 提示词规划:在 LLM 请求前注入结构化标记(如
[PLANNING][ACTION][REASONING][FINAL_ANSWER]),要求模型先输出规划再执行动作。好处是对任意模型通用,代价是额外的 Token 开销和 prompt 工程维护成本。 - 原生思考:利用模型内置的推理能力(通过
thinking参数或reasoning_effort字段启用),规划发生在模型内部,外部只需设置开关。好处是零 prompt 维护、推理质量更高,代价是绑定特定模型能力。
这两种策略如果直接写死在 RunLoop 里,切换时就要改主循环代码,违反开闭原则。更稳妥的做法是将规划逻辑抽象为一个可插拔的接口:
go
type Planner interface {
    BuildPlanningInstruction(
        ctx context.Context,
        agentCtx *AgentContext,
        req *domain.ChatRequest,
    ) string

    ProcessPlanningResponse(
        ctx context.Context,
        agentCtx *AgentContext,
        resp *domain.ChatResponse,
    ) *domain.ChatResponse
}
BuildPlanningInstruction 在 LLM 调用前执行,返回的规划指令追加到请求的 系统提示词 尾部;ProcessPlanningResponse 在 LLM 返回后执行,负责从模型输出中提取结构化的规划/行动/推理结果,过滤掉不应进入对话历史的标记文本。
ReAct 实现只需几十行:
go
type ReActPlanner struct{}

func (p *ReActPlanner) BuildPlanningInstruction(_ context.Context, _ *AgentContext, _ *domain.ChatRequest) string {
    return `Before each action, output your plan in this format:
[PLANNING] What is the current goal and what information do I have?
[REASONING] What approach should I take and why?
[ACTION] The specific tool call to make.
After all actions are complete, output [FINAL_ANSWER] followed by the result.`
}

func (p *ReActPlanner) ProcessPlanningResponse(_ context.Context, _ *AgentContext, resp *domain.ChatResponse) *domain.ChatResponse {
    if len(resp.ToolCalls) == 0 && !strings.Contains(resp.AssistantMessage.Content, "[FINAL_ANSWER]") {
        resp.ToolCalls = nil // 模型只输出了规划意图但未调用工具,不视为终止
    }
    return resp
}原生思考实现更简单,BuildPlanningInstruction 返回空字符串(不注入额外指令),但在构建请求时设置 ThinkingEnabled: true。此处对 §5.1 的 ChatRequest 做了扩展,新增 ThinkingEnabled 和 ReasoningEffort 两个字段以支持扩展思考模式:
go
type BuiltinPlanner struct {
    ReasoningEffort string // "low" / "medium" / "high"
}

func (p *BuiltinPlanner) BuildPlanningInstruction(_ context.Context, _ *AgentContext, req *domain.ChatRequest) string {
    req.ThinkingEnabled = true
    req.ReasoningEffort = p.ReasoningEffort
    return ""
}

func (p *BuiltinPlanner) ProcessPlanningResponse(_ context.Context, _ *AgentContext, resp *domain.ChatResponse) *domain.ChatResponse {
    return resp // 原生思考不需要后处理
}
RunLoop 中的嵌入点只需两行:在阶段三(调用大模型)前后各插入一个 Planner 调用。Agent 构造时注入 Planner 实例,不传则跳过(保持原有行为):
go
// 阶段三之前
if a.planner != nil {
    instruction := a.planner.BuildPlanningInstruction(ctx, agentCtx, &req)
    if instruction != "" {
        req.Messages = append(req.Messages, domain.Message{Role: "system", Content: instruction})
    }
}

// 阶段四之前
if a.planner != nil {
    resp = a.planner.ProcessPlanningResponse(ctx, agentCtx, resp)
}
这一设计的投入很小(一个接口、两个实现、循环中两行调用),但为系统打开了策略维度:不同任务类型可以使用不同的规划策略,简单的文件编辑走原生思考(低 Token 开销),复杂的跨模块重构走 ReAct 显式规划(可审计的推理链)。在可观测性章节的 Eval 中,切换 Planner 也是评测模型规划能力的自然手段。
6.4 输出阈值与断点续写
当 API 返回 finish_reason: “length” 时,模型的输出被强行截断。如果不处理,大模型会在下一轮道歉并重新输出,白白浪费几千个 Token。
Claude Code 采用如下做法:注入一条对用户不可见的系统提示词,命令模型直接从断点续写。
go
func (a *Agent) injectContinuationPrompt(agentCtx *AgentContext) {
    agentCtx.AppendMessage(domain.Message{
        Role: "user",
        Content: "[SYSTEM] Your previous output was truncated due to token limit. " +
            "Continue EXACTLY where you left off. Do NOT apologize, do NOT repeat " +
            "what was already said. Resume mid-sentence if necessary.",
    })
}
配合主循环中的 EscalationAttempts 计数器,系统最多允许 3 次续写尝试。如果模型反复被截断(说明它在生成超长内容),第 4 次会触发 Output_Escalation_Failed 退出,避免无限烧钱。
续写注入的 Attention 机制与 “3 次” 阈值
Hidden user message (role: “user” 的续写指令)能改变模型续写行为,根源在于 Transformer 的 causal attention:模型生成下一个 token 时,attend 到的是完整的 messages 序列,包括刚被截断的 assistant 输出和紧随其后的 user 指令。续写指令在 attention 矩阵中位于截断内容之后、新 generation 之前,等价于一个强约束的 soft prompt:“你的上一个 token 的上下文在这里,不要回溯,继续向前”。
若用 role: “system” 注入,部分 provider 的 system message 只在首位有效或权重被稀释;用 role: “user” 则保证指令出现在紧邻生成点的位置,attention 权重最高。Claude Code 选择 hidden user message 而不是 system override,就是这一 attention 可见性原理的工程化。
“3 次”不是理论最优值,而是 cost-risk tradeoff 的经验阈值:单次截断续写通常 1 次即可恢复(模型从断点继续);2 次覆盖“截断发生在 tool call JSON 中间”的边界情况;第 3 次是最后的 retry budget。超过 3 次仍被截断,说明模型在生成结构性超长内容(如一次性输出整个代码库),继续续写只会线性烧钱而无法收敛,此时 Output_Escalation_Failed 强制退出,将问题暴露给用户或触发 task decomposition (拆分子任务)。Claude Code 源码中同样采用 3 作为 escalation ceiling,这是 production Agent 的 industry convention,而不是数学推导。
6.5 接口错误分级处理
大模型 API 会返回多种错误,不能一刀切地 return err。我们需要按严重程度分级处理:
go
func (a *Agent) handleAPIError(agentCtx *AgentContext, err error) bool {
    var apiErr *APIError
    if !errors.As(err, &apiErr) {
        return false // 非 API 错误,不可恢复
    }

    switch {
    case apiErr.StatusCode == 429: // Rate Limit
        agentCtx.Transition = Transition{Reason: "Rate_Limited", Detail: apiErr.Message}
        time.Sleep(retryBackoff(agentCtx.TurnCount))
        return true // 可恢复,重试

    case apiErr.StatusCode == 413: // Payload Too Large
        agentCtx.Transition = Transition{Reason: "Context_Overflow"}
        // 紧急压缩:调用 memory.ForceCompact 强制摘要
        _ = a.memory.ForceCompact(context.Background(), agentCtx)
        return true // 压缩后重试

    case apiErr.StatusCode == 529: // Overloaded
        agentCtx.Transition = Transition{Reason: "Provider_Overloaded"}
        time.Sleep(30 * time.Second)
        return true

    case apiErr.StatusCode >= 500: // 服务端错误
        agentCtx.ConsecutiveFails++
        if agentCtx.ConsecutiveFails >= 3 {
            return false // 连续 3 次服务端错误,放弃
        }
        time.Sleep(retryBackoff(agentCtx.TurnCount))
        return true

    default:
        return false // 其他错误(如 401 鉴权失败),不可恢复
    }
}

func retryBackoff(attempt int) time.Duration {
    base := time.Duration(1<<min(attempt, 5)) * time.Second // 1s, 2s, 4s, 8s, 16s, 32s
    jitter := time.Duration(rand.Intn(1000)) * time.Millisecond
    return base + jitter
}
注意 retryBackoff 使用了指数退避 + 随机抖动,这是防止多个客户端同时重试导致“惊群效应”的工业标准做法。
指数退避 + Jitter 的数学原理
retryBackoff 的核心公式是 $delay = base \times 2^{attempt} + jitter$,其中 base = 1s,attempt 被 cap 到 5 (最大 32s)。指数项 $2^{attempt}$ 的含义是:每次重试等待时间翻倍,1s → 2s → 4s → 8s → 16s → 32s。从而使请求压力逐级递减:provider 过载时,客户端主动降速,给服务端恢复窗口;同时 cap 到 32s 防止无限等待导致 Agent 假死。
Jitter 是在指数 delay 上叠加 [0, 1000ms) 的均匀随机偏移。若无 jitter,100 个 Agent 实例同时收到 429,会在完全相同的时间点(如 t+4s)发起重试,形成惊群效应:刚恢复的 provider 迅速再次达到上限。Jitter 把重试时间点打散到 [4s, 5s) 的窗口内,请求在时间轴上均匀分布,provider 负载曲线平滑。AWS 的 Exponential Backoff And Jitter 论文推荐 “Full Jitter”($random(0,; base \times 2^{attempt})$)作为最优策略;本书实现的是 “Equal Jitter” 变体($base \times 2^{attempt} + random(0,; 1s)$),保留了最小等待下限,对 latency-sensitive 的 Agent 场景更友好。
6.6 循环防护:熔断与轨迹检测
Agent 在循环执行中可能陷入两类无效循环:工具连续报错却反复重试同一操作(Action 层重复),或模型输出高度相似的无效内容却不触发报错(Thought 层重复)。前者由熔断器拦截,后者由轨迹相似度检测捕获,二者互补构成完整的循环防护网。
大模型有一种常见的“重复犯错”现象:它在同一个错误上反复尝试相同的修复方案。 比如:它调用了 cat no_exist_file.txt,系统返回 File not found。它说“我再试一次”,然后又调用了相同的命令。如果没有拦截,API 账单会在十分钟内消耗殆尽。此时需要 熔断器(Circuit Breaker) 在连续失败达到阈值时介入,阻止 Agent 无限重试。
经典熔断器三态与本书的简化实现
经典 Circuit Breaker (Michael Nygard, Release It!)有三个状态:Closed (正常通行,失败计数累积)、Open (失败率超阈值,所有请求直接拒绝,fast fail)、Half-Open (冷却期后放行少量探测请求,成功则 Closed,失败则回到 Open)。状态转移由滑动窗口内的失败率驱动,不是简单的连续计数,而是 failures / (failures + successes) 在窗口 T 内的比值。
本书 checkCircuitBreaker 是有意简化的变体:用 ConsecutiveFails 连续失败计数替代失败率窗口,触发动作不是 hard reject 而是 prompt injection (向 messages 追加 system alert,命令模型换策略)。简化的原因有三:(1) Agent 场景的失败模式是“模型重复犯同一个错”而不是“下游服务整体不可用”,连续计数比失败率更能捕捉这种语义 (2) hard reject (Open 态直接 return error)会中断用户体验,prompt injection 让模型有机会自我纠正,产品侧表现为“Agent 收到了警告但仍在工作” (3) 完整的 Half-Open 探测需要额外的并发控制和时间窗口状态,对于单 session 的 Agent 来说 overkill,HITL 章节会在需要 hard stop 时接管。
6.6.1 连续错误熔断机制
大模型在遇到工具调用失败时,倾向于用同一策略反复重试,形成“修改→报错→修改为原样→报错”的死循环。checkCircuitBreaker 在每轮工具执行后统计连续失败次数:一旦达到阈值(默认 3 次),状态机直接跃迁至 StateWaitingHITL,同时注入一条系统提示强制模型更换策略,将控制权交还给人类。连续成功则重置计数器,确保偶发失败不会误触熔断。
go
func (a *Agent) checkCircuitBreaker(agentCtx *AgentContext, results []domain.ToolResult) {
    hasError := false
    for _, res := range results {
        if res.IsError {
            hasError = true
            break
        }
    }

    if hasError {
        agentCtx.ConsecutiveFails++
        if agentCtx.ConsecutiveFails >= 3 {
            agentCtx.CurrentState = StateWaitingHITL
            agentCtx.AppendMessage(domain.Message{
                Role: "system",
                Content: "SYSTEM ALERT: You have failed 3 consecutive tool calls. " +
                    "STOP attempting the same approach. Take a completely different strategy. " +
                    "If you cannot proceed, explain the blocker to the user.",
            })
        }
    } else {
        agentCtx.ConsecutiveFails = 0
    }
}
6.6.2 轨迹相似度检测
比“不断报错”更可怕的是“不断输出相同的无效内容”。我们使用 Jaccard 相似度对最近 3 条 Assistant 消息进行比对:
Jaccard 相似度的定义与阈值选择
Jaccard 相似度衡量两个集合的重叠程度:$J(A, B) = |A \cap B| / |A \cup B|$,取值范围 $[0, 1]$。实现中将文本按字符切分为相邻字符对(bigram)集合(bigrams),例如 “abc” 产生 {ab, bc}。Jaccard = 1.0 表示 bigram 集合完全相同,Jaccard = 0 表示无共同 bigram。
阈值 0.90 的选择基于 precision-recall tradeoff:过低(如 0.70)会把“正常迭代中措辞相似的回复”误判为死循环,模型在第 N 轮说“让我检查一下文件”和第 N+1 轮说“让我再检查一下文件”可能 Jaccard > 0.70 但仍是有效推理;过高(如 0.98)则只捕获几乎逐字复制的循环,漏掉“换了几个词但策略完全相同”的语义死循环。0.90 意味着 90% 的 bigram 重叠,在 Agent 场景下,连续两轮达到 0.90 几乎不可能是正常推理的巧合。
Bigram 粒度相比词级切分对代码块微调更敏感,例如 func foo() { return 1 } 与 func foo() { return 2 } 之间的 bigram 重叠率远高于词级重叠率,因为字符对级别的共享序列(fu, un, nc, c(, ...)大量重合。这使得 bigram Jaccard 在自然语言和代码混合场景下都能有效检测同义反复,它零外部依赖、O(n) 复杂度,是 Agent 死循环检测的高效首选方案。
go
func detectLoopDeath(messages []domain.Message) bool {
    var recentTexts []string
    for i := len(messages) - 1; i >= 0 && len(recentTexts) < 3; i-- {
        if messages[i].Role == "assistant" && messages[i].Content != "" {
            recentTexts = append(recentTexts, messages[i].Content)
        }
    }
    if len(recentTexts) < 3 {
        return false
    }
    return jaccardSimilarity(recentTexts[0], recentTexts[1]) > 0.90 &&
        jaccardSimilarity(recentTexts[1], recentTexts[2]) > 0.90
}

// jaccardSimilarity 基于 bigram 的简易文本相似度
func jaccardSimilarity(a, b string) float64 {
    setA := bigrams(a)
    setB := bigrams(b)
    if len(setA) == 0 || len(setB) == 0 {
        return 0
    }
    intersection := 0
    for k := range setA {
        if setB[k] {
            intersection++
        }
    }
    union := len(setA) + len(setB) - intersection
    if union == 0 {
        return 0
    }
    return float64(intersection) / float64(union)
}

func bigrams(s string) map[string]bool {
    runes := []rune(s)
    m := make(map[string]bool)
    for i := 0; i+1 < len(runes); i++ {
        m[string(runes[i:i+2])] = true
    }
    return m
}

var ErrLoopDeadlock = errors.New("agent trapped in repetitive loop, forced exit")
一旦 detectLoopDeath 返回 true,状态机会立刻中断常规流程并返回 ErrLoopDeadlock。这种确定性的工程手段,难以单靠提示词工程稳定实现。
3 轮窗口的选择原理
detectLoopDeath 要求连续 3 条 Assistant 消息两两 Jaccard > 0.90 才判定死循环,这是一个 (window_size, threshold) 联合约束。窗口大小 = 3 的理由:
- 窗口 = 2 (只比较最近 2 条):误报率过高。模型正常推理中经常连续两轮输出结构相似的中间步骤(“我来读取文件” → “文件内容如下”),2 轮窗口无法区分“正常迭代”与“无效重复”。
- 窗口 = 3:要求连续三轮高度相似,正常推理路径在 3 轮内产生 90%+ 重叠的概率极低(除非模型真的在原地打转)。3 也是满足“传递性”的最小窗口:若 A≈B 且 B≈C,则 A≈C 大概率成立,确认是稳定循环而不是偶发相似。
- 窗口 > 3:延迟过高,Agent 可能在第 4–5 轮才被判定,多烧 2–3 轮 LLM 费用。对于 30 max turns 的 Agent,每多等 1 轮窗口就是 ~3% 的预算浪费。
窗口检测的是 Assistant 文本而不是 tool call 参数,因为死循环的主要表现是模型“说同样的话”而不是“调同样的工具”(后者由熔断器覆盖)。两者互补:熔断器抓 Action 层重复失败,轨迹检测抓 Thought 层重复无效。
6.7 崩溃恢复与状态持久化
借鉴 Pi 架构中的 WAL 设计,我们在每轮循环结束时调用 AgentContext.PersistCheckpoint(),将自身状态序列化到磁盘。当程序崩溃重启时,从最近的 checkpoint 恢复。
WAL 原理与当前实现的差异
经典 WAL 是数据库崩溃恢复的核心机制:先写 log,再改数据,所有状态变更以 append-only 记录追加到 WAL 文件,每条记录 fsync 落盘后才视为 committed;崩溃重启时,从 WAL 尾部向前 replay 所有未 applied 的记录,恢复到一致状态。WAL 的三个关键性质:(1) append-only,只追加不修改,顺序 IO 性能最优 (2) fsync ordering,log 落盘先于 data page 更新,保证 crash 时 log 完整 (3) idempotent replay,同一条 log 记录 replay 多次结果相同。
本书 AgentContext.PersistCheckpoint() 的当前实现是 覆盖写单文件 JSON (os.WriteFile 直接写 {sessionID}.jsonl),而不是真正的 WAL。差异在于:覆盖写没有 append-only 的历史链,每次 checkpoint 只有最新快照,crash 发生在 WriteFile 中途时文件可能 half-written (corrupt JSON);真 WAL 则保留完整变更序列,即使最后一条损坏,前 N-1 条仍可 replay 到 N-1 轮的状态。文件扩展名 .jsonl 暗示 JSON Lines 格式,但实现是单个 JSON object,这是命名上的历史遗留,后续版本应改为 append-only JSONL (每行一个 checkpoint delta)或至少采用原子写入。
go
func (ac *AgentContext) PersistCheckpoint() error {
    data, err := json.Marshal(ac)
    if err != nil {
        return err
    }
    path := filepath.Join(".agent", "checkpoints", ac.SessionID+".jsonl")
    return os.WriteFile(path, data, 0644)
}

func RestoreFromCheckpoint(sessionID string) (*AgentContext, error) {
    path := filepath.Join(".agent", "checkpoints", sessionID+".jsonl")
    data, err := os.ReadFile(path)
    if err != nil {
        return nil, err
    }

    var agentCtx AgentContext
    if err := json.Unmarshal(data, &agentCtx); err != nil {
        return nil, fmt.Errorf("corrupt checkpoint: %w", err)
    }

    // 恢复后标记状态为"从崩溃恢复"
    agentCtx.CurrentState = StateThinking
    agentCtx.Transition = Transition{Reason: "Recovery", Detail: "Restored from checkpoint"}
    return &agentCtx, nil
}上述实现为教学简化版;生产环境中,PersistCheckpoint 应该使用原子写入(先写临时文件,再 os.Rename),防止写入过程中断电导致 checkpoint 文件损坏。此外,可以只保留最近 N 个 checkpoint 文件,定期清理旧的。
原子写入:rename 的 POSIX 保证
os.WriteFile 直接覆盖目标文件的问题在于:写入是 multi-step 的,任何一步被 crash 打断,目标文件可能处于 half-written 状态,json.Unmarshal 读到截断的 JSON 直接报错,checkpoint 完全丢失。
原子写入的标准模式是 write-to-temp + rename:
go
tmp := path + ".tmp"
os.WriteFile(tmp, data, 0644)
os.Rename(tmp, path) // 原子替换
rename(old, new) 在同一文件系统上是 POSIX 原子操作,要么 old 文件完整存在,要么 new 文件完整存在,不存在“一半 old 一半 new”的中间态。内核在单个 syscall 内完成 directory entry 的替换,crash 发生在 rename 之前则 old 文件完好,发生在 rename 之后则 new 文件完好。.tmp 后缀的文件在重启后可安全删除。
PersistCheckpoint 应存什么?恢复后 LLM 调用是否幂等?
Checkpoint 必须包含 RunLoop 从 for 循环顶部重新进入所需的全部 continuation 状态,如表 6-2 所示。
表 6-2 检查点必含字段
| 字段 | 恢复必要性 |
|---|---|
SessionID, CreatedAt | 身份标识,关联 checkpoint 文件 |
Messages(完整历史) | 最关键,LLM 的输入上下文 |
CurrentState | 恢复后强制设为 StateThinking(见 RestoreFromCheckpoint) |
TurnCount, MaxTurns | 防止恢复后绕过轮次上限 |
TokensUsed, BufferTokens | compaction 决策依赖 |
ConsecutiveFails, OutputTruncated, EscalationAttempts | 熔断/续写状态不能丢 |
Transition | 审计:标记 Reason: “Recovery” |
恢复后的 LLM 调用不是严格幂等的,同一份 Messages 发送给 LLM,模型可能生成不同的 tool call (temperature > 0 时)。但这对 Agent 是可接受的:at-least-once 语义足够,恢复后模型从相同的上下文继续推理,即使选择了不同的工具,任务仍可能完成。若需要 strict exactly-once,必须在 checkpoint 中额外保存 lastLLMResponse 并在恢复时跳过 re-call,复杂度不值得,production Agent 普遍接受 at-least-once。
6.8 分布式持久化执行
这里我们使用 Go 原生的 for 循环和 select 构建了内存状态机,并用 JSONL 实现了轻量级的断点续传。对于运行在开发者笔记本上的 CLI 工具,这一组合通常足够。
任务一旦上云,例如 Kubernetes 上跑 3 小时、中间等待外部 API 回调或人类审批,Pod 可能因调度被驱逐,本地 JSONL 无法跨节点迁移。此时值得评估 Temporal 或 Cadence 等持久化执行引擎:每次 Tool Call 和 LLM 请求封装为 Activity,轨迹写入后端数据库;Worker 宕机后,另一节点通过事件重放(Replay)在断点处续跑。代价是引入独立集群与 Workflow 建模复杂度,单机 CLI 不必上 Temporal,但多租户 SaaS 里“可迁移的长任务”往往绕不开这层基础设施。
6.9 终止原因分析
参照前文对 Claude Code 源码的分析,我们的状态机定义了以下退出原因,覆盖了所有的边界条件,如表 6-3 所示。
表 6-3 状态机退出原因
| # | Reason | 触发条件 | 可恢复 |
|---|---|---|---|
| 1 | Completed | 模型无工具调用,任务完成 | — |
| 2 | Context_Canceled | ctx.Err() 非 nil (用户按 Ctrl+C 或超时) | 否 |
| 3 | Max_Turns_Exceeded | TurnCount >= MaxTurns | 否 |
| 4 | Context_Overflow | Token 触碰上限且压缩失败 | 否 |
| 5 | Output_Escalation_Failed | 输出被截断 3 次仍无法恢复 | 否 |
| 6 | Loop_Deadlock | 轨迹相似度 > 90% 连续 3 轮 | 否 |
| 7 | Rate_Limited | API 返回 429 | 是(退避重试) |
| 8 | Provider_Overloaded | API 返回 529 | 是(等待重试) |
| 9 | HITL_Rejected | 用户拒绝工具授权 | 是(反馈给模型) |
| 10 | Recovery | 从 checkpoint 恢复 | 是(继续循环) |
| 11 | Next_Turn | 正常推进到下一轮 | 是(继续循环) |
这张表就是我们在可观测性章节设计 Tracing 时的参考蓝图,每一轮的 Transition.Reason 都会被记录到结构化日志中,便于逐轮回放 Agent 的完整执行轨迹。
总之,通过一个结构清晰的 for 循环,以及 AgentContext 中记录的状态数据,我们用 Go 语言构建了一个可长时间稳定运行的 ReAct 状态机。下一章将实现工具执行管道。