主题
第 4 章:解构 OpenCode 架构与并发模型
:::
阅读建议:如果时间有限,聚焦 LSP 代码理解、Fiber 并发模型和 MCP 插件生态三个主题;Effect-TS 语法、Layer 依赖注入等框架细节可按需深入。
:::
前两章我们分别解构了 Claude Code 的精密状态机(基于官方文档、公开产品说明与可观察行为),以及顶级开源标杆 Pi 的四层洋葱模型。而在同为开源标杆的 OpenCode 中,我们将看到一种截然不同的工程思路。
OpenCode 解决的是 Agent 在超大型代码仓库(Monorepo 或百万行代码)中“迷路”的核心痛点,同时在工程底座上进行了一次较为彻底的函数式重构。
以下深入 OpenCode 的源码(packages/opencode/src/),逐层解析其四大核心工程能力。
4.1 代码理解与服务原生接入
绝大多数开源 Agent (如 AutoGPT 等)在让大模型寻找代码时,提供的工具无非是 grep(文本搜索)或者 find(文件名搜索)。当代码库变大时,大模型会遇到较为严重的“上下文爆炸”:为了找一个函数的定义,它可能会把几万行的无用代码读取到上下文中,或者因为正则表达式写错而陷入死循环。OpenCode 改走语言服务器协议(Language Server Protocol, LSP):由独立 Language Server 提供跳转、诊断等语义能力,宿主只充当 Client,把“读懂代码”从文本匹配升级为可复用的语义接口。
LSP 的架构原理:对 Agent 工程师而言,LSP 的细节价值在于:它把“读懂代码”从文本匹配变成了可复用的语义接口,下文协议分层看似繁琐,却是 OpenCode 让大模型获得 IDE 级导航能力的工程基础。LSP 采用经典的 Client–Server 分工,编辑器(或 OpenCode 这样的 Agent 宿主)是 Client,只负责把用户/Agent 的操作翻译成标准 JSON-RPC 消息;真正的语法分析、类型推断、跳转索引全部在独立的 Language Server 进程里完成。两者通过 stdin/stdout 或 socket 交换消息,Client 永远不需要理解 AST 或类型系统。
消息流基于 JSON-RPC 2.0,分三种形态:Request (带 id,必须等 Response)、Response (回传结果或 error)、Notification (无 id,单向推送,如 textDocument/publishDiagnostics)。一次完整会话从 initialize 握手开始:Client 发送客户端能力(支持的动态注册、工作区配置等),Server 返回服务端能力(是否支持 definitionProvider、diagnosticProvider 等),双方据此协商后续可用 API,这就是 capabilities 协商,避免 Client 调用 Server 不支持的方法。
握手完成后,Client 发送 initialized notification。当用户打开文档时,Client 通过 textDocument/didOpen 同步初始内容;文档发生变化时,再发送 textDocument/didChange。在 Server 完成初始化且相关文档已打开的前提下,Client 可发起 textDocument/definition 等语义请求。Shutdown 时走 shutdown → exit 有序关闭。M×N 降为 M+N 的含义正在于此:若没有 LSP,每种编辑器都要为每种语言(Go、TS、Rust……)各写一套集成;有了 LSP,M 个 Client 和 N 个 Server 可通过统一协议协作,协议层因而得以复用。
OpenCode 的破局点在于:赋予大模型真正的 IDE 级超能力。
4.1.1 语言服务器集群的按需唤醒
在 packages/opencode/src/lsp/ 目录下,OpenCode 并没有自己去解析 AST,而是直接在后台动态拉起了一个完整的 LSP Client。
但与 IDE 不同的是,OpenCode 并不会在启动时就加载所有语言服务器。它采用的是懒启动策略:
typescript
// 伪代码提炼自 packages/opencode/src/lsp/lsp.ts
const getClients = Effect.fnUntraced(function* (file: string) {
  const s = yield* InstanceState.get(state)
  const extension = path.parse(file).ext

  for (const server of Object.values(s.servers)) {
    // 1. 文件后缀不匹配?跳过
    if (!server.extensions.includes(extension)) continue

    // 2. 项目根目录检测(如找 go.mod, package.json)
    const root = await server.root(file, ctx)
    if (!root) continue

    // 3. 已知损坏的服务器?跳过
    if (s.broken.has(root + server.id)) continue

    // 4. 已有可复用的客户端?直接返回
    const existing = s.clients.find(c => c.serverId === server.id && c.root === root)
    if (existing) { result.push(existing); continue }

    // 5. 去重:是否正在启动中?共享同一个 Promise
    const spawnKey = root + server.id
    if (s.spawning.has(spawnKey)) { await s.spawning.get(spawnKey); continue }

    // 6. 首次访问:启动新的语言服务器进程
    const promise = spawnAndConnect(server, root)
    s.spawning.set(spawnKey, promise)
  }
})
spawnAndConnect 的进程模型:当懒启动命中第 6 步时,spawnAndConnect(server, root) 会调用注册表里的 spawn(root, ctx) 拉起子进程(如 gopls、typescript-language-server),并通过 stdio 管道 建立 JSON-RPC 传输层。子进程的 cwd 设为检测到的项目根目录,env 继承宿主环境并注入语言专属变量。连接建立后立即发送 initialize 请求,携带 Client 名称、版本、rootUri、capabilities;收到 Server 的 capabilities 响应后发送 initialized,再将工作区内已打开文件批量 didOpen,Client 才进入可用状态。spawn 期间同一 (root + serverId) 的并发请求会 await 共享的 spawning Promise,保证只 fork 一次。
这段代码揭示了三个关键工程决策:
- 按需启动:只有当大模型首次读取或编辑某个
.ts文件时,TypeScript 的 LSP 服务器才会启动。避免了为几十种语言预加载的巨大开销。 - 故障隔离:一旦某个语言服务器启动失败,其
(root + serverId)会被标记为broken,后续不再重试。 - 并发去重:当多个工具同时请求同一个 LSP 能力时,它们共享同一个
spawningPromise,避免重复启动进程。
broken 标记与降级策略:broken 是一个以 root + serverId 为键的内存集合,写入时机包括 spawn 超时、进程异常退出、initialize 握手失败、或连续 JSON-RPC 通信错误。标记后 getClients 会直接 skip,该语言在本工作区会话内不再重试 spawn,避免 Agent 每读一个 .go 文件就触发一次失败的 gopls 启动。清除时机通常是进程重启或用户显式重载 LSP 配置;OpenCode 不会在单次会话中自动 un-break。降级表现为:显式 lsp 工具对该语言不可用,隐式诊断注入跳过,Agent 降级到 grep/read 等文本级工具,其余语言服务器不受影响,这就是按 (root, serverId) 粒度隔离的意义。
4.1.2 服务注册表设计
在 packages/opencode/src/lsp/server.ts 中,OpenCode 内置了一套超过 40 种语言的服务器注册表,覆盖了从 TypeScript、Go、Rust 到 Haskell、Clojure、Typst 等几乎所有主流语言。
每个服务器的注册信息包含三个核心要素:
typescript
// 伪代码提炼自 packages/opencode/src/lsp/server.ts
interface ServerInfo {
  id: string                           // 如 "gopls", "typescript"
  extensions: string[]                 // 如 [".go"], [".ts", ".tsx"]
  root: (file, ctx) => string | undefined  // 项目根目录检测
  spawn: (root, ctx) => Handle              // 启动进程
}
根目录检测 是 LSP 集成的关键环节。OpenCode 提供了两种检测策略:
NearestRoot([“go.mod”]):从文件所在目录向上遍历,找到最近的go.mod作为项目根。如果找不到,降级到工作区根目录。StrictNearestRoot([“package.json”]):严格模式,找不到则返回undefined,拒绝启动。
二进制寻址策略 则更加丰富,系统会依次尝试:
- 系统
PATH中的which(“gopls”) - 项目内的
node_modules/.bin/ - 通过
npm自动安装 - 从 GitHub Releases 下载预编译二进制(如
clangd、zls) - 通过
go install、gem install、dotnet tool install等语言专属安装器
五层寻址的工程细节:每一层都有明确的 版本 pinning 与 校验 策略。PATH 层使用 which 探测,优先尊重用户已安装的全局工具;node_modules/.bin 层绑定项目 lockfile 解析出的版本,保证与 CI 一致。npm 自动安装层会在用户授权下写入项目或缓存目录,并记录已安装版本号避免重复下载。GitHub Releases 层会校验 SHA256 或 GPG 签名(视语言服务器发布渠道而定),二进制落地到沙箱缓存目录,而不是任意路径。沙箱安装权限由 OpenCode 的 permission 系统 gate:首次触发自动安装时会询问用户,拒绝则该层跳过、继续尝试下一层或最终标记 broken。对 Go 开发者而言,这与 go install golang.org/x/tools/gopls@v0.xx 的显式版本钉扎是同一思路,Agent 不应静默拉取“最新版”导致团队环境漂移。
4.1.3 双通道反馈机制
OpenCode 提供给大模型的 LSP 能力分为两条通道:
通道一:显式 LSP 工具(实验性)
在 packages/opencode/src/tool/lsp.ts 中,定义了一个名为 lsp 的工具,供大模型主动调用。它支持 9 种操作,如表 4-1 所示。
表 4-1 LSP 工具九种操作
| 操作 | LSP 方法 | 典型 Params | 典型 Response | 用途 |
|---|---|---|---|---|
goToDefinition | textDocument/definition | { textDocument: { uri }, position: { line, character } } | Location | Location[](uri + range) | 跳转到定义 |
findReferences | textDocument/references | 同上 + context: { includeDeclaration } | Location[] | 查找所有引用 |
hover | textDocument/hover | { textDocument, position } | { contents: MarkupContent | MarkedString[] } | 获取悬停信息 |
documentSymbol | textDocument/documentSymbol | { textDocument: { uri } } | DocumentSymbol[](树形 name/kind/range/children) | 文件大纲 |
workspaceSymbol | workspace/symbol | { query: string } | SymbolInformation[](跨文件 name/kind/location) | 全局符号搜索 |
goToImplementation | textDocument/implementation | { textDocument, position } | Definition | DefinitionLink[] | 跳转到实现 |
prepareCallHierarchy | textDocument/prepareCallHierarchy | { textDocument, position } | CallHierarchyItem[](name, uri, range, selectionRange) | 调用关系准备 |
incomingCalls | callHierarchy/incomingCalls | { item: CallHierarchyItem } | { from: CallHierarchyIncomingCall[] } | 谁调用了我 |
outgoingCalls | callHierarchy/outgoingCalls | { item: CallHierarchyItem } | { to: CallHierarchyOutgoingCall[] } | 我调用了谁 |
通道二:隐式诊断注入(生产级主力)
真正在日常使用中发挥核心作用的,是自动诊断注入机制。在 write.ts、edit.ts、apply_patch.ts 等文件修改工具中,每次写入操作完成后,系统会自动调用 lsp.touchFile(filepath, “document”),等待语言服务器返回诊断结果,然后将编译错误直接拼接到工具输出的末尾:
typescript
// 伪代码提炼自 packages/opencode/src/lsp/diagnostic.ts
function report(file: string, issues: Diagnostic[]) {
  const errors = issues.filter(item => item.severity === 1)
  const limited = errors.slice(0, 20) // 最多 20 条
  return `<diagnostics file="${file}">
${limited.map(d => `ERROR [${d.range.start.line + 1}:${d.range.start.character + 1}] ${d.message}`).join("\n")}
</diagnostics>`
}

// 工具输出示例:
// Edit applied successfully.
//
// LSP errors detected in this file, please fix:
// <diagnostics file="src/auth/validate.ts">
// ERROR [12:5] Type 'string' is not assignable to type 'number'
// ERROR [28:3] Property 'token' does not exist on type 'Request'
// </diagnostics>
lsp.touchFile 的触发机制:写入完成后,touchFile(filepath, “document”) 会先确保该文件的 LSP Client 已懒启动,然后向 Server 发送 textDocument/didOpen(若尚未打开)或 textDocument/didChange(同步最新 buffer 内容),告知“文档已变更,请重新分析”。语言服务器分析完成后,并不通过 Request 返回结果,而是主动推送 textDocument/publishDiagnostics notification,携带 uri 与 Diagnostic[](severity、range、message、code 等)。OpenCode 的 Client 侧维护 per-file 诊断缓存,touchFile 在发出变更通知后 poll 等待 诊断更新,通常带超时(如数秒),超时则返回已有缓存或空诊断,避免工具调用无限阻塞。
大模型在收到这段诊断反馈后,无需人类干预,就会立刻进入自修复循环:定位报错行 → 调用 goToDefinition 查看类型 → 修正代码。这种编辑即诊断的闭环,使 Agent 能够像 IDE 一样定位行号、查定义、改类型,不必再依赖全文搜索碰运气。
4.2 并发机制与容错设计
§4.1 展示了 OpenCode 如何通过 LSP 实现编辑即诊断的闭环。这些 LSP 交互、模型调用、工具执行都是异步且可能超时或失败的——OpenCode 选择用 Effect-TS 而非原生 Promise 来统一处理并发与容错。
Effect-TS 核心原理:在深入语法之前,必须先建立正确的 mental model,Effect<A, E, R> 不是“已经跑起来的异步操作”,而是一份 可组合的计算描述。写 Effect.gen(function* () { ... }) 时,你只是在构建一棵 Effect 树(蓝图);只有调用 Effect.runPromise / Runtime.runFork 时,Runtime 才会 interpret 这棵树、逐步 execute 其中的 primitive (如 Effect.sync、Effect.tryPromise),并在此时才真正触发副作用。
Promise 则相反:构造即启动,无法把“描述”与“执行”拆开。Effect 把计算留在蓝图阶段,Runtime 按栈式 interpreter 遍历节点,flatMap 顺序展开,fork 创建 Fiber,interrupt 注入中断信号,副作用推迟到叶子节点才触发。
Run 之前,框架还能向 Effect 树注入取消令牌、重试策略、Scope 生命周期和 Layer 提供的依赖(R 环境),而不必改动业务逻辑;Promise 只能在事后包 AbortController 和 retry,横切关注点越堆越厚。OpenCode 全项目替换 async/await,换取的就是这一整套可组合性,代价是学习曲线,是否值得取决于项目并发复杂度,而不是语法偏好本身。
翻开 OpenCode 的核心引擎(比如 src/session/processor.ts),可以看到一个与传统 TypeScript 项目不同的现象:整个项目里几乎没有 async/await 和 Promise。
取而代之的是满屏的 Effect.gen(function* () { ... }) 和 yield*。
4.2.1 异步并发方案选型
在 Agent 的复杂多步执行中(比如并发拉起多个工具、中间遇到网络断开、或者因为 Token 超出触发紧急压缩 Compaction),传统的 Promise 存在三个结构性局限:
- 取消是后天补丁而不是一等公民:ES2021 引入的
AbortController+signal为fetch等 API 提供了取消能力,但它并非 Promise 语义的组成部分,开发者必须手动将 signal 传入每一层异步调用,任何一处遗漏都会产生孤儿连接。在 Agent 场景中,一次工具调用往往涉及 HTTP 请求、子进程与文件写入三层嵌套异步,全链路手工穿透 signal 的心智负担远高于 Effect 的自动 Scope 级联中断。 - 错误隐匿:在
try/catch嵌套深了之后,你根本不知道一个any类型的 Error 到底是因为 JSON 解析失败还是网络断开。Promise 的错误通道是单一的reject(reason),reason可以是任意值;多层.then链与async函数混用throw时,类型信息在编译期(TypeScript 类型检查阶段)全部坍缩为unknown/any,调用方只能靠字符串匹配message做分支,在 Agent 引擎里这意味着无法对ContextOverflow与AuthError做不同降级。 - 依赖注入混乱:单例模式或全局变量在多并发 Agent 会话下容易造成数据污染 romise 本身不携带 环境(Environment) 概念,
Database.getInstance()这类全局入口在并发 Session 间共享可变状态;测试时 mock 一个 LLM 客户端需要 monkey-patch 模块或注入全局 flag,无法像 Layer 那样在 Run 边界 一次性替换依赖图。
4.2.2 服务的依赖组装
OpenCode 的所有服务都遵循 Context.Service + Layer 模式。在应用启动时,packages/opencode/src/effect/app-runtime.ts 中的 AppLayer 将 40 多个服务组装成一棵完整的依赖树:
typescript
// 提炼自 packages/opencode/src/effect/app-runtime.ts
export const AppLayer = Layer.mergeAll(
  Database.defaultLayer,       // SQLite 持久化
  SessionPrompt.defaultLayer,  // Agent 主循环
  SessionProcessor.defaultLayer, // 单轮 LLM 流处理
  LLM.defaultLayer,            // 大模型流式调用
  MCP.defaultLayer,            // MCP 外部工具
  ToolRegistry.defaultLayer,   // 工具注册中心
  Permission.defaultLayer,     // 权限仲裁
  LSP.defaultLayer,            // 语言服务器
  Plugin.defaultLayer,         // 插件系统
  // ... 其余 30+ 个服务
)
这与 Go 的 main() 中手动拼装依赖不同,Effect 的 Layer 系统能在类型检查阶段就检查出“SessionProcessor 需要 LLM 服务,但你忘了提供”这类依赖缺失问题:Effect<A, E, R> 的 R 参数会在 Layer 组装时做 require/provide 代数 消元,未满足的 R 会留在最终类型签名上,调用 run 时若缺少对应 Layer 则无法通过类型检查。注意 TypeScript 没有传统意义的编译期(产物是擦除类型的 JS),这里的“编译期检查依赖缺失”应准确理解为 静态类型检查阶段,与 Go 在 go build 时解析 interface 依赖不同,Effect 把依赖图编码进了类型系统。
Layer 组合代数:Layer.mergeAll(A, B, C) 并行合并多个 Layer 的 provide 能力,相当于把多个服务的构造函数并排;Layer.provide(layer, effect) 则把 layer 提供的 R 注入 effect,消去环境参数。Effect 在 build 时会解析 依赖 DAG:若 SessionProcessor 依赖 LLM 和 Database,而 LLM 又依赖 Config,Layer 系统自动拓扑排序实例化,无需手写 NewSessionProcessor(NewLLM(NewConfig(...)))。生命周期方面:Layer.scoped 绑定 Scope,Scope 关闭时自动释放资源;Layer.succeed / defaultLayer 通常是 singleton,整个 Runtime 共享单实例。测试中 LayerNode.replace() 可以像做手术一样精准替换某一个服务的实现,而不影响其余依赖。
4.2.3 强类型错误通道
OpenCode 使用 Schema.TaggedErrorClass 定义所有领域错误,每个错误都有唯一的标签(Tag):
typescript
// 提炼自多个源文件
class BusyError extends Schema.TaggedErrorClass<BusyError>()("SessionBusyError", {
  sessionID: SessionID,
}) {}

class ResizerUnavailableError extends Schema.TaggedErrorClass<...>()(
  "ImageResizerUnavailableError", {}
) {}

// 函数签名明确声明可能的错误类型
readonly prompt: (input: PromptInput) => Effect.Effect<Session, Image.Error>
在调用方,使用 Effect.catchTag 按标签精准匹配错误,不会出现 catch(e: any) 里面嵌套大量 if (e instanceof ...) 的混乱局面。大模型返回的异常被集中分类为 AbortedError、APIError、AuthError、ContextOverflowError 等,每种错误对应不同的降级策略。
Tagged Error 与双通道:每个 Schema.TaggedErrorClass 错误携带唯一 _tag(如 “SessionBusyError”)和类型化的 payload;Effect<A, E, R> 把成功值(A)与失败(E)拆成两条通道,yield* 走成功,Effect.fail 走错误,二者不会混进同一返回值。调用方用 Effect.catchTag(“SessionBusyError”, handler) 按标签精确捕获,其余错误继续上抛,效果接近 Go 的 errors.As,但 E 的 union 写在函数签名里,遗漏处理会在静态检查阶段暴露。
4.2.4 全链路取消机制
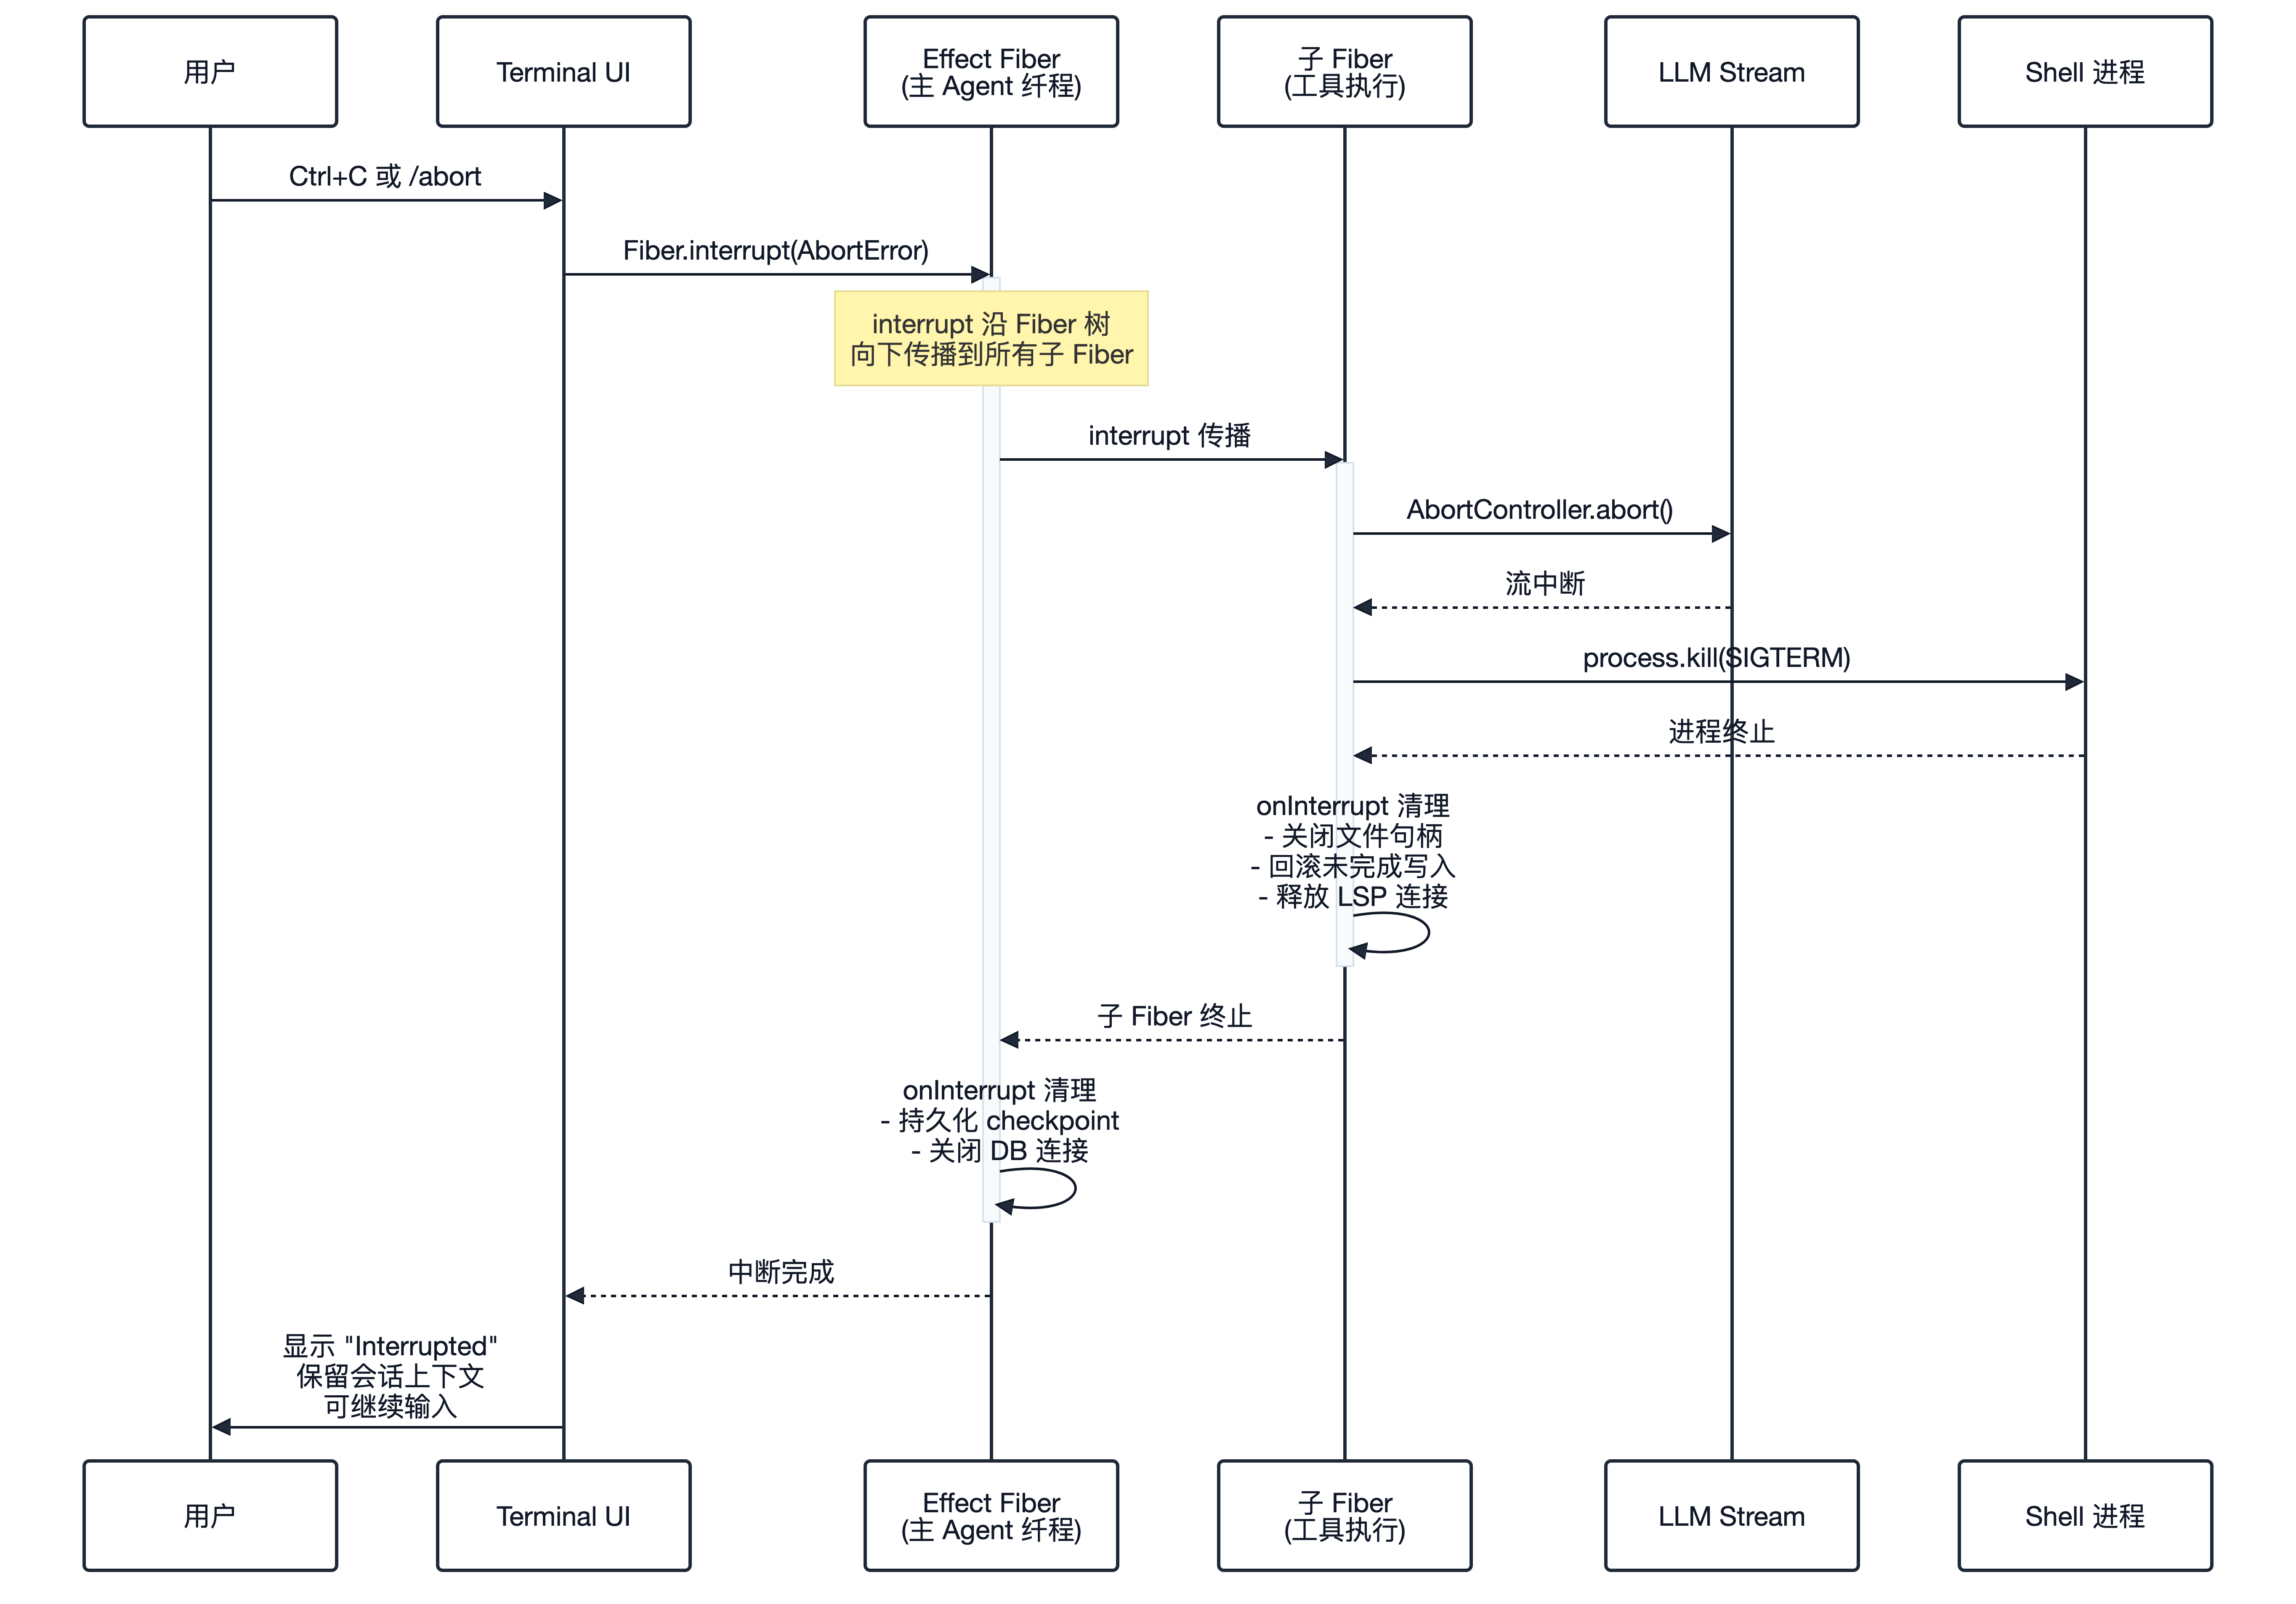
当用户按下 Ctrl+C 时,一条精密的中断链会逐层传导:
用户 Ctrl+C
  → HTTP POST /abort
    → SessionPrompt.cancel(sessionID)
      → SessionRunState.cancel(sessionID)
        → Runner.cancel → Fiber.interrupt(工作 Fiber)
          → Processor: Effect.onInterrupt → halt(AbortError)
            → 标记所有执行中的工具为 interrupted: true
              → LLM AbortController.abort() → 断开网络流
在 packages/opencode/src/effect/runner.ts 中,每个会话(Session)都运行在一个独立的 Fiber 上:
typescript
// 伪代码提炼自 packages/opencode/src/effect/runner.ts
const startRun = (work, done) =>
  Effect.gen(function* () {
    const fiber = yield* work.pipe(
      Effect.onExit((exit) => finishRun(id, done, exit)),
      Effect.forkIn(scope),  // 在独立 Scope 中 fork Fiber
    )
    return { id, done, fiber }
  })

const cancel = SynchronizedRef.modify(ref, (st) => {
  if (st._tag === "Running") {
    return [
      Effect.gen(function* () {
        yield* Fiber.interrupt(st.run.fiber)  // 中断 Fiber
        yield* Deferred.fail(st.run.done, new Cancelled())
      }),
      { _tag: "Idle" },
    ]
  }
})
与 Go 的 context.WithCancel() 级联取消如出一辙,Fiber 被中断后,其内部所有的 yield* 点都会立刻终止,Effect.onInterrupt 回调负责清理残留状态。
OpenCode 的 Fiber 调度器基于 JavaScript 微任务队列运行;Effect.fork 创建的每个 Fiber 有独立栈和中断状态。Fiber.interrupt 在下一个 yield* 边界注入协作式终止信号,并可递归传播到子 Fiber,不像 AbortController 那样只能从 Promise 外部打补丁。实践中 interrupt 发起终止、cancel 等待 join 完成,二者常成对出现。
Scope 与 forkIn(scope):Scope 是 Effect 的 资源域,类似 Go 的 context.WithCancel + defer 链的组合。Effect.forkIn(scope) 把 Fiber 的生命周期绑定到 Scope:Scope 关闭时,其内所有 fork 出的 Fiber 会被 自动 interrupt,并按 LIFO 顺序执行注册的 Scope.addFinalizer 回调(关闭连接、释放文件句柄)。OpenCode 每个 Session Run 创建独立 Scope,保证会话取消时该 Run 下所有工具 Fiber、LLM 流一并清理,而不误伤其他 Session 的 Fiber。Effect 中的 Fiber(纤程) 是可协作中断的轻量执行单元:Agent 等待用户确认时,当前 Fiber 挂起而不阻塞其他 Session 的 Fiber,取消信号沿 Fiber 树级联传播。
Fiber 全链路中断传播过程,如图 4-1 所示:
4.2.5 循环熔断检测
大模型有一种常见的“重复犯错”现象:连续用相同参数调用同一个工具。OpenCode 在 processor.ts 中实现了一个简洁的防护机制:
typescript
const DOOM_LOOP_THRESHOLD = 3

// 在每次工具调用事件中:
const recentParts = parts.slice(-DOOM_LOOP_THRESHOLD)
if (
  recentParts.length === DOOM_LOOP_THRESHOLD &&
  recentParts.every(part =>
    part.tool === currentTool &&
    JSON.stringify(part.state.input) === JSON.stringify(currentInput)
  )
) {
  // 触发权限询问:是否允许继续?
  yield* permission.ask({ permission: "doom_loop", patterns: [toolName] })
}
连续 3 次相同调用 → 暂停并询问用户。如果用户拒绝,权限错误会设置 ctx.blocked = true,Agent 循环优雅退出。这种将死循环检测内嵌到权限系统中的设计,比硬编码的最大重试次数更加灵活。
permission.ask 与计数重置:触发 DOOM_LOOP 后,Processor 调用 permission.ask({ permission: “doom_loop”, patterns: [toolName] }),请求被路由到 Permission 服务 → TUI/Web UI 弹出 Allow once / Allow always / Deny 对话框(与 shell、write 等高危工具共用同一权限框架)。在 UI 响应到达前,当前 Processor Fiber 挂起,不阻塞其他 Session 的 Fiber。若用户 Deny,抛出权限拒绝错误,ctx.blocked = true,主循环退出;若 Allow,当前工具调用继续执行,且 滑动窗口计数不立即清零,只有后续工具名或 input 发生变化,才不再命中连续 3 次相同调用的判定。用户显式 Allow 相当于对“重复调用”的 HITL 豁免,而不是重置历史 part 记录;若 Allow 后仍连续 3 次相同调用,会 再次 触发询问。
4.3 标准协议与插件化接入
在过去的一年里,每个 Agent 都在发明自己的一套工具接口格式,导致工具在不同框架之间无法复用。OpenCode 没有陷入这种内耗,而是全面拥抱 MCP 标准协议,在 packages/opencode/src/mcp/ 中展现了极强的生态开放性。本节从传输层到工具转换再到热更新,拆解 OpenCode 的插件化接入链路。
4.3.1 多传输协议支持
模型上下文协议(Model Context Protocol, MCP) 是一种标准化协议,允许 Agent 与外部数据源(如本地文件、数据库、SaaS API)进行安全通信,第三方工具只要实现 MCP Server 即可即插即用,极大扩展 Agent 的能力边界。
MCP 三层架构与能力语义:MCP 规范定义 Host → Client → Server 三层,Host 是 OpenCode 这样的 Agent 应用,负责 UI、模型调用、安全策略;Client 是 Host 内嵌的 MCP 客户端实例(每个外部连接一个 Client);Server 是独立进程或远程服务,暴露实际能力。三类能力语义不同:Tools 是模型可调用的 副作用动作(查数据库、发 PR),有 inputSchema,返回 structured content;Resources 是 只读上下文(文件片段、schema 文档),由 Host 按需 fetch 注入 prompt,模型不直接“执行”;Prompts 是 预置模板(带参数的 prompt 片段),供 Host 展开后送入模型。授权模型上,Host 必须在 Client 发起 tools/call 前做 用户确认或策略 gate (OpenCode 的 permission.ask),Server 侧也可声明 required scopes。
与 Function Calling 的关系:Function Calling 是大模型 API 层的 工具调用格式;MCP 是 工具供给方 的标准化协议。OpenCode 的流程是 MCP Server 定义 tool → Client listTools → convertTool 转为 AI SDK dynamicTool → 模型通过 Function Calling 发起调用 → Client callTool 回传 MCP Server,MCP 解决“工具从哪来、怎么连”,Function Calling 解决“模型怎么表达调用意图”。
OpenCode 支持两种 MCP 传输方式:
typescript
// 伪代码提炼自 packages/opencode/src/mcp/index.ts

// 本地服务器:通过 stdio 管道通信
const connectLocal = Effect.fn("MCP.connectLocal")(function* (key, mcp) {
  const transport = new StdioClientTransport({
    command: mcp.command[0],
    args: mcp.command.slice(1),
    cwd: path.resolve(baseDir, mcp.cwd),
    env: { ...process.env, ...mcp.environment },
  })
  const client = new Client({ name: "opencode", version })
  await client.connect(transport)
})

// 远程服务器:先尝试 Streamable HTTP,失败则降级到 SSE
const connectRemote = Effect.fn("MCP.connectRemote")(function* (key, mcp) {
  try {
    await client.connect(new StreamableHTTPClientTransport(mcp.url, { headers }))
  } catch {
    await client.connect(new SSEClientTransport(mcp.url, { headers }))
  }
})
三种传输的帧格式与容错:Stdio 传输下,Client 与子进程通过 stdin/stdout 交换 newline-delimited JSON-RPC 消息,每行一个完整 JSON 对象,无 HTTP 开销,天然适合本地 npx @modelcontextprotocol/server-* 类工具;心跳依赖进程存活检测,进程退出即连接断开。Streamable HTTP 是 MCP 新版推荐的远程传输:Client 向单一 URL 发送 POST,请求体为 JSON-RPC,响应可为 JSON 或 SSE 流(text/event-stream),支持 session id 头复用连接;帧格式为 event: message\ndata: {...}\n\n。SSE 降级用于旧版或 HTTP/2 中间件不兼容场景:Client 先 GET 打开 SSE 长连接收消息,POST 单独发请求,靠 Last-Event-ID 尝试断线重连。OpenCode 先尝试 Streamable HTTP 是因为其 单端点、双向语义更清晰;失败(404、405、CORS、代理截断)则降级 SSE 以兼容存量 MCP Server,这是 能力探测式降级,而不是性能优选。
4.3.2 工具转换流水线
当 MCP 服务器连接成功后,OpenCode 通过 packages/opencode/src/mcp/catalog.ts 中的 convertTool 函数,将 MCP 工具定义转换为 AI SDK 的标准 Tool 对象:
typescript
// 伪代码提炼自 packages/opencode/src/mcp/catalog.ts
function convertTool(mcpTool: MCPToolDef, client: Client): Tool {
  return dynamicTool({
    description: mcpTool.description,
    inputSchema: jsonSchema(mcpTool.inputSchema),
    execute: async (args, options) => {
      const result = await client.callTool(
        { name: mcpTool.name, arguments: args },
        { signal: options.abortSignal, timeout: timeout }
      )
      // 将 MCP 响应中的 content 数组拼接为纯文本
      return result.content.map(c => c.type === "text" ? c.text : JSON.stringify(c)).join("\n")
    },
  })
}
Schema 转换与多模态 content:convertTool 的核心映射规则是:MCP inputSchema(JSON Schema 对象)→ AI SDK 的 jsonSchema() 包装,保留 type、properties、required、enum 等约束,使 Function Calling 的参数校验与 MCP 侧一致。execute 闭包捕获 client 引用,调用 tools/call 时将模型生成的 args 原样传入。MCP 响应的 content 是 多模态数组,每个元素有 type 字段:text 取 text 字段;image 含 base64 data 与 mimeType;resource 引用 URI 或内联 blob,OpenCode 默认将非 text 类型 JSON.stringify 后拼入工具输出字符串,模型侧看到的是扁平文本;完整多模态保留需 Host 扩展 message part 类型。
命名空间隔离是一个关键细节:所有 MCP 工具在注册时会加上服务器名前缀,如 github_create_issue、datadog_query_logs。这防止了不同 MCP 服务器之间的工具名冲突。
在 packages/opencode/src/session/tools.ts 中,MCP 工具与内置工具、插件工具被统一合并到一个 tools 映射中,对大模型来说完全透明,它不知道也不需要知道某个工具来自内置还是 MCP:
typescript
// 伪代码提炼自 packages/opencode/src/session/tools.ts
const resolve = Effect.fn("SessionTools.resolve")(function* (input) {
  const tools: Record<string, Tool> = {}

  // 1. 注册内置工具(shell, read, write, grep, glob, ...)
  for (const item of registry.list()) { tools[item.id] = wrapBuiltin(item) }

  // 2. 注册 MCP 外部工具(自动加命名空间前缀)
  for (const [key, item] of Object.entries(yield* mcp.tools())) {
    item.execute = (args, opts) => run.promise(
      Effect.gen(function* () {
        yield* ctx.ask({ permission: key })  // 权限校验
        return yield* Effect.promise(() => item.execute(args, opts))
      })
    )
    tools[key] = item
  }

  // 3. 注册插件工具
  for (const [key, item] of Object.entries(yield* plugin.tools())) { tools[key] = item }

  return tools
})
resolve 合并流水线与冲突规则:三步注册顺序为 builtin → MCP → plugin,后写入 tools Record 的条目 覆盖 同名先注册项。内置工具 ID 固定(read、write、grep 等),MCP 工具带 serverName_ 前缀,通常不与 builtin 冲突;真正需警惕的是 MCP 与 plugin 同名,plugin 第三步执行,会覆盖 MCP 定义,便于用户用本地插件 shim 外部工具。OpenCode 不在运行时做 merge 深度合并,而是 last-write-wins 浅覆盖;resolve 在 每轮 LLM 调用前 执行,保证 MCP 热更新后的 mcp.tools() 快照进入当轮 tool list。权限包装只加在 MCP 层:builtin 有各自的 permission hook,plugin 自行负责。
4.3.3 工具列表的热更新
当 MCP 服务器在运行时动态添加或移除工具时(比如数据库连接了新的表),OpenCode 能即时感知:
typescript
// MCP 客户端监听 ToolListChangedNotification
client.setNotificationHandler("notifications/tools/list_changed", async () => {
  // 重新拉取工具列表并更新缓存
  const newDefs = await client.listTools()
  state.defs[serverName] = newDefs.tools
  // 发布事件通知 UI 和工具注册中心
  yield* events.publish("mcp.tools.changed", { server: serverName })
})
热更新与进行中 tool call:ToolListChangedNotification 到达时,OpenCode 立即 刷新 state.defs 缓存并发布 mcp.tools.changed 事件,但 不会中断 已在执行的 tools/call,进行中的调用仍绑定旧 Client 连接与当时 snapshot 的 tool handler,自然跑完。下一轮 SessionTools.resolve 才会把新工具(或已移除工具的缺席)反映到 LLM 的 tools 参数里;若模型在旧列表中发起的 call 指向已删除工具,execute 层会返回明确错误,Agent 可重试或换工具。UI 层订阅事件刷新工具面板,避免用户看到过时的 MCP 清单。这种 最终一致 策略与 LSP 动态 capability 类似:通知 ≠ 强杀 in-flight 请求。
4.4 事件溯源与持久化存储
与 Claude Code 的内存 messages 数组(截断内容落盘但无会话级持久化)和 Pi 的 JSONL 文件不同,OpenCode 选择了关系型数据库(SQLite)+ 事件溯源 作为会话持久化方案。设想 Agent 正在写入第 47 条 tool result 时进程被 OOM 杀掉:纯内存方案全部丢失;JSONL 方案保留了完整行,仅末尾可能留下半行截断记录(可通过逐行校验跳过);OpenCode 则靠 SQLite WAL 恢复到最后一次成功写入的 message/part 边界,主循环重启后从 DB 重读即可续跑,至多丢失 Projector 尚未落盘的那一帧。
OpenCode 采用 monorepo 布局:Agent 引擎与 LSP/MCP 等运行时能力集中在 packages/opencode,而会话持久化 schema 定义在独立的 packages/core 包。在 packages/core/src/session/sql.ts 中,核心表结构如下:
typescript
// 提炼自 packages/core/src/session/sql.ts (Drizzle ORM)
const SessionTable = sqliteTable("session", {
  id: text().primaryKey(),
  project_id: text().notNull(),
  title: text().notNull(),
  permission: text({ mode: "json" }),  // 会话级权限规则
  agent: text(),
  model: text({ mode: "json" }),       // 当前使用的模型配置
})

const MessageTable = sqliteTable("message", {
  id: text().primaryKey(),
  session_id: text().notNull(),
  data: text({ mode: "json" }).notNull(),  // 完整消息 JSON
})

const PartTable = sqliteTable("part", {
  id: text().primaryKey(),
  message_id: text().notNull(),
  session_id: text().notNull(),
  data: text({ mode: "json" }).notNull(),  // 文本块/工具调用/推理过程
})
Event Store 与投影滞后:OpenCode 的事件溯源并非经典 CQRS 全量 event log 表,而是 EventV2Bridge 发布领域事件 → SessionProjector 异步写入 SQLite。逻辑上仍可视为 event store:message / part 行的 data JSON 是 投影结果,事件流在内存 bus 上短暂存在。Projector 滞后意味着 UI 可能在毫秒级内读到 略旧 快照;Agent 主循环每轮 filterCompactedEffect 从 DB 重读,以 持久化边界 为准。崩溃恢复时,未投影完的事件可能丢失最后一帧更新,通过 WAL 模式与同步写策略折中。Snapshot 策略:Compaction 触发时生成摘要 message,旧 part 标记 compacted 而不是物理删除,相当于 软 snapshot,重放时跳过已压缩区间以控制 context 体积。
Message / Part 划分原则:message 表存 消息级元数据,一条 message 对应 LLM 的一轮 user/assistant/system 交互。part 表存 可独立流式更新的片段,同一条 assistant message 可含多个 part:文本 delta、reasoning 块、tool-call、tool-result 各一条 part 记录,按插入顺序组装完整 assistant 回复。划分原则是 流式写入粒度 + 类型异构:需要 SSE 推送到 UI 的每种事件类型单独成 part,避免整 message 频繁全量 rewrite。组装时按 message_id + 创建序 merge,SessionProjector 保证 part 与 message 外键一致。
事件驱动写入:Agent 循环不直接操作数据库。每次消息更新或工具调用完成时,系统通过 EventV2Bridge 发布事件,由 SessionProjector 异步投影到 SQLite。这种设计将 Agent 引擎与存储层完全解耦。
每轮从数据库重读:主循环每轮迭代都从 SQLite 重新加载消息列表(MessageV2.filterCompactedEffect),而不是信任内存中的可变数组。多 Session 并发时,这一设计也避免 A 会话的 compaction 被 B 会话的内存副本覆盖,持久化边界即一致性的锚点。
filterCompactedEffect 与 Compaction 表示:Context Compaction 在 DB 层体现为:被压缩的历史 part 在 JSON 中标记 compacted: true 或迁入专用 summary part,原始细粒度 part 仍保留但 不参与 LLM context 重建。filterCompactedEffect 查询 message/part 后,过滤掉已 compacted 的条目,并插入 summary message 替代其语义;规则通常是 保留最近 N 轮完整 part + 最远一条 summary 链,中间段只留 compaction artifact。这与 Pi 的“物化视图”不同,OpenCode 靠 DB 过滤函数 在读取边界做视图,而不是维护独立 snapshot 表。
从 OpenCode 的源码中,我们提炼出了编写超大型代码库 Agent 的四大核心设计:
- LSP 级代码导航:懒启动 40+ 语言服务器,通过双通道(显式工具 + 隐式诊断注入)赋予大模型 IDE 级别的语义理解能力。
- Effect Fiber 级并发控制:用 Layer 依赖注入减少全局单例,用强类型错误通道约束 catch(e: any) 式的宽泛错误处理,并用 Fiber 中断链传递取消信号,从而降低状态污染和资源泄漏的风险。
- 标准化外设接入(MCP):通过多传输协议、命名空间隔离和动态热更新,实现了真正的微内核+无限扩展的插件化生态。
- 事件溯源持久化:用 SQLite + Drizzle ORM 构建结构化存储,每轮从数据库重读状态,保障崩溃恢复的一致性。
4.5 架构模式提炼与选型决策
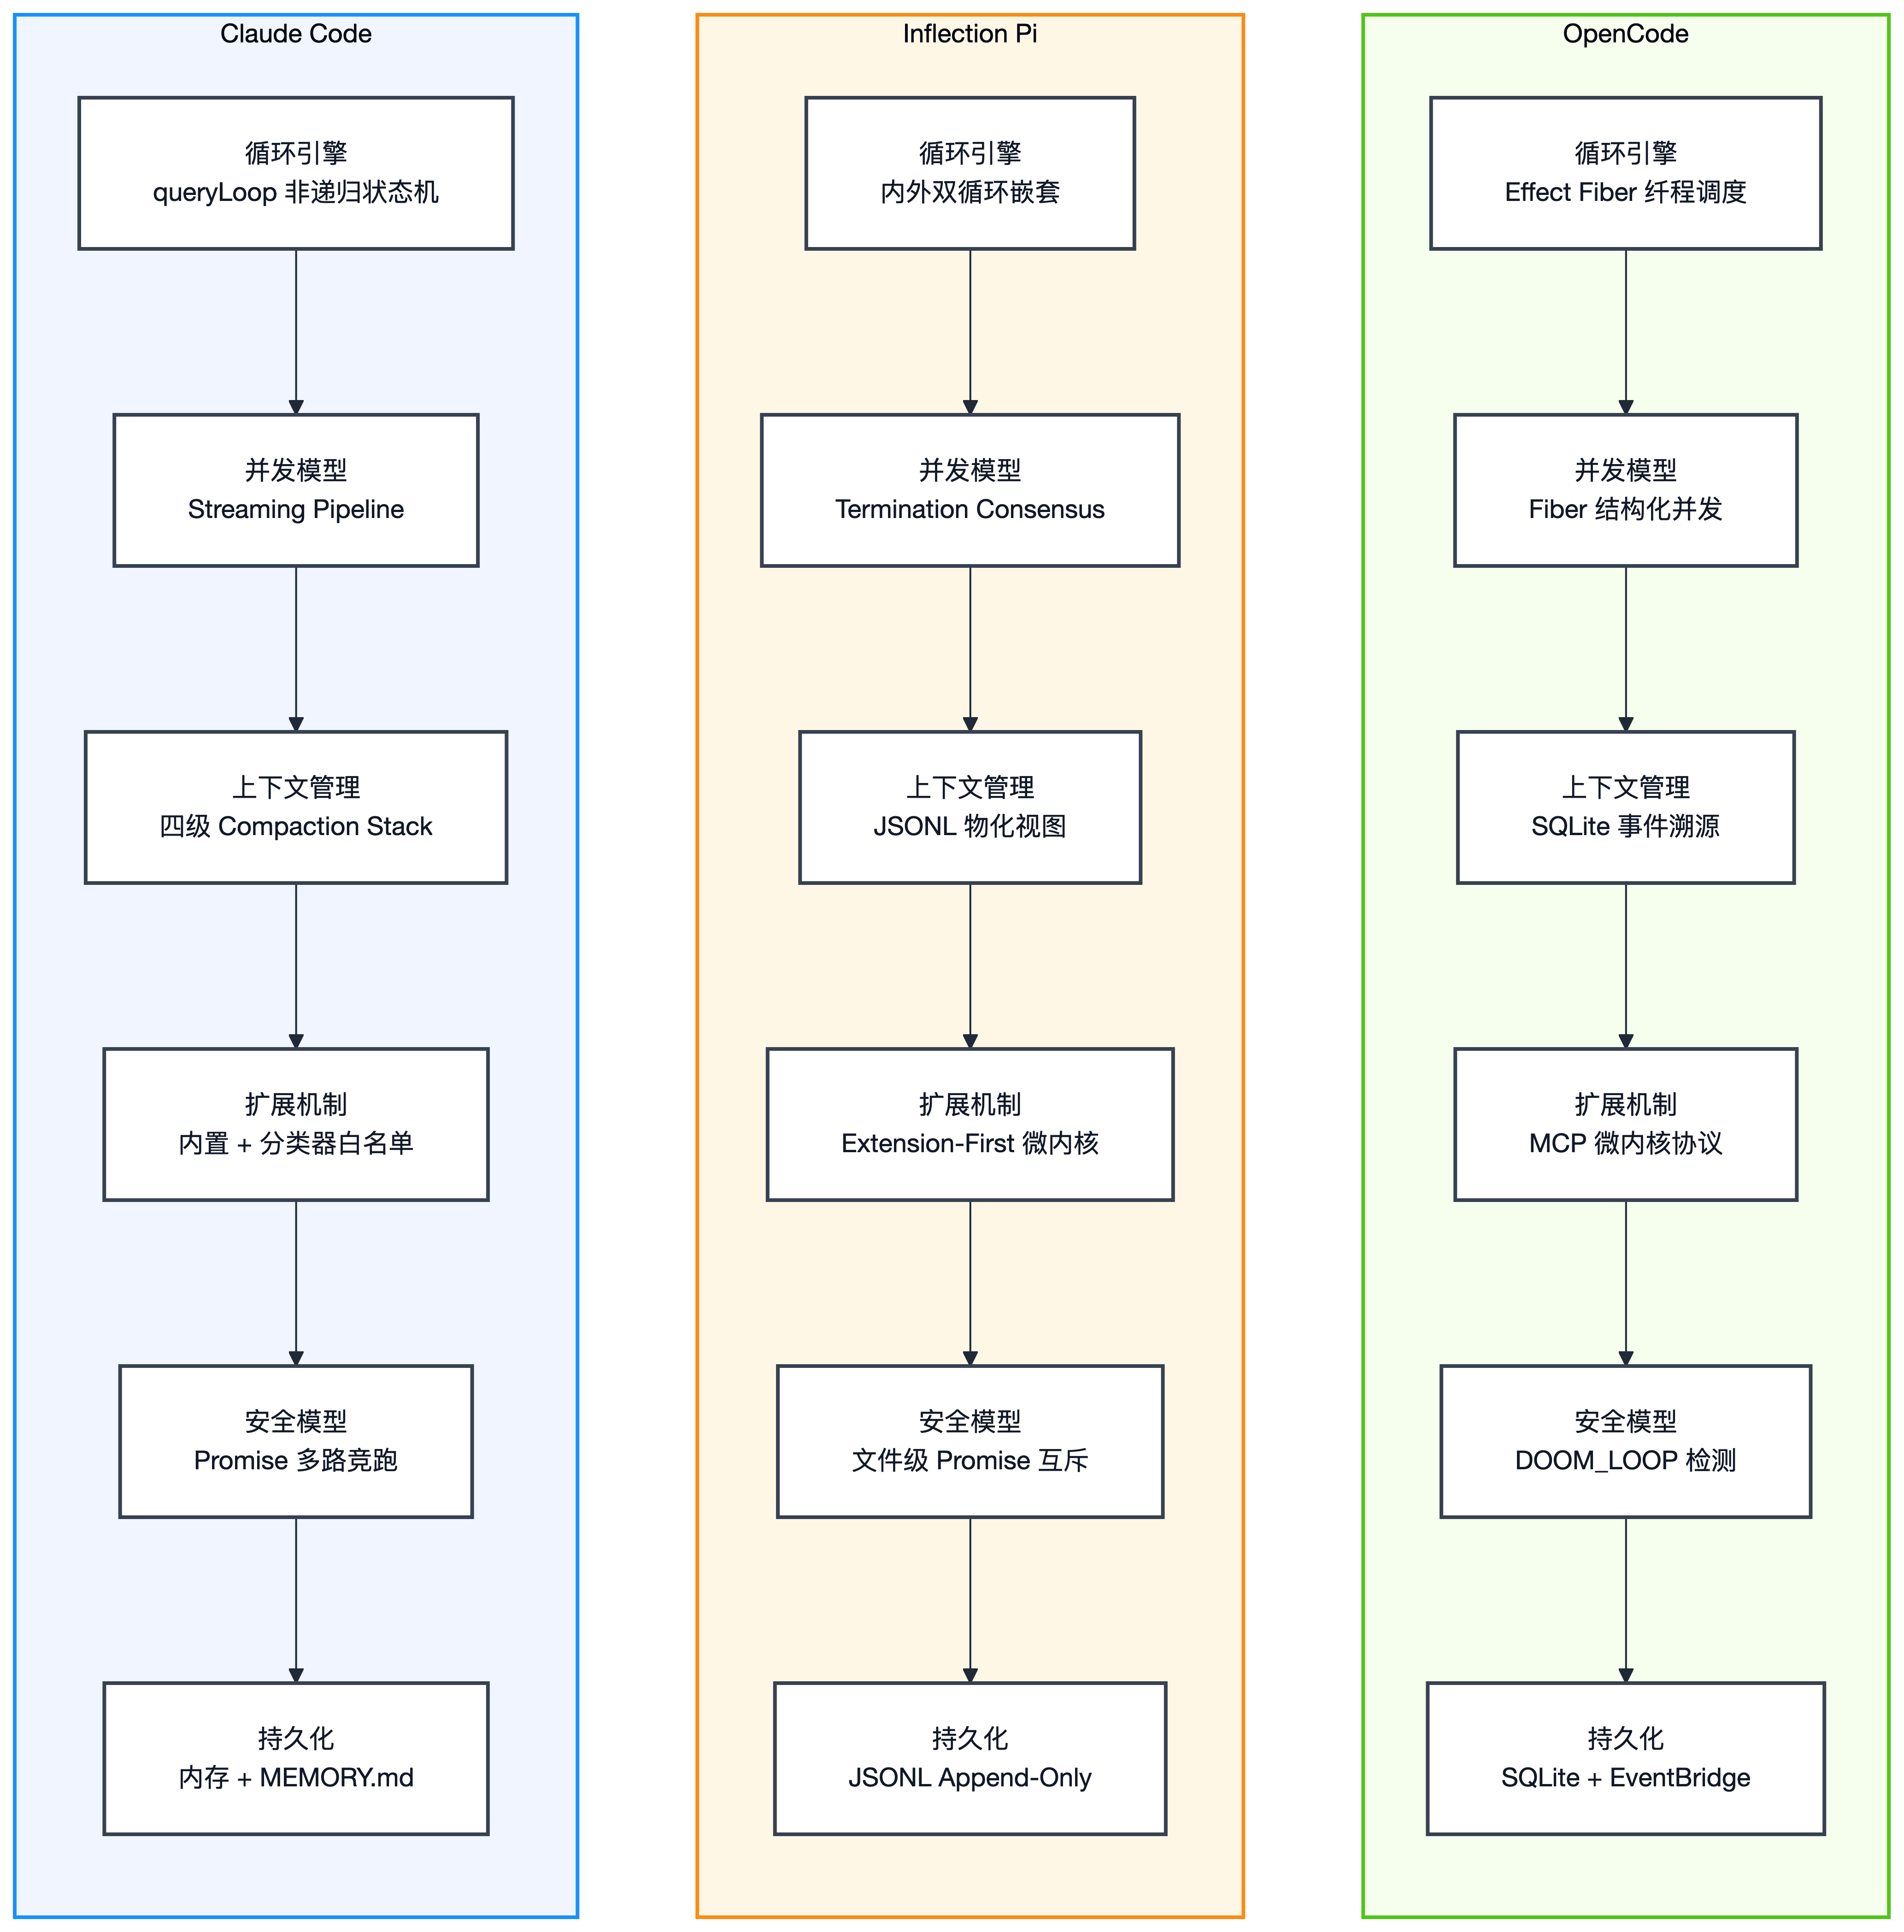
至此,三个顶级系统的解构全部结束。Claude Code、Pi 和 OpenCode 在语言、框架和设计偏好上截然不同,但当我们把它们的核心机制并排摊开,会发现同一组工程问题在三个代码库中反复浮现。这绝非巧合,它说明这些问题是循环工程固有的结构性约束,任何一个生产级实现都绕不过去。
在动手写第一行 Go 代码之前,我们需要先回答一个关键问题:从三份“别人的答卷”中,到底可以提炼出哪些可迁移的架构模式?它们各自的权衡点是什么?我们又该如何为本书的 Go 实现做出选型决策?
4.5.1 六大共性模式
将三个系统的设计选择对齐到同一张表中,一个清晰的模式目录自然浮现,如表 4-2 所示。
表 4-2 三大架构共性模式对照
| 共性模式 | Claude Code | Pi | OpenCode | 本书选型(Go) |
|---|---|---|---|---|
| 非递归状态机 | async function* 生成器 + while(true) | 内外双循环 + 操控/追问双队列 | Effect Fiber + Runner | for-select 循环 + 枚举状态(状态机章节) |
| 分级压缩管道 | 4 级:Budget → Snip → Microcompact → AutoCompact | 物化视图 + 安全切割点 | DB 过滤 + compacted 标记 | 3 级:Buffer → Snip → deepCompact (记忆压缩章节) |
| 工具安全隔离 | AST 白名单(Fail-Closed)+ 沙箱 | 插件子进程隔离 | Fiber 中断链 + Scope 取消 | AST 静态分析 + errgroup 兄弟熔断(工具箱章节) |
| 并发调度 | StreamingToolExecutor 流式重叠 | 文件互斥队列 + 协程锁 | Effect.all 并发 fork | errgroup + safe/unsafe 分拣(工具箱章节) |
| 记忆分层 | 后台书记员 + 双轨制 Haiku 预加载 | Git 级不可变状态树 | SQLite 事件溯源投影 | 关键词检索 + 后台压缩(记忆压缩章节) |
| 人机协同挂起 | HITL 审批 + 多路竞跑 | 追问队列注入 | permission.ask + Fiber 挂起 | channel 挂起 + select 竞跑(HITL 章节) |
上表“工具并发”一行中的 OpenCode 并非直接使用 Go 的 errgroup 包,而是 Effect 侧的 Fiber 并行 + 兄弟中断 模式,与 golang.org/x/sync/errgroup 语义同构:Effect.all / Effect.forEach 并发 fork 多个工具 Fiber,共享父 Scope;任一工具失败或父 Fiber 被 interrupt 时,兄弟 Fiber 收到级联中断,等价于 errgroup.WithContext(ctx) 在 gCtx 取消后 停止等待其余 goroutine。后续工具箱章节将用 Go 原生 errgroup 复现 Claude Code 的 StreamingToolExecutor 兄弟熔断,读者可对照 4.2.4 的 Fiber 中断链理解两种语言下的同一设计模式,如图 4-2 所示。
4.5.2 三组关键权衡
模式只是“做什么”,真正的架构能力体现在“怎么取舍”。以下三组权衡贯穿了整个第二篇的设计决策。
权衡一:自动路由 vs 手动配置
Claude Code 在 Provider 故障时自动从 Sonnet 降级到 Haiku,对用户完全透明;OpenCode 则要求用户在配置文件中显式列出 Model Profile 和优先级。前者用户体验更好但控制权弱,后者灵活但配置成本高。我们的策略是取中间态:默认提供基于 CostTier 的自动分级路由,同时允许配置文件覆盖任何自动决策(LLM 驱动器章节的 FallbackProvider + 架构演进章节的 Router)。这遵循了 Unix 哲学中“合理的默认值 + 可覆盖的旋钮”原则。
权衡二:框架绑定 vs 标准库优先
OpenCode 深度依赖 Effect-TS 的 Fiber 和 Layer 体系,获得了优雅的组合性,但也意味着整个 Agent 引擎与 Effect 生态绑定。Claude Code 走了另一个极端,几乎所有中间件(压缩、缓存、沙箱)都是自研的,零外部依赖但维护成本极高。Go 生态的惯例是标准库优先、第三方库按需引入。我们将依赖控制在最小集合:golang.org/x/sync/errgroup(并发)、go.opentelemetry.io(可观测)、github.com/charmbracelet/bubbletea(TUI)。核心状态机、压缩管道、工具箱全部用标准库实现,确保引擎可以在任何 Go 环境中编译运行,不受框架生命周期约束。
权衡三:全量持久化 vs 按需快照
OpenCode 的事件溯源做到了每条消息、每个 Part 都实时写入 SQLite,崩溃恢复精度极高,但代价是每轮循环都有 DB I/O 开销。Claude Code 选择了纯内存运行 + 文件系统备份,性能最优但崩溃时可能丢失最后几轮对话。我们选择 Checkpoint 快照:仅在关键状态跃迁点(任务完成、验证通过、用户中断)序列化 AgentContext 到磁盘,恢复时从最近一个 Checkpoint 重建。这在“丢失容忍度”和“I/O 开销”之间取得平衡,对于交互式 CLI Agent,丢失最后一轮对话是可接受的,但丢失整个会话不可接受(状态机章节的 PersistCheckpoint + 第十三章的 resume 命令)。
4.5.3 实现篇的设计蓝图
基于以上模式提炼和权衡分析,我们即将构建的系统可以用一句话概括:一个基于 Go for-select 状态机驱动的、具备三级记忆压缩管道和 errgroup 并发工具箱的、支持人机协同挂起的单进程 Agent 引擎。
从下一章开始,我们将按照依赖关系自底向上构建这个引擎:
- LLM 驱动器(底座层):统一模型接入,封装 OpenAI / Anthropic / DeepSeek 的流式 API 差异,提供
LLMPort接口和FallbackProvider降级链。 - 状态机(心脏层):状态机与 ReAct 循环,定义
AgentContext、Transition枚举和RunLoop主循环,实现熔断器和崩溃恢复。 - 工具箱(手脚层):工具执行管道,构建
ToolRegistry、AST 安全分析和errgroup并发调度。 - 记忆压缩(记忆层):上下文压缩,实现三级 Buffer → Snip → Summarize 管道和项目级记忆检索。
- HITL:人机协同,用
chan+select实现执行流挂起与多路竞跑。
每一章解决一个独立的工程问题,但所有章节共享同一个 domain/ 领域层,Message、ToolCall、AgentState 等类型定义在最内圈,适配器和编排器在外圈,依赖方向始终指向内层。这便是整洁架构在 Agent 工程中的具体投射。