主题
第 3 章:解构 Pi 架构的终端渲染与洋葱模型
:::
阅读建议:如果时间有限,聚焦双队列打断机制和记忆树两个核心设计,即可理解 Pi 的差异化思路;嵌套循环伪代码、互斥锁实现等工程细节适合实装时回读。
:::
与闭源商业产品不同,开源的 Pi (下文也称 Coding-Agent)为我们提供了可直接检查的分层样本。其结构可以用洋葱模型来解释:系统分成由内向外的四层同心结构,内核是 Agent 循环,外层依次是会话编排、I/O 适配与 LLM 网关,每层可独立替换而不伤及内核。Pi 同时吸收了六边形架构的端口—适配器思路,终端渲染则采用了不依赖 React 的方案。
如果你的目标不仅是写一个能在自己电脑上跑的脚本,而是要开发一个既能作为独立 CLI 工具,又能作为后端服务(RPC),甚至能内嵌到 IDE 里的 Agent 框架,那么 Pi 的架构设计值得作为参考。
3.1 架构全景与渲染选型
章标题里有两个容易被当成“营销词”的短语,四层洋葱模型和摒弃 React 的终端渲染,它们不是装饰,而是 Pi 能在 CLI / RPC / SDK 三种形态下复用同一套核心的根本原因。下面先把整张地图铺平,再进入各节的源码解剖。
3.1.1 四层洋葱模型与职责划分
Pi 的 monorepo 把 Agent 系统切成四个同心层,依赖方向严格由外指向内:外层可以调用内层,内层对 UI、文件系统、具体 LLM 供应商一无所知。这与六边形架构的“端口—适配器”思想高度相似:Core 只定义端口(接口),Adapter 负责落地。两者的关注点并不完全相同:洋葱架构强调领域内核及同心分层,六边形架构更强调应用与外部世界之间的端口边界。本章用“洋葱模型”描述分层,用“端口—适配器”解释依赖反转,如表 3-1 所示。
表 3-1 Pi 四层洋葱模型职责
| 层级 | 名称 | 职责 | 源码映射 |
|---|---|---|---|
| L1 (最内核) | Core Engine | 纯 Agent 循环:LLM 调用 → 工具执行 → 结果回流;双队列注入;emit 事件流 | packages/agent(agent-loop.ts、Agent 类) |
| L2 | Session Orchestration | 会话生命周期、JSONL 记忆树、压缩、扩展编排、模型/思考级别切换 | packages/coding-agent/src/core(AgentSession、SessionManager、compaction/) |
| L3 | I/O Adapters | 工具实现(bash/read/edit/write)、TUI 渲染、RPC/JSON 模式、子进程隔离 | packages/coding-agent/src/core/tools、packages/tui、modes/ |
| L4 (最外层) | LLM Gateway | 多供应商统一 API、streamSimple 流式调用、Token 计数、API Key 解析 | packages/ai |
为什么叫“洋葱”而不是“三层 MVC”? 因为每一层都可以被整体替换而不伤及内核。换 Anthropic 为 OpenAI?只动 L4。把 TUI 换成 WebSocket 推送?只动 L3。Compaction 策略升级?只动 L2。Agent 循环的嵌套状态机?L1 一行不改。这种可替换性(Substitutability)正是工业级 Agent 与 Demo 脚本的分水岭。
与经典六边形架构的对照:L1 是 用例/领域逻辑(Application Core);L2 是 编排与持久化(Application Services);L3/L4 分别是 驱动适配器(Driving Adapter,如 TUI、RPC)和 被驱动适配器(Driven Adapter,如 LLM API、文件系统)。Pi 没有引入 DI 框架,但 AgentLoopConfig 里的 convertToLlm、transformContext、getSteeringMessages 等回调,其实就是手动注册的端口。这张表中最值得关注的是 L1 与 L2 的切分,Compaction、记忆树、扩展编排若渗入 Core,换 UI 或换供应商时将牵一发动全身。
3.1.2 终端渲染方案对比
Claude Code 选择 React + Ink 渲染终端,组件化、声明式、生态成熟,但代价是:每个 React 组件都是一次 Virtual DOM diff,在 120Hz 流式 Token 场景下,Reconciliation 开销与 Ink 的布局计算会争抢主线程。输出交错由此产生。React 的生命周期与 Agent 事件流天然不同步,模型吐 Token、工具并发回传、用户 Ctrl+C 打断,三路事件同时到达时,React 的 setState 批处理往往来不及对齐。
Pi 走了另一条路:自研 @mariozechner/pi-tui,一套极简的 Component + 差分渲染 框架。核心机制:
- 无 Virtual DOM:每个组件实现
render(): string[],返回当前帧应显示的终端行数组。TUI 容器拿新旧两帧做 diff,只重绘变化行,而不是全屏刷新。 - 同步输出:通过 DEC 私有模式 2026 (控制序列
\e[?2026h开启、\e[?2026l关闭,此处 2026 是模式号,与年份无关),保证一帧内的所有行原子写入,消除闪烁,这在 Claude Code 的 Ink 方案中需要额外 hack 才能实现。 - 事件驱动刷新:
AgentSession订阅message_update、tool_execution_start等事件,每收到事件调用tui.requestRender(),渲染是事件的结果,不是轮询的产物。数据流是单向的:Event → Model 更新 → View 重算 → 差分输出。
总之,Claude Code 用 React 换开发效率;Pi 用原生差分渲染换性能与事件对齐。对于要在 RPC 模式(无 TUI)、SDK 模式(嵌入 IDE)、Interactive 模式(全功能 TUI)之间无缝切换的框架而言,把 UI 层做成可拔插的 L3 适配器,比将 UI 耦合在 React 树中,架构弹性明显更高。这一选择意味着放弃 React 生态的组件库与调试工具,尚无定论哪条路径在团队规模扩大后总成本更低。
3.2 核心循环与队列注入
在很多业余的 Agent 框架中,大模型 API 调用、工具执行和对话记录往往被揉成一团,写在一个臃肿的类里。一旦遇到用户中途打断、或者需要重试报错的命令,整个状态就全乱了。
Pi 架构在 packages/agent/src/agent-loop.ts 中给出了一个较为清晰的解法:将“循环”本身变成一个纯粹的、无状态的异步函数,而将“状态”交给外部的代理对象管理。 同时,它引入了独特的双队列注入机制——steeringQueue(转向队列,用于人类中途介入)和 followUpQueue(追问队列,用于自动补充上下文):前者让用户的紧急打断指令可插队执行,后者在 Agent 准备退出时仍接收追加任务,有效解决了外部事件在循环运行期间的注入问题。本节先阐明循环的无状态设计原则,再展开双队列的工作方式。
容易被忽视的一点:纯函数 循环 与外部 State 的边界
这里“无状态”不是说系统没有记忆,而是说 runLoop / agentLoop 函数本身不持有任何跨轮次的 mutable 字段。每次调用时,所有可变数据都通过参数注入:
AgentContext(传入):messages[]、systemPrompt、tools[],这是 LLM 看到的“世界快照”。循环可以往context.messages里 push 新消息,但不会自己创建或持久化 Context。AgentLoopConfig(传入):convertToLlm、transformContext、getSteeringMessages、getFollowUpMessages,全是回调端口,循环只调用,不实现。emit(传入):事件_sink,循环只广播,不订阅。
哪些 mutable 留在外部? Agent 类持有 steeringQueue / followUpQueue(PendingMessageQueue 实例)、streaming 状态、订阅者列表;AgentSession 持有 SessionManager(JSONL 树)、settings、extension runner。循环通过 config.getSteeringMessages?.() 一次性 drain 队列,读后即焚,队列的生命周期完全在 Agent 对象里,循环连队列的引用都拿不到。
为什么这样切? 可测试性。测试 循环 时,构造一个假的 AgentContext(3 条 messages)、一个 stub emit(收集事件数组)、一个 mock streamFn(返回固定 assistant 响应),不需要启动 TUI、不需要写 JSONL、不需要网络。这就是函数式核心 / 命令式外壳模式在 Agent 领域的典型应用,内核是纯逻辑,外壳(Session、UI、磁盘)是可替换的副作用层。
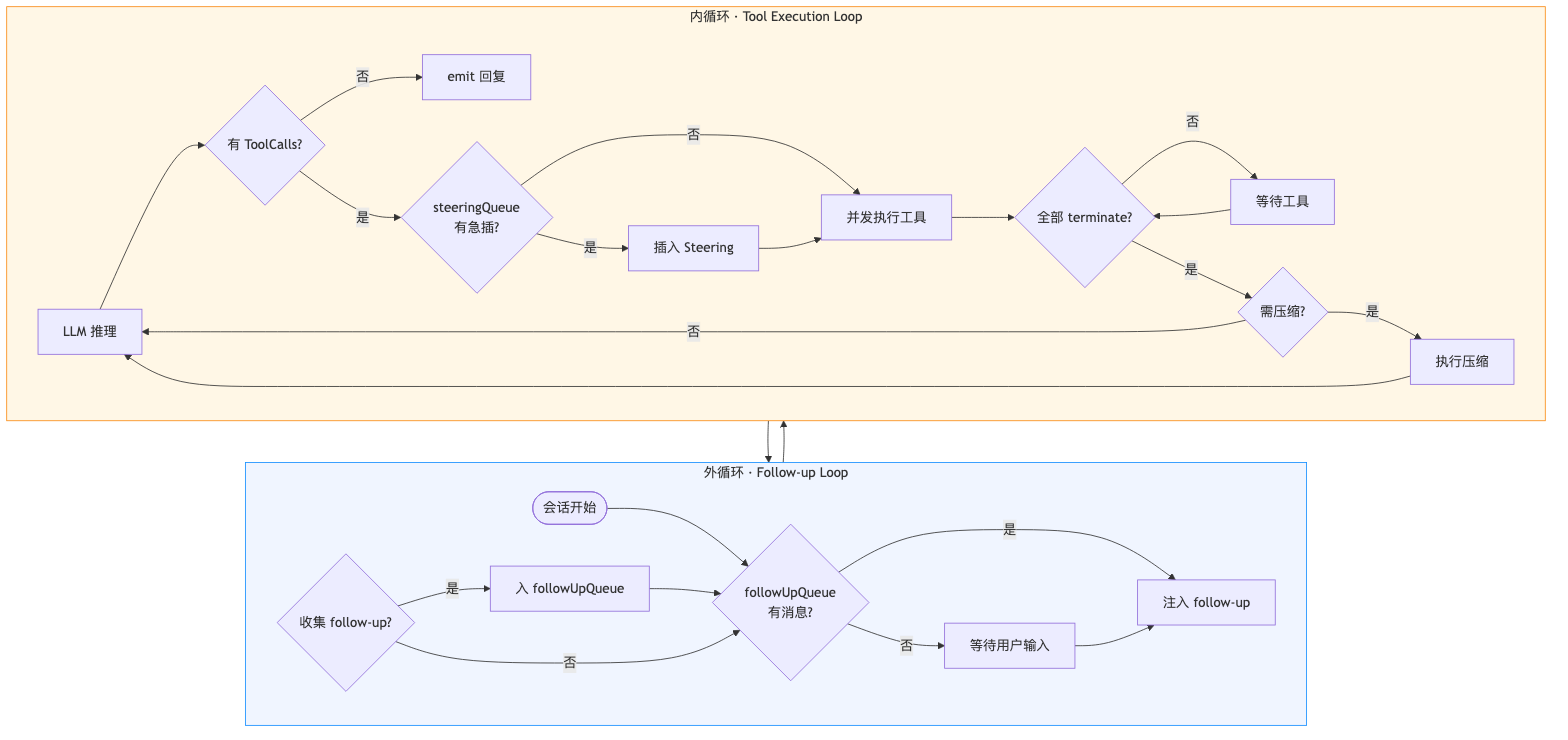
3.2.1 内外双循环设计
为什么需要两层循环?单层循环在内循环结束时只能退出,无法处理“Agent 刚说完话,但追问队列又进来新任务”的场景。Pi 通过外层循环持续检查追问队列,只有队列彻底清空时才真正退出,避免了丢弃后台追加的异步任务。
Pi 的核心循环不是一个简单的 while(true),而是包含了内、外两个嵌套的循环:
typescript
// Pi 核心循环伪代码提炼 (agent-loop.ts)
async function runLoop(context, config, emit) {
  // --- 外层循环:生命周期级 ---
  // 它的存在是为了处理那些在 Agent 想要停止时,突然追加进来的任务(Follow-ups)
  while (true) {
    let hasMoreToolCalls = true;

    // --- 内层循环:执行级 ---
    // 处理连续的工具调用和模型思考
    while (hasMoreToolCalls || pendingSteer.length > 0) {

      // 1. 【关键】在每次发给大模型前,检查操控队列并注入用户强行插入的话
      if (pendingSteer) injectToContext(pendingSteer);

      // 2. 流式请求大模型
      let assistant = await streamLLM(context);
      if (assistant.stopReason === "error") return;

      // 3. 并发执行大模型返回的工具
      let toolResults = await executeToolCalls(assistant.toolCalls);

      // 如果所有工具都同意结束(terminate: true),内循环终止
      hasMoreToolCalls = !toolResults.every(r => r.terminate);

      // 检查是否有新的插话
      pendingSteer = drainSteeringQueue();
    }

    // 内循环结束,Agent 准备收工了。此时检查“追问队列”
    let followUps = drainFollowUpQueue();
    if (followUps.length > 0) {
      pendingSteer = followUps; // 把追问变成下一轮的操控指令
      continue; // 继续外层循环
    }

    break; // 真没任务了,彻底退出
  }
  emit("agent_end");
}
3.2.2 操控队列与追问队列
长周期任务(如持续十分钟的代码重构)执行过程中,用户随时可能发现 Agent 偏离了预期方向。传统做法是抛出异常终止进程,但这会丢失此前的所有进度。Pi 团队的解法是在运行时引入双队列注入机制,既允许用户实时纠偏,又不中断任务执行链。
操控队列:急刹车与打方向盘 当用户在模型正在思考或工具执行的间歇输入指令时,这句话会被投入
steeringQueue。在内循环的每一次转折点(请求大模型前),引擎都会去清空(drain)这个队列。这相当于在原本的对话末尾强行塞入一句用户提示,大模型在下一轮收到这句话后,会结合刚获取的上下文调整动作,而整个任务执行链不会断裂。追问队列:排队等候的批处理 有些任务(比如扩展插件在后台静默生成的分析报告,或者用户连贴了三段长命令)不能中途打断大模型的思路。它们会被放入
followUpQueue。只有当内循环彻底干完活、Agent 打算进入“闲置”状态时,外循环才会提取这个队列,顺滑地开启下一阶段任务。
双队列背后的取舍
Pi 的双队列不是 OS 级 pipe,也不是 Redis Stream,而是 Agent 类内部的两个 PendingMessageQueue 实例,关键在于内存数组 + drain 清空语义:
typescript
// packages/agent/src/agent.ts 简化
private readonly steeringQueue: PendingMessageQueue;
private readonly followUpQueue: PendingMessageQueue;
// AgentLoopConfig 回调:
getSteeringMessages: async () => this.steeringQueue.drain(),
getFollowUpMessages: async () => this.followUpQueue.drain(),
drain() 是“取出并清空”,不是 peek。 每次内循环转折点(即将调用 LLM 前)调用 getSteeringMessages(),队列里积累的所有 steering 消息会被一次性 splice 出来,然后逐条 push 进 context.messages,格式化为标准 { role: “user”, content: [...], timestamp } 消息。队列清空后,同一条消息不会被重复注入。
Steering 会不会打断进行中的 tool batch? 不会。 源码注释写得很明确:steering 消息在 “current assistant turn finishes executing its tool calls” 之后才投递,也就是说,如果模型刚返回 3 个并行 tool call,这 3 个工具会全部执行完毕、toolResult 全部 append 到 context 后,下一轮 LLM 调用前才会注入 steering。这是协作式中断,不是抢占式杀进程。用户按 Enter 发出的“等等别改那个文件”,会排队等到当前 tool batch 安全落地,既不打断文件写入的原子性,又不丢失已完成的工具结果。
队列模式:steeringMode / followUpMode 支持 “one-at-a-time”(默认,每轮只投递一条)和 “all”(一次性投递全部)。AgentSession 层还维护 _steeringMessages: string[] 用于 TUI 显示排队状态,与 Agent 内核队列通过 steer() / followUp() API 同步,如图 3-1 所示。
3.2.3 事件驱动下的状态还原
注意看,在上面的 runLoop 中,没有直接操作界面的代码。引擎只做一件事:不断地 emit(“message_end”)、emit(“tool_execution_start”)。
外层的 Agent 和 AgentSession 就像是一个监听者,它们将这些离散的事件汇总、记录到全局的 transcript(对话记录)中,并最终通知 TUI 或者 RPC 客户端去刷新渲染。这种高度解耦的设计,是构建复杂智能体软件系统的基石。
原理深挖:Event-Driven 事件总线与订阅模型
Pi 的事件系统分两层,不要混淆:
L1 — Agent 核心事件(packages/agent/src/types.ts):由 agentLoop 内部的 emit 回调广播,类型包括 agent_start、turn_start、message_start、message_update(流式 Token 增量)、message_end、tool_execution_start / tool_execution_update / tool_execution_end、turn_end、agent_end。Agent.subscribe(listener) 注册监听,返回 unsubscribe 函数。这些事件是同步 emit、异步 handler,循环不会 await 订阅者的处理完成。
L2 — Extension 扩展事件(packages/coding-agent/src/core/extensions/types.ts):由 ExtensionRunner 管理,在 Agent 事件之上叠加了 before_agent_start、session_before_compact、session_before_tree、tool_call(可 block/mutate)、tool_result 等 30+ 种生命周期钩子。Extension 事件支持 返回值修改行为(如 tool_call 返回 { block: true } 拦截执行),而 Agent 核心事件是纯通知。
事件总线实现:Extension 层使用 createEventBus()(packages/coding-agent/src/core/event-bus.ts),底层是 Node.js 的 EventEmitter,但封装了 safeHandler,handler 抛异常不会拖垮 循环,只 console.error。每个 channel 对应一种 ExtensionEvent 的 type 字段,payload 是强类型的 discriminated union (如 { type: “tool_call”, toolName: “bash”, input: {...} })。
Schema 设计哲学:所有事件都携带 type 字面量字段作为 discriminant,TypeScript 编译器可在 switch (event.type) 中自动窄化。Agent 核心事件与 Extension 事件命名空间隔离,前者驱动 UI 渲染和 JSONL 持久化,后者驱动插件逻辑和上下文注入,互不污染。
3.3 上下文处理机制
当你的 Agent 运行了成百上千轮,上下文字数超过了 10 万字,该如何处理?简单地切除头部数据会导致逻辑断裂;使用 Claude Code 的 AutoCompact 会将原始对话替换为摘要,丢失细节。
Pi 在 packages/coding-agent/src/core/compaction/ 下给出了一套极具极客精神的解决方案:不删任何数据,只是在状态树上打“压缩补丁”,并在读取时重新投影(Projection)。
3.3.1 触发压缩的边界条件
在 AgentSession 处理完一轮运行后,会进入 _checkCompaction() 判断是否需要“记忆瘦身”:
- 阈值触发(Threshold): 当发现估算的 Token 已经跨越了
contextWindow - reserveTokens(比如预留 1.6 万 Token 缓冲)。此时主动拦截,发起压缩。此时 Agent 还能继续接下来的任务(willRetry = false)。 - 溢出补救(Overflow): 当 LLM API 明确报出上下文超限错误(如
prompt_too_long或 HTTP 413),或者检测到大模型输出 Token 为 0 且被强行截断(静默溢出)时。此时必须先压缩历史,然后拿着压缩后的新上下文,自动重试刚刚失败的那个请求(willRetry = true)。这对用户来说是完全无感的。
_checkCompaction 的边界条件
_checkCompaction() 在 AgentSession 每轮 message_end 后触发,两条路径的触发条件、用户感知、日志行为截然不同,如表 3-2 所示。
表 3-2 压缩触发路径对照
| 维度 | 阈值触发 | 溢出补救 |
|---|---|---|
| 触发条件 | contextTokens > contextWindow - reserveTokens(默认 reserve 16384) | API 返回 context overflow 错误,或 usage 超过窗口 |
willRetry | false | 成功响应溢出 → false;错误响应溢出 → true |
| 用户感知 | TUI 弹出 compaction 进度,完成后等待用户继续 | 自动 compact → 移除错误 assistant 消息 → 静默重发上一轮请求 |
| 日志事件 | compaction_start { reason: “threshold” } → compaction_end { willRetry: false } | compaction_start { reason: “overflow” } → compaction_end { willRetry: true } |
| 防重入 | 检查 compaction 时间戳,防止刚 compact 完又被旧 usage 触发 | _overflowRecoveryAttempted 标志位,最多 1 次 compact-and-retry |
在实际使用中,Overflow 路径的“静默重试”与 Threshold 路径的“等用户继续”对用户感知的影响,远高于 reserveTokens 数值本身的微调,前者掩盖了上下文危机,后者把主动权交还给人。
Overflow 重试的“一次限次”是关键安全阀:如果 compact 后上下文仍然超限(比如单条 tool result 就超过窗口),第二次 overflow 不会无限循环,而是 emit compaction_end 并附带 errorMessage: “Context overflow recovery failed after one compact-and-retry attempt”,让用户手动处理。Threshold 路径则永远不会 auto-retry,因为此时 assistant 回答已成功完成,agent.continue() 无法从 assistant 消息续接,强行重试语义不对。
3.3.2 树状追加与物化视图
这是 Pi 最反直觉、也是最安全的设计。在 _runAutoCompaction() 的流程中:
typescript
// 伪代码:Pi 的无损压缩逻辑
async function _runAutoCompaction() {
  // 1. 寻找切割点
  const preparation = prepareCompaction(pathEntries);

  // 2. 调用模型生成摘要
  const summary = await compact(preparation, model);

  // 3. 【核心】并没有去修改以前的 messages 数组!
  // 而是向存储引擎(JSONL)追加一条特殊记录
  sessionManager.appendCompaction(summary, tokensBefore, details);

  // 4. 重建当前视图
  agent.state.messages = sessionManager.buildSessionContext().messages;
}
为何不能简单地一次压缩
Compaction 被刻意拆成 Prepare (纯计算) 和 Compact (调 LLM) 两个阶段,中间留出了 Extension 拦截面:
Prepare 阶段输入:当前分支的 pathEntries[](从 leaf 回溯到 root 的完整路径)+ CompactionSettings(reserveTokens: 16384, keepRecentTokens: 20000)。输出 CompactionPreparation:
messagesToSummarize[]:将被折叠丢弃的消息turnPrefixMessages[]:如果切割点落在一轮对话中间,前缀部分单独摘要firstKeptEntryId:切割后保留的第一条 entry 的 UUIDpreviousSummary:上一次 compaction 的摘要(用于增量更新而不是重写)fileOps:从 tool call 中提取的{ read, written, edited }文件集合
摘要 Prompt 设计:System prompt 固定为 “You are a context summarization assistant... Do NOT continue the conversation. ONLY output the structured summary.”,防止小模型把摘要任务当成对话续写。User prompt 要求按 Goal / Constraints / Progress / Key Decisions / Next Steps / Critical Context 六段式 Markdown 输出,并保留精确的文件路径、函数名、错误信息。如果有 previousSummary,切换为 UPDATE 模式,“PRESERVE all existing information, ADD new progress”,实现增量压缩而不是每次从零摘要。
Compact 阶段:把 serializeConversation(messagesToSummarize) 的纯文本+ 结构化 prompt 发给 compaction 模型(通常与主模型相同),返回 { summary, firstKeptEntryId, tokensBefore }。Extension 可通过 session_before_compact 事件完全替换这一步的输出。
为什么说它是“物化视图”?
在底层的 JSONL 文件里,那几万字啰嗦的历史记录全都在。 appendCompaction 只是在树里追加了一个特殊节点:“从这条往前的冗长历史,都可以用 [总结了刚才的调试] 来代替”。 当 buildSessionContext() 读取树来拼接发给大模型的消息时,只要它撞见了 Compaction 节点,它就会跳过前面的所有细枝末节,直接把这条总结作为替代品抛出。历史永远不会被销毁,只会在需要发给 LLM 计费的时候被折叠。
原理深挖:buildSessionContext() 的树遍历投影算法
buildSessionContext(entries, leafId?) 是一个纯函数投影器,输入 append-only 的 entry 数组 + 当前 leaf 指针,输出 { messages, thinkingLevel, model }。算法分四步:
- 定位 leaf:若
leafId === null(navigate 到首条消息之前),返回空 messages;若未指定,取数组最后一条 entry。 - 回溯路径:从 leaf 沿
parentId链走到 root,path.reverse()得到 root→leaf 的有序路径。路径上所有 entry 类型都会被遍历(message、compaction、model_change、thinking_level_change、branch_summary、custom_message 等),但不一定都变成 LLM message。 - Compaction 折叠规则(路径上存在 compaction entry 时):
- 先 emit 一条
compactionSummary消息(摘要文本) - 从
firstKeptEntryId到 compaction 节点之间的 entry → 保留 - compaction 节点之后的所有 entry → 保留
- compaction 节点之前、且在
firstKeptEntryId之前的 entry → 跳过(折叠进摘要)
- 无 Compaction 时:路径上所有
message、custom_message、branch_summaryentry 按序 append。
节点类型映射:message → 原样;custom_message → { role: “custom”, customType, content };branch_summary → { role: “branchSummary”, summary };compaction → { role: “compactionSummary”, summary, tokensBefore }。label、session_info、model_change 等元数据 entry 不参与 LLM 上下文,只影响 settings 提取(thinkingLevel、model)。
3.3.3 安全切割点算法
如果你刚好在一次“调用工具 -> 返回错误 -> 纠正代码”的逻辑闭环中间砍了一刀做摘要,大模型的逻辑链就断了。 Pi 在 findCutPoint() 中实现了一套逆向寻找安全缝隙的算法。
它从最新的消息开始往回找,累加 Token 数量。当触及 keepRecentTokens 的底线时,它不会立刻切断,而是继续往回找,直到遇到明确的对话边界(比如用户的全新提问、或者 Agent 刚说出的一句自然语言)。绝不在 toolResult (工具返回结果) 前后下刀。 这种基于逻辑完整性的安全切割,保证了压缩后的大模型不会“产生混乱”。
findCutPoint 的工程代价
Token 估算方法:优先使用最后一条 assistant 消息的 usage.totalTokens(API 返回的精确值);其后的消息用 estimateTokens() 启发式估算,文本按 ceil(chars / 4),tool result 按 content 长度,image 按固定值。这种 “精确锚点 + 尾部估算” 混合策略避免了全量 re-tokenize 的开销。
keepRecentTokens 默认值:20000 (DEFAULT_COMPACTION_SETTINGS)。算法从最新 entry 向前累加,当 accumulatedTokens >= keepRecentTokens 时,向前搜索最近的合法切割点。
边界类型枚举(findValidCutPoints):允许切割的 entry 类型,user、assistant、bashExecution、custom、branchSummary、compactionSummary、branch_summary、custom_message。明确禁止在 toolResult 处下刀。
Split Turn 处理:如果切割点落在一轮中间(assistant 消息处),标记 isSplitTurn: true,记录 turnStartIndex(该轮 user 消息的位置)。前缀部分生成单独的 TURN_PREFIX_SUMMARIZATION_PROMPT 摘要,后缀保留原文,一轮对话被拦腰斩断时,两半各自摘要,逻辑链不完全丢失。
Fallback:若 cutPoints.length === 0(极端情况:路径上全是 tool result),返回 { firstKeptEntryIndex: startIndex },保留全部,宁可不 compact 也不破坏结构。
3.3.4 插件对上下文的拦截
Pi 还在上下文拼接的最后一公里留了一个扩展钩子:transformContext。 由于 Agent 可以挂载第三方插件,在 streamAssistantResponse() 把数据正式扔给网络之前,插件有权通过 emitContext(messages) 拦截整个消息数组,塞入特定格式的 custom 角色内容,或者临时屏蔽某段历史。这种将上下文拼接权下放给微内核的设计,为定制各种专属行业的 Agent 留下了极大空间。
原理深挖:transformContext / emitContext 扩展钩子的调用顺序
上下文从 JSONL 树到 LLM API 的完整流水线有 四道关卡,顺序不可乱;前三道每轮必经,第四道仅在新 prompt 首轮触发:
buildSessionContext()(Session 层):树 →AgentMessage[],处理 compaction/branch 折叠。transformContext(messages, signal)(Agent 层钩子):Extension 或 SDK 用户注册的纯函数,可任意增删改 messages 数组。在streamAssistantResponse()内部、convertToLlm()之前调用。convertToLlm(messages)(Agent 层):把AgentMessage[](含custom、branchSummary、compactionSummary等内部角色)转换为 LLM API 兼容的Message[](通常 filter 为user | assistant | toolResult,custom 角色映射为带标记的 user 消息或 system 注入)。before_agent_startExtension 事件(仅新 prompt 时):在 user message append 之前,Extension 可返回{ messages: [{ customType, content, display }] }注入额外上下文,以及{ systemPrompt }覆盖系统提示词。
Custom role 如何进 LLM API? Pi 内部用 role: “custom” + customType 字段区分扩展消息,不直接发给 LLM。convertToLlm() 负责翻译,例如 { customType: “context”, content: “项目使用 pnpm” } 可能被渲染为 [Context: 项目使用 pnpm] 前缀的 user 消息,或注入 系统提示词 尾部。具体映射由 convertToLlm 实现决定,Extension 只管生成 custom 消息,不管 wire format。
插件冲突处理:transformContext 是单一函数(后注册覆盖先注册),不存在链式 pipeline,如果多个 Extension 都需要改 context,应在 Extension 层自行编排。Extension 事件(before_agent_start、tool_call)则按注册顺序串行 emit,后到的 handler 能看到前一个 handler 的 mutation (如 tool_call 的 event.input 就地修改),但不做自动 merge,冲突由 Extension 作者自行协调。
3.4 工具执行与并发控制
让大模型并行调用工具能极大地缩减响应时间,但当模型决定“同时修改文件 A,读取文件 B,又对文件 A 执行一个 sed 命令”时,竞争条件会导致本地代码被改得面目全非。
Pi 架构将工具批调度统一收归到 executeToolCalls 函数——它是每轮循环中工具阶段的单一入口,负责决定串行还是并行、分配并发组、汇总结果。通过分析 packages/coding-agent/src/core/tools/ 下的源码,我们来看它如何像构建操作系统一样去构建 Agent 的工具系统。
3.4.1 并发组的生命周期管理
在 executeToolCalls 中,系统会判断当前的这一批工具调用是走 Sequential(串行)还是 Parallel(并行)。
Sequential vs Parallel 的判定逻辑
判定逻辑在 executeToolCalls() 入口处,任一条件命中即走串行:
- 全局配置:
config.toolExecution === “sequential”,SDK/RPC 用户显式要求串行。 - 工具级声明:当前 batch 中任何一个 tool 的
executionMode === “sequential”,比如某些有副作用链的工具(写后读)在 Schema 注册时就标记了串行。 - 默认:以上都不满足 → Parallel。
注意:判定粒度是 per batch (一次 assistant 返回的所有 tool call),不是 per tool。Parallel 模式下,Prepare (Schema 校验 + beforeToolCall hook)仍然串行执行,先过安检,再放行并发。这避免了并发 race 导致的重复 block 检查。
如果在并发模式下:
- 预处理(Prepare)是串行的:依次校验 JSON Schema,并触发 beforeToolCall 钩子(防止越权)。
- 执行是真并行的:所有放行的工具并发启动。
- 退出的共识机制:每一批并发的工行完,都会返回一个状态
terminate。只有当所有的工具都同意结束循环(terminate: true)时,内循环才会被打破。如果任何一个工具说“我还得继续查”,整个引擎的齿轮就会继续滚动。
容易被忽视的一点:terminate 共识机制
shouldTerminateToolBatch() 的逻辑较为严格:
typescript
return finalizedCalls.length > 0
  && finalizedCalls.every(r => r.result.terminate === true);
全部工具都声明 terminate: true,内循环才停。 任何一个工具返回 terminate: false(或 undefined,默认为 false),循环就会带着 tool results 再次请求 LLM。
典型 terminate: true 场景:
ask_user/ HITL 工具:需要人类输入才能继续,循环应暂停等待下一条 user message (通过 follow-up 队列注入)。- Subagent 工具:子智能体已完成任务并返回最终结果,父 循环 无需再调 LLM 做二次总结。
- Explicit “done” 工具:某些 Extension 注册的
task_complete工具,显式标记任务结束。
与 follow-up 队列的交互:terminate: true 只终止内循环,不终止外循环。内循环结束后,外循环仍会检查 followUpQueue,如果有排队的追问,它们会被提升为 steering messages,开启新一轮内循环。这意味着:工具层说“我干完了” ≠ Agent 整体收工,用户提前排队的 follow-up 依然会被执行。
3.4.2 全局变动队列与协程锁
为了解决多个并行工具同时编辑同一个文件带来的冲突,Pi 设计了一个精细的纯内存级“文件互斥锁”:
typescript
// 伪代码:极其轻量且优雅的文件级写入串行化
const fileMutationQueues = new Map<string, Promise<void>>();

export async function withFileMutationQueue<T>(filePath: string, fn: () => Promise<T>): Promise<T> {
  const key = getRealPath(filePath);

  // 拿到上一个锁的 Promise,如果没有就是个立即解决的 Promise
  const currentQueue = fileMutationQueues.get(key) ?? Promise.resolve();

  let resolveNext: () => void;
  const nextQueue = new Promise<void>(res => { resolveNext = res; });
  fileMutationQueues.set(key, nextQueue);

  // 死等前面的任务干完
  await currentQueue;

  try {
    return await fn(); // 执行真正的读写修改
  } finally {
    resolveNext!(); // 放行后续等待的任务
  }
}
有了这段代码,当模型密集地同时抛出 3 个针对同一文件的 edit 调用时,底层会将它们排队并依次执行,从而避免这一调度边界内的并发写入冲突。它不能替代跨进程文件锁,也不能防止其他进程同时修改目标文件。
原理深挖:file-mutation-queue 与 getRealPath 的归一化
Symlink 归一化:getMutationQueueKey() 先 resolve() 相对路径,再 realpath() 解析符号链接,/project/src 和 /project/link-to-src(symlink)会映射到同一个队列 key,防止两个并行 edit 从不同路径绕过锁。
读操作是否排队? 不排队。 withFileMutationQueue 只在 write / edit 工具内部调用。read 工具直接读文件,不经过队列,读无状态,不需要互斥。这避免了“读等待写、写等待读”的经典死锁模式。
死锁/饥饿防护:
- 队列是 Promise 链(
currentQueue → nextQueue),不是 mutex spinlock,等待者挂起在 Promise 上,不占用 CPU。 registrationQueue:全局注册队列保证多个并发withFileMutationQueue调用对 Map 的注册操作本身也是串行的,避免两个 Promise 同时set同一个 key 导致链断裂。finally { releaseNext() }:即使fn()抛异常,后续等待者也会被放行,不会永久阻塞。- 队列 entry 在完成后自动删除(
fileMutationQueues.delete(key)),不会内存泄漏。
3.4.3 命令输出的流控机制
当大模型意外执行了 find / -name “*.js” 这种命令时,几百兆的终端输出会迅速淹没所有的上下文。 在 output-accumulator.ts 和 truncate.ts 中,Pi 构建了一个带溢出保护的“三级水库”。
- 滚动缓冲:对于流式回传的 Bash 出,系统在内存里只保留最后那一点活水(通常是
maxRollingBytes = 2 × maxBytes,约 100KB),前面的内容直接在内存中抛弃,防止 Node.js 进程 OOM。 - 截断反馈:它会统计究竟抛弃了多少行少字节,然后通过
truncateTail(),只把最后 2000 行喂给大模型,并在末尾贴心地加上一句:[...截断了 5231 行...],让模型有感知。 - 落盘追溯(Spill-to-Temp-File):那被丢弃的几千行真的消失了吗?没有。当系统发现发生了溢出,它会把完整的日志默默落盘写入到 /tmp/pi-output-xxxx.log 临时文件中,确保人类如果想审计,依旧有迹可循。
原理深挖:三级输出截断水库的阈值关系
三级水库不是三个独立模块,而是 OutputAccumulator 内部的三个阶段,阈值有明确的包含关系,如表 3-3 所示。
表 3-3 工具输出三级水库
| 级别 | 触发条件 | 行为 |
|---|---|---|
| L1 滚动缓冲 | 流式 append 过程中 tailBytes > maxRollingBytes | 内存 tail 区滑窗丢弃旧字节,不影响最终 snapshot |
| L2 截断反馈 | snapshot() 时 totalLines > maxLines(2000) 或 totalBytes > maxBytes(50KB) | truncateTail() 只保留尾部 N 行/字节,追加 [...truncated N lines...] 元数据 |
| L3 落盘追溯 | L2 触发了 truncation | 完整 raw output 写入 /tmp/pi-output-{random}.log,路径附在 tool result metadata 里 |
maxRollingBytes = 2 × maxBytes 的原理:流式 Bash 输出是单向追加、不可回溯的。如果 rolling buffer 和最终截断阈值相同(都是 50KB),在到达 50KB 之前内存就要保留全部数据,OOM 风险。设为 2 倍(100KB rolling / 50KB 最终),意味着内存里最多保留约 2 倍最终限额的数据,给 UTF-8 多字节字符边界和行边界对齐留出缓冲,同时保证在触发落盘之前内存不会无限增长。
流式 Bash incremental 截断:OutputAccumulator.append(data: Buffer) 使用 TextDecoder({ stream: true }) 增量解码,chunk 可能切在多字节 UTF-8 字符中间,trimTail() 会向前扫描到合法字符边界((byte & 0xc0) !== 0x80),避免截出乱码。getSnapshotText() 如果 tail 不是从行首开始,会丢弃第一个不完整行,宁可少显示半行,也不喂给 LLM 一个断句。
总之,Pi 的工具执行模块在并行自主权与工程约束之间做了折中:文件队列锁防 torn write,输出截断阀防 OOM。然而并行 batch 仍可能在语义层面制造竞态,两个 edit 针对同一函数的不同段落,锁能保文件完整性,保不了逻辑一致性。
3.5 树状记忆设计
绝大多数大语言模型客户端和 Agent 框架,不管底层怎么封装,记忆结构仍是一个一维的 messages 数组。
这种结构有一个致命弱点:无法吃后悔药。 如果 Agent 在过去的 5 步推理中选错了方案,导致后面连续报错。由于上下文已经被错误的代码和逻辑污染,即便你强行要求它“重选方案”,它的思路依然会被那些错乱的尝试影响(所谓的“认知锚定”效应)。
认知锚定与路径依赖
当上下文中保留了大量失败尝试的完整日志时,模型会将这些错误路径当作隐式锚点,即使用户明确要求换方向,注意力仍被旧方案占据,新路径的推理空间被压缩。这与 Lost in the Middle 的机制不同:后者是检索精度下降,前者是推理方向被污染。
Pi 的 branch summarization (3.5.3 节)针对此问题设计:通过 navigateTree 切换分支,物理隔离错误路径的完整日志,同时用结构化摘要保留经验教训。相比 Claude Code 沿时间轴压缩的 compact,branch summary 是沿决策维度的去污染,粒度更细。
Pi 架构在 session-manager.ts 中打破了这个桎梏,实现了一个关键设计:把聊天记录做成 Git 级记忆树——每条消息以 parentId 链接成追加树而非线性数组,可从任意节点回溯到根,支持分支切换与“撤销最近几步操作”。
3.5.1 不可变的事件溯源
在 Pi 中,你的会话并不是一个数组,而是一个 .jsonl 文件。每一次用户提问、工具调用、大模型回复,都是一条追加的日志。
json
// JSONL 中的单条记录样例
{"type":"message", "id":"msg_1", "parentId":"root", "timestamp":...}
{"type":"toolCall", "id":"tool_2", "parentId":"msg_1", "timestamp":...}
最重要的是那个 parentId。 这意味着,当前的会话上下文,实际上是:从某个特定的叶子节点,顺着 parentId 顺藤摸瓜回溯到根节点所串起的一条路径。
原理深挖:Append-Only Event Sourcing 模式
Pi 的 JSONL 存储是 事件溯源 的经典实现,与 CRUD 有本质区别,如表 3-4 所示。
表 3-4 CRUD 与事件溯源对照
| 维度 | CRUD | Event Sourcing (Pi) |
|---|---|---|
| 存储单元 | 当前状态快照 | 不可变事件 log |
| 修改方式 | UPDATE / DELETE | 只 APPEND 新 event |
| 读取方式 | SELECT 当前行 | Projection:从 event log 推导当前视图 |
| 历史 | 覆盖/丢失 | 完整保留,可 replay |
| 撤销 | 需要 soft delete | 移动 leaf 指针即可 |
Event log → Projection → Replay 三板斧:
- Event log:
.jsonl文件,每行一个 event (message / toolCall / compaction / branch_summary / model_change...)。 - Projection:
buildSessionContext()是纯投影函数,输入 event log + leaf pointer,输出 LLM 可用的 messages 数组。Compaction 和 branch summary 是投影规则(折叠/摘要),不是 DELETE。 - Replay:
SessionManager.loadEntriesFromFile()逐行 parse JSONL 重建内存索引(byIdMap +leafId),crash 后重启即从 log 完整恢复,无需 checkpoint 文件。
对比 CRUD 的 messages 数组:UPDATE 一条 message 会丢失旧版本;DELETE 不可恢复。Event Sourcing 的代价是 log 会增长,Pi 用 Compaction 投影规则在不删 log 的前提下控制 LLM 看到的“视图”大小。但这并非没有代价:JSONL 文件随会话拉长而膨胀,全量 replay 的启动时间在万条 entry 量级上开始可感知。
3.5.2 分支切换与历史回溯
由于有了这棵树,当 Agent 思路走偏时,用户可以在界面上操作,调用 navigateTree(targetId) 接口。
它的逻辑如下:
- 重置 HEAD 指针:直接把游标指向 5 分钟前、出错之前的那句话对应的
targetId。 - 重建上下文:重新
buildSessionContext()。对大模型来说,后面的那几十条错误对话不再进入上下文,世界回到了刚开始做决策的那个路口。 - 开启新分支:当对话继续时,新的消息会作为
targetId的子节点被追加。这就好像在 Git 里,你在某个旧 Commit 处checkout -b new-branch,而原本那条错误的线路,变成了一个永远被封存的废弃分支。
navigateTree 背后的取舍
AgentSession.navigateTree(targetId, { summarize?, label? }) 是用户-facing 的“时光机” API,内部流程:
- 收集废弃分支:
collectEntriesForBranchSummary(session, oldLeafId, targetId)从 oldLeaf 回溯到两路径的最近公共祖先(LCA),收集将被放弃的所有 entry。 - Extension 拦截:emit
session_before_tree事件,Extension 可 cancel / 替换摘要 / 修改 label。 - 可选摘要:调小模型生成 branch summary (见 3.5.3)。
- 移动 HEAD:
sessionManager.branch(targetId)或branchWithSummary(targetId, summary),只改内存中的leafId指针,不修改任何已有 entry。 - 重建 Agent 状态:
agent.state.messages = buildSessionContext().messages,Agent 的 in-memory context 与新的 HEAD 同步。 - 持久化:下一次
appendMessage时,新 entry 的parentId = targetId,JSONL 追加新行,旧分支 entry 原封不动留在文件中。
并发编辑冲突:Pi 是单进程 CLI,不存在 Git 式 merge conflict。但如果用户在 Agent 运行中 navigateTree,_branchSummaryAbortController 会 abort 正在进行的摘要生成,导航优先于后台摘要。运行中的 Agent Loop 不会被 navigate 打断(需要等当前 turn 结束或用户 abort),但 navigate 后下一次 prompt 会使用新分支的 context。
HEAD 持久化:leafId 不单独存盘,它隐含在最后一条 append 的 entry 的 parentId 链中。加载 JSONL 时,默认 leaf = 最后一条 entry。如果 crash 发生在 append 前,leaf 仍指向上一个稳定位置,最多丢一条未落盘的消息,不会 corrupt 整棵树。
3.5.3 分支废弃与记忆回收
在传统的撤销操作中,我们虽然消除了污染,但也丧失了试错的经验。比如“原来那个包有依赖冲突,不能用”。
Pi 架构在此处的处理是一个设计亮点: 在 collectEntriesForBranchSummary 中,当系统检测到你从 oldLeafId 切回了旧的 targetId。 它会顺着废弃的那条分支向上爬,收集那些错误的尝试日志。然后用一个后台小模型,把这些失败总结成一段话(比如:“在上一条废弃分支中,证明了使用 Webpack 打包会产生循环依赖报错”)。
最后,通过 branchWithSummary() 接口,把这段经验作为一个名为 BranchSummaryEntry 的特殊节点,直接挂载到你新切回的那条分支的最开头。
此时的大模型:
- 没有被错乱的报错日志挤占上下文窗口。
- 没有被错误的代码带偏注意力。
- 并且获得了一条清晰的“避坑指南”。
原理深挖:branchWithSummary 的收集算法与节点 Schema
收集范围算法(collectEntriesForBranchSummary):
- 计算
oldPath = session.getBranch(oldLeafId)的 id 集合。 - 计算
targetPath = session.getBranch(targetId),从叶到根反向扫描,找到最深的 LCA。 - 从
oldLeafId沿 parentId 回溯到 LCA,收集路径上所有 entry (包括 compaction entry,它们的摘要会被当作上下文纳入 branch summary,而不是停止收集)。 - 反转数组 → 时间正序。
摘要 Prompt:复用 Compaction 的 SUMMARIZATION_SYSTEM_PROMPT + 结构化格式,但侧重点不同,Branch summary 强调 “这条路上踩了什么坑、结论是什么”,而不是 “当前任务进度”。Tool result 同样截断至 2000 字符。Token 预算由 reserveTokens(默认 16384)控制,超出预算时从最早的 entry 开始丢弃(但保留 LCA 之后的所有 entry 不进入摘要)。
BranchSummaryEntry 节点 Schema:
json
{
  "type": "branch_summary",
  "id": "uuid",
  "parentId": "targetId",
  "fromId": "oldLeafId",
  "summary": "在上一条废弃分支中,证明了 Webpack 会产生循环依赖...",
  "details": { "readFiles": [...], "modifiedFiles": [...] },
  "timestamp": "ISO-8601",
  "fromHook": false
}
branchWithSummary(branchFromId, summary, details) 把此 entry 作为 branchFromId 的子节点 append,然后 leafId = entry.id,新对话从摘要节点开始,LLM 看到的第一条消息就是“避坑指南”。
3.5.4 持久化同步策略
如此复杂的树形结构,会不会导致读写变慢? 并不会。因为 AgentSession 监听了核心循环的 message_end 事件。无论是大模型吐出的一句话,还是某个工具的执行结果,一旦落定,立马转化为 JSONL 追加到磁盘。这是一种纯天然的 WAL (Write-Ahead Log),即使你突然拔掉电脑电源,Agent 的记忆树也完好无损,重启后它依旧知道自己所在的那个树杈位置。
原理深挖:WAL 原理与 Pi JSONL 追加的对应
WAL 是数据库的核心持久化策略:先写 log,再改状态。PostgreSQL 的 WAL、MySQL 的 redo log、RocksDB 的 memtable flush,都遵循同一原则,崩溃恢复时,replay log 即可重建一致状态。
Pi 的 JSONL 追加与 WAL 的对应关系,如表 3-5 所示。
表 3-5 JSONL 与预写式日志对应
| WAL 概念 | Pi 实现 |
|---|---|
| Log record | JSONL 中的一行(一个 SessionEntry) |
| Append (顺序写) | sessionManager._appendEntry() → fs.appendFileSync 追加一行 JSON |
| fsync 策略 | Node.js appendFile 默认不 fsync 每条,OS 页缓存批量刷盘。Crash 窗口:最多丢 OS buffer 中的最后几条 entry |
| Checkpoint | 不需要,每次 load 从 log 全量 replay 重建 byId 索引 |
| Crash recovery | 重启 → loadEntriesFromFile() → parse 每行 JSON → 重建树 → leafId = 最后一条 entry.id |
| Projection | buildSessionContext() = WAL replay + 视图规则 |
与数据库 WAL 的差异:Pi 没有 undo log (因为 append-only 不做 UPDATE),“撤销”通过移动 leaf 指针实现,旧 log record 永不删除,这更像 Git object store 而不是传统 DB。如果需要更强 durability,可以在 _appendEntry 后加 fs.fsyncSync(),Pi 选择了性能优先的批量刷盘策略,在 CLI 场景下足够。
总之,Git 级状态树解决的不是并发控制问题,而是决策回溯,让用户在 Agent 走偏时能“checkout”到分岔路口。Branch summary 把废弃分支的经验压缩成避坑指南,而不是简单丢弃。
3.6 插件第一性的微内核设计
§3.5 的记忆树解决了决策回溯的问题;本节讨论另一个架构问题:能力如何插件化扩展。在 Pi 的架构中,连内置的“工具 UI 渲染”和“指令”都是作为扩展(Extensions)存在的。
微内核的 Core / Extension 切分
Pi 的微内核设计不是学术概念,而是代码层面的物理隔离,packages/agent(内核)的源码中没有任何 tool 实现、没有任何 TUI 代码、没有任何 provider 配置,如表 3-6 所示。
表 3-6 内核与扩展职责划分
| 归属 Core (不可移除) | 归属 Extension / Adapter (可替换) |
|---|---|
agentLoop 嵌套状态机 | bash / read / edit / write 工具 |
AgentEvent 类型定义 | TUI 组件(Markdown 渲染、Editor、Spinner) |
| Tool execution 协议 | /command 斜杠指令 |
| Steering / Follow-up 队列机制 | Compaction prompt 定制(session_before_compact) |
convertToLlm / transformContext 端口 | Subagent 子进程扩展 |
| Themes、技能库、Prompt Templates |
内核只做调度,不做决策。 “要不要 block 这个 bash 命令?”,Core 不管,Extension 的 tool_call handler 返回 { block: true }。“用什么 prompt 做 compaction?”,Core 提供 prepareCompaction() 纯函数,Extension 可完全替换 summary。
这种切分的好处:npm install -g @mariozechner/pi-coding-agent 装完就能跑,但你可以不写一行 TypeScript 就通过配置禁用所有内置工具、替换为纯 HTTP API 工具,因为 Core 对 Tool 的定义只是一个 { name, execute, parameters } 接口。
- 事件总线: 核心会话抛出多达 30 种精细的生命周期事件(如
before_agent_start,tool_call,session_before_compact)。
30 种生命周期事件分类大纲(代表性 12 类),如表 3-7 所示。
表 3-7 生命周期事件分类大纲
| 类别 | 事件 | 同步/异步 | 能否改变行为 |
|---|---|---|---|
| Session 生命周期 | session_start, session_before_switch, session_before_fork | 异步 await | 可 可 cancel |
| Agent 循环 | before_agent_start, agent_start, agent_end, turn_start, turn_end | 异步 await | 可 可注入 message/systemPrompt |
| 消息流 | message_start, message_update, message_end | 同步 emit | 否,纯通知 |
| 工具 | tool_call, tool_result, tool_execution_start/end/update | 异步 await | 可 可 block/mutate |
| Compaction | session_before_compact, session_compact | 异步 await | 可 可替换 summary / cancel |
| Tree 导航 | session_before_tree | 异步 await | 可 可 cancel / 替换 branch summary |
| Provider | before_provider_request, after_provider_response | 异步 await | 可 可替换 payload |
| Input | input | 异步 await | 可 可 transform / handled |
| Resources | resources_discover | 异步 await | 否,通知 |
| User Bash | user_bash | 异步 await | 否,通知 |
| Model/Thinking | model_select, thinking_level_select | 同步 emit | 否,通知 |
| Project Trust | project_trust | 异步 await | 可 可决策 |
Dispatch 模型:Extension 事件通过 ExtensionRunner.emit() 串行 await 每个 handler,后一个 handler 能看到前一个的 mutation。Agent 核心事件(L1)则是 fire-and-forget,不阻塞 循环。这是刻意的性能取舍:Extension 需要一致性(barrier 语义),UI 需要低延迟(observational 语义)。在实际使用中,tool_call 与 session_before_compact 的重要性远高于 model_select 等纯通知事件,前者直接决定命令能否执行、摘要能否替换,后者只影响界面展示。
- 进程隔离的子智能体(Subagent): 在
examples/extensions/subagent中,我们看到 Pi 支持通过插件动态拉起新的、完全隔离的子进程 Agent。这种松耦合的架构,使得我们可以无限横向扩展 Agent 的能力(如让它挂载专门读数据库的插件、专门发邮件的插件),而无需修改底层的一行核心 TypeScript 代码。
原理深挖:Subagent 的 IPC 与上下文隔离
Subagent Extension 的实现策略是 Process-per-Agent,而不是 Thread-per-Agent:
- IPC 机制:父 Agent 通过
spawn('pi', ['--mode', 'json', ...])拉起子进程,stdin/stdout JSON Lines 协议通信,父进程写{ “type”: “prompt”, “message”: “...” },子进程 stream{ “type”: “message_update”, ... }事件。不共享内存,不共享AgentContext。 - 上下文隔离:每个 Subagent 有独立的 context window、独立的 JSONL session (或 ephemeral session)、独立的 tool registry。父 Agent 的 10 万 token 历史不会泄漏给子智能体,子智能体只看到父 Agent 通过 prompt 传递的任务描述。
- 生命周期管理:子进程 timeout +
AbortSignal级联取消。Parallel 模式最多 8 个 task、4 并发(MAX_PARALLEL_TASKS/MAX_CONCURRENCY)。子智能体完成后返回{ result, usage, terminate: true },父 循环 的 tool batch 收到 terminate 信号后停止。 - 为什么用进程而不是 Goroutine/Worker Thread? Typcript 单线程 Event Loop 无法做真正的 CPU 隔离;子智能体如果 OOM 或死循环,进程边界保证父 Agent 不受影响,这是微内核“扩展运行在用户态”的 Unix 哲学。
总之,Pi 的分层、双队列与 Git 级记忆树各自回答不同问题,可替换性、中途纠偏、决策回溯。三者能否在同一产品里长期共存,尚无定论;但作为参照,它们至少表明 Agent 框架可以比“一个 while 循环 + messages 数组”复杂得多,而不必复杂到不可维护。下一章将解构第三家标杆,OpenCode 的并发模型;此后,我们便开始用 Go 从零构建自己的 Agent 引擎。